
AI Overview
MiniMax H3 は、1本の動画に2人の人物を生成できますか?
はい。H3 は複数のキャラクターを配置できますが、各人物には明確に区別されるアイデンティティ、位置、動作、および発話役割が必要です。複数の同時動作を含む混雑したプロンプトよりも、1回のインタラクションのみを含む短いシーンの方が信頼性が高いです。
2人のキャラクターがアイデンティティを入れ替えるのを防ぐにはどうすればよいですか?
安定したラベル(例:Subject 1 および Subject 2)を割り当て、それぞれに独自の衣装と画面内位置を与え、継続して保持すべき特徴のみを繰り返し記述します。アイデンティティの正確性が重要である場合は、個別のリファレンス画像を用います。
MiniMax H3 における二人の人物の会話は、どのように記述すべきですか?
話者には S1 や S2 のような安定したIDを割り当て、各行の前に誰が話すかを明示し、会話タグ内には正確な発話内容のみを記述します。聞き手の口は閉じたままにするよう指定します。
二人のキャラクターを含むシーンに最も適した H3 モードはどれですか?
単純な架空のシーンにはテキストモードまたは最初のフレームモードを、1つの制御された遷移が必要な場合は最初と最後のフレームモードを、別々の画像・動き・音声アセットで2人の人物を定義する必要がある場合はフルリファレンスモードを用います。
二人の人物に最適な H3 モードを選択する
最も厳しい制約が入力モードを決定する
MiniMax H3 による二人の人物を含む動画制作ワークフローは、プロンプト作成の前段階から始まります。何を厳密に制御する必要があるかを事前に決定します。両方のキャラクターを自由に創作できる場合は、テキスト→音声→動画(text-to-audio-video)方式で十分です。冒頭の構図、衣装、相対的な位置関係が既に重要である場合は、1枚の最初のフレームが有効です。例えば「ある人物が別の人物にケースを渡す」といった、特定の終了状態が求められる単一のインタラクションには、最初と最後のフレームモードが有用です。
キャラクターAとキャラクターBが異なるアイデンティティ画像から生成される場合、あるいは別途用意した動画からボディの動きを供給する場合、あるいは音声リファレンスが重要な場合などには、フルリファレンスモードがより適しています。MiniMax では最大9枚のリファレンス画像、3本の動画、3つの音声クリップ(合計12ファイル)までサポートされています。ただし、音声リファレンスのみを入力することはできず、必ず画像または動画と併用する必要があります。フレーム制御とフルリファレンスのタスクを1つのリクエストに混在させないでください。
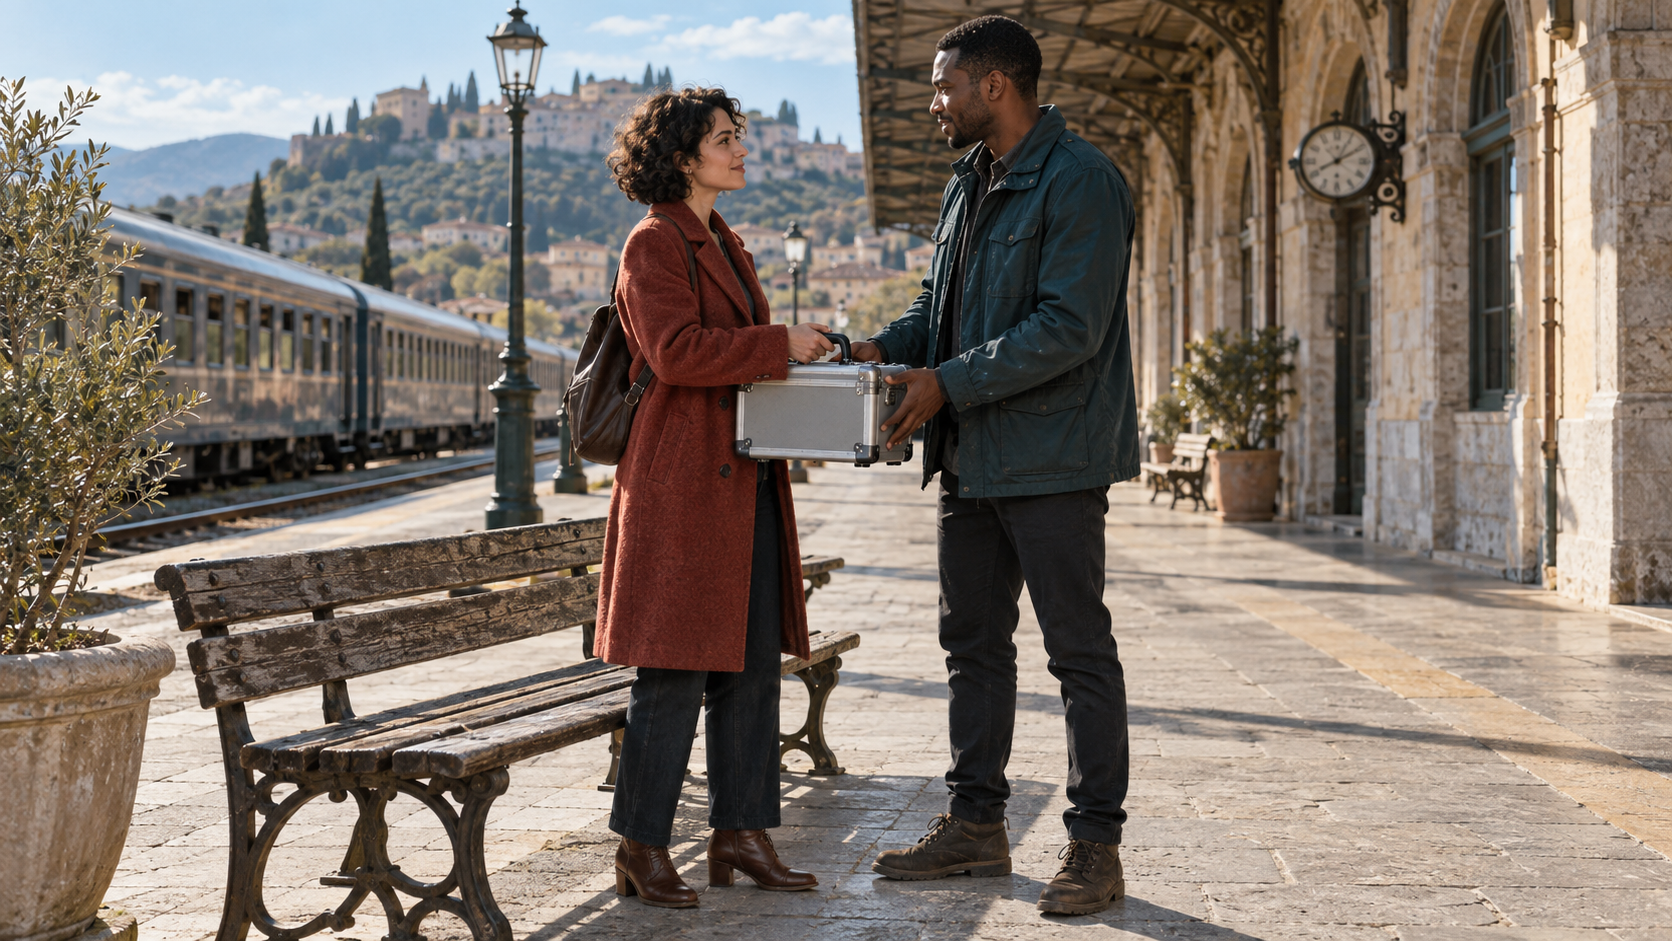
参考生成フレームの例:2種類のコート、分離されたシルエット、固定されたプラットフォーム、そして1つの共用プロップ(ケース)が、視認可能な連続性のアンカーを提供しています。
動画の長さを「アクション予算」として活用してください。H3 は4~15秒の動画をサポートしますが、15秒という上限は、より多くのプロットを詰め込む許可ではありません。二人の人物には1つの因果的ビート(因果関係のある一連の動作)を与えてください:接近→交換→落ち着く、質問→回答→反応、あるいは入場→気づく→退場、といった具合です。シーンに第二のロケーションや別の主要なアクションが必要な場合は、新しいクリップを作成し、再開可能なマルチショットワークフローで接続してください。
Subject 1 と Subject 2 を定義する
コンパクトなアイデンティティおよび配置(ブロッキング)カードを作成する
タイムラインの作成前に、2人のキャラクターを別々の制作記録として記述します。各カードには、視認可能なアイデンティティ、衣装、初期位置、プロップの所有権、動きの制限、話者ID、およびリファレンス元が必要です。違いは一目で分かるようにすべきです。「黒いジャケットを着た二人」のような記述は曖昧さを招きます。
| 制御項目 | Subject 1 | Subject 2 |
|---|---|---|
| アイデンティティ | 女性、30歳前半、短い黒いカールヘア | 男性、30歳半ば、極めて短い刈り上げヘア |
| 衣装 | ラストレッドのウールコート、茶色のブーツ | 深緑のフィールドジャケット、黒いブーツ |
| 初期位置 | 画面左、ベンチのそば | 画面右、駅の壁の近く |
| プロップの状態 | ケースのハンドルを持つ | ケース本体を支える |
| 話者ID | S1 | S2 |
| 動きの制限 | 1歩前進し、ハンドルを離す | ケースを受け取り、1歩後退する |
フルリファレンスモードでは、各アセットが何を提供するかを明確に定義します。サブジェクトラベルは再利用可能な視覚コンテンツを表し、Picture(画像)、Video(動画)、Audio(音声)のラベルはソースメディアまたは構造的リファレンスを識別します。2人の人物とロケーションを含む最初の画像全体を Subject 1 と呼んではいけません。代わりに、「Subject 1 は Picture 1 の女性」「Subject 2 は Picture 2 の男性」と明示し、プラットフォームは再利用が必要な場合にのみ別途定義します。
subject_definitions:
<Subject 1> is the woman from <Picture 1>, preserving her short dark curls, rust-red coat, face, and brown boots.
<Subject 2> is the man from <Picture 2>, preserving his close-cropped hair, deep teal jacket, face, and dark boots.
<Subject 3> is the small silver equipment case shown in <Picture 3>, preserving its size, handle, latches, and brushed-metal finish.
後のショットで、いずれかの顔を異なる方法で再記述しないでください。安定したラベルを用いることで、形容詞とリファレンス間の競合が軽減されます。視点変更にも耐えうるシーンのアンカーが必要な場合は、MiniMax H3 環境の一貫性ガイド を参照してください。このガイドでは、建築物、光の方向、家具、背景オブジェクトを、プロンプトをカタログ化することなく適切に命名する方法を説明しています。
インタラクションおよびプロップの受け渡しを配置(ブロッキング)する
意図だけでなく、状態の変化を記述する
「彼らは自然にケースを交換する」という記述は、最も難しいフレームを隠蔽しています。再生順にオブジェクトの状態を記述します:Subject 1 がハンドルを所有;Subject 2 が両手をケースの下に置く;両者が一時的にケースを支える;Subject 1 が指を広げてハンドルを離す;Subject 2 がケースを持って後退する;両者が落ち着く。これにより、モデルは曖昧な社会的行動ではなく、観察可能な明確な経路を得ることができます。
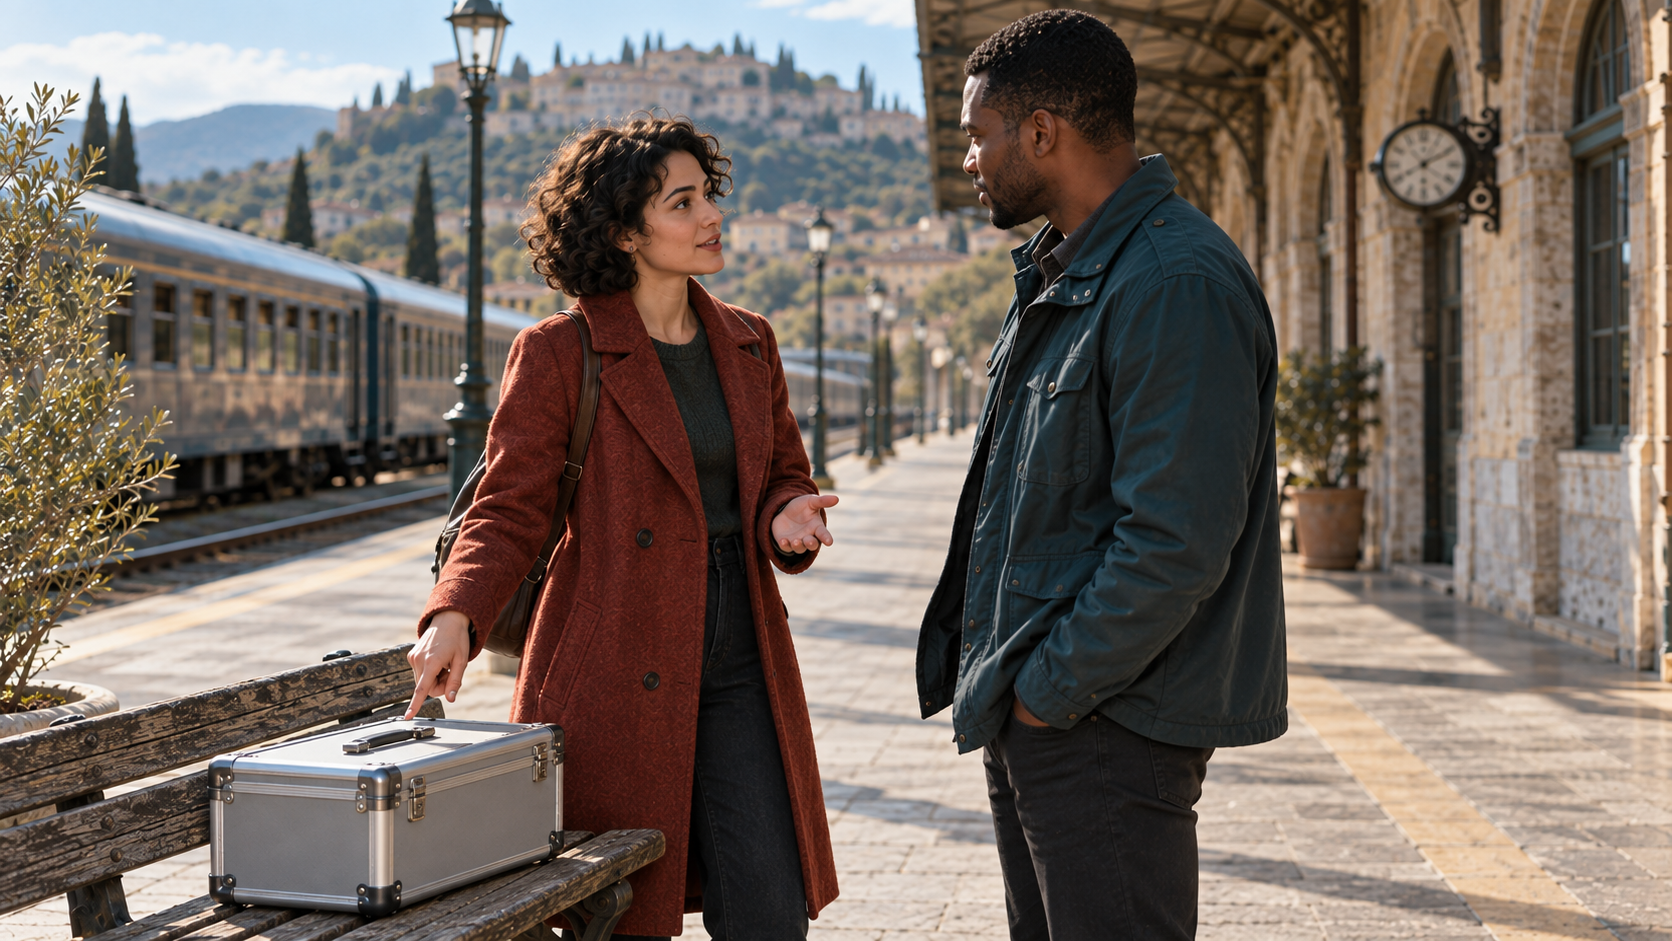
例示的な生成ブロッキング・フレーム:話す側がジェスチャーを担当し、聞く側は明確な視線方向を持ち、ケースは手渡しの直前に安定した位置に置かれている。
空間的表現を一貫して用いる。「画面左」「画面右」はカメラ基準であり、「レール近く」「駅壁近く」は逆角度切り替えにも耐える表現である。カットによって構図の向きが変化する場合、次の動作に入る前に両者の位置関係を再確認する。アーカー、ズーム、パン、ハンドヘルド・シェイクなどを組み合わせるのではなく、1回のカメラ操作(例:ペアへゆっくりと寄っていくプッシュ)のみを用いる。
両者が互いの身体を通り抜けて手を伸ばしたり、接触フェーズがプロンプトで省略されたりすると、手の動きが失敗する。ケースは2人が明確に握れる十分なサイズを持つようにし、どちらの身体も相手の身体を横切らないよう配慮する。また、手渡しの動作には数秒の時間を確保する。明確な終了状態が重要である:誰がケースを所有しているか、各人物の立ち位置、視線の方向、および口の動きの有無を明記すること。
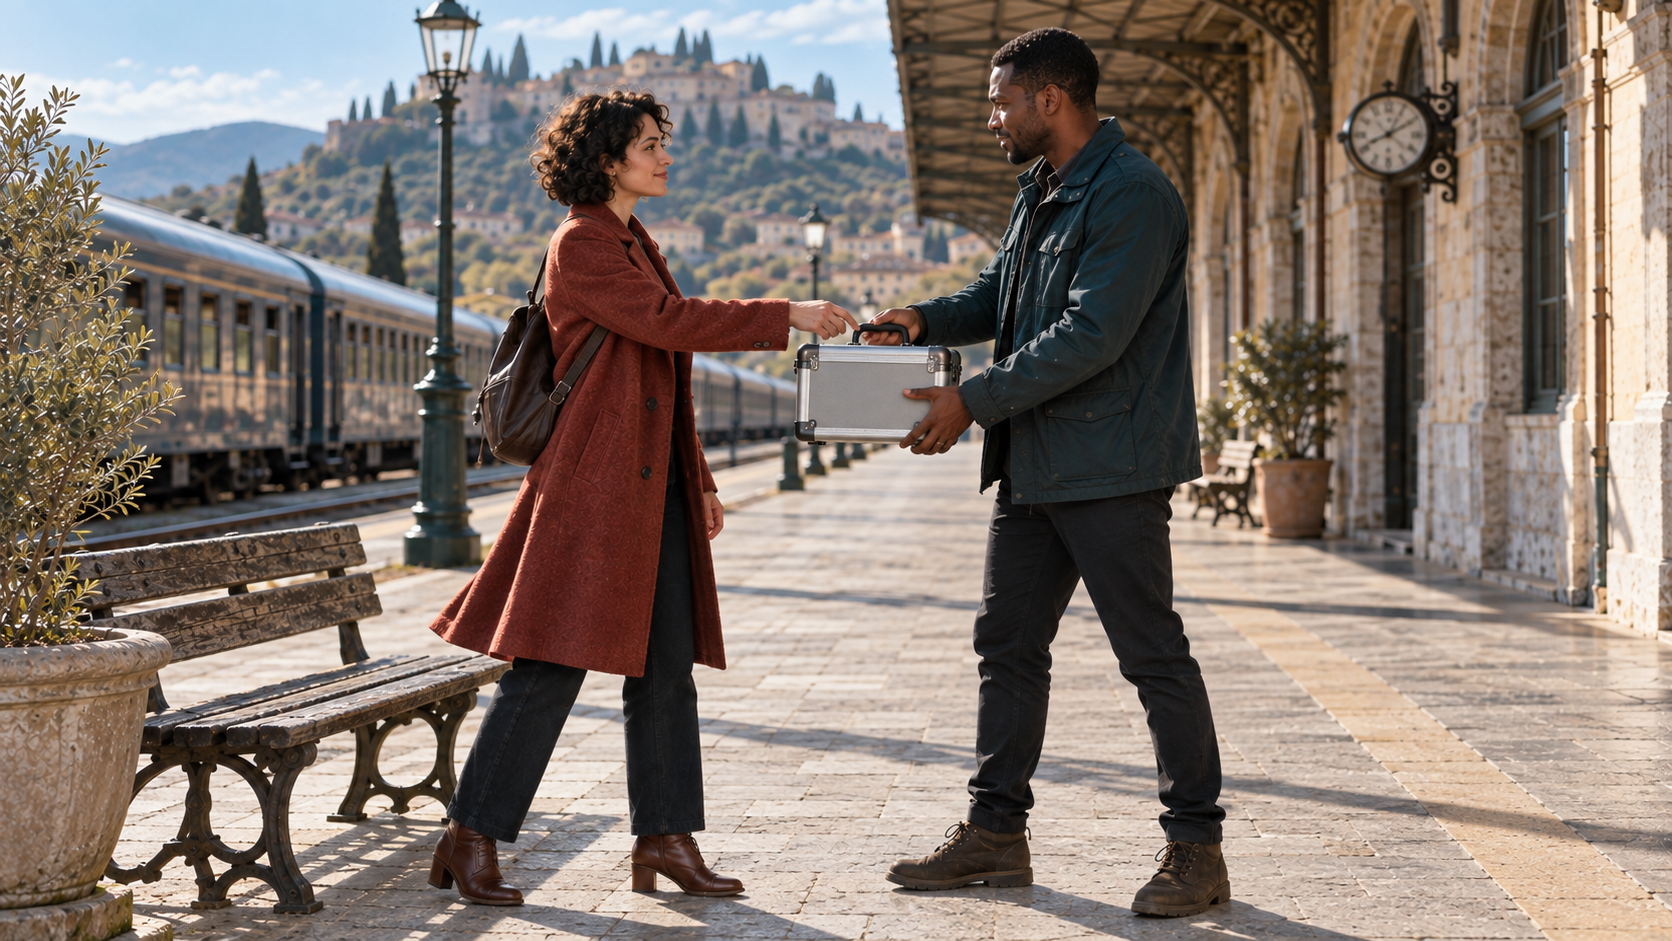
例示的な生成アクション・フレーム:手の分離状態、小道具の幾何学的配置、コートの連続性、および共有接触時の余分な腕の不在を確認する。
2人による対話と音声の制御
全ての台詞と聞き役の反応タイミングを割り当てる
MiniMax の公式ベースガイドでは、安定した話者ID(例:S1、S2)を用いる。識別句、話者ID、発話スタイル、および動作は、対話タグの外側に記述し、対話タグ内には言語タグと正確な発話内容のみを含める。2人が同時に話す場合は、S1,S2 のような複合IDがサポートされるが、重なり合う台詞は、交互に話す場合よりも難易度が高い最初のテストとなる。
錆びた赤色のコートを着た女性(S1)がケースを見つめ、静かに言う: <d>[English] Keep this with you until the next stop.</d> Subject 2 が聞き入り、唇は閉じたまま。
青緑色のジャケットを着た男性(S2)がケースを受け取り、彼女の視線と合い、答える: <d>[English] I understand.</d> Subject 1 が聞き入り、唇は閉じたまま。
可視範囲内のショットに収まる短い台詞を用いる。発話の終了時刻、顎の閉じるタイミング、聞き役の反応タイミングを明記する。プラットフォームの雰囲気音、足音、ケースの留め具のカチッという音、衣類の動きなどは、対話として繰り返さず、全体のサウンドスケープに含める。観客のみが聴く音楽(ノンダイエゲティック・ミュージック)は、専用の「ノンダイエゲティック音楽」フィールドに記述する。画外音(オフスクリーン・ボイスオーバー)の場合は、明示的にその旨を記載し、画面上のキャラクターの口は閉じたままとする。
実際の Seedance 出力であり、MiniMax H3 の結果ではない:より難しい2人対話の評価に先立ち、口の動き、タイミング、ルームトーンの基準として、制御された単一話者クリップを用いる。
複数のクリップにわたって同一の声を再利用する場合、Seedance 声の統一性ガイド を参照し、音色、テンポ、音量、ルームトーン、話者間の分離度についてリスニング検証を行う。
3ショット継続性計画の構築
各カットが固定された状態を継承するよう設計する
多くの2人シーンでは、3つの短いショットで十分である。ショット1では両登場人物、プラットフォーム、および初期のケース所有状態を提示する。ショット2では手渡しの瞬間に近づき、各話者から1行ずつ台詞を配置する。ショット3では新しい小道具所有者を確認し、両キャラクターに静かな反応を付与する。各ショットには開始状態、動作、カメラ挙動、音響、および固定された終了状態を定義する。
ショット1の終了状態は、ショット2の開始状態と一致しなければならない。カット時点でケースがベンチ上にあるなら、次のフレームでそれが突然 Subject 2 の手の中に現れてはならない(可視化可能な拾い上げ動作が必要)。Subject 1 がレール側に立っているなら、カットやカメラの向きがそれを説明しない限り、駅壁側へ向けるような逆転は行わない。MiniMax H3 複数キーフレーム・ワークフロー では、縦型ストーリーボード・コラージュとして扱わず、マスタータイムラインに順序付きフレームを割り当てる方法を解説している。
H3 のベースガイドでは、ショット1後のカット時刻を精密に指定可能である。ただし、それが明確な利点をもたらす場合にのみ用い、インターバルは連続的に保つこと。実用的な12秒計画の例:0–4秒で導入、4–9秒で手渡し、9–12秒で終了保持。最後の2秒では、新たな動作を導入してはならない。
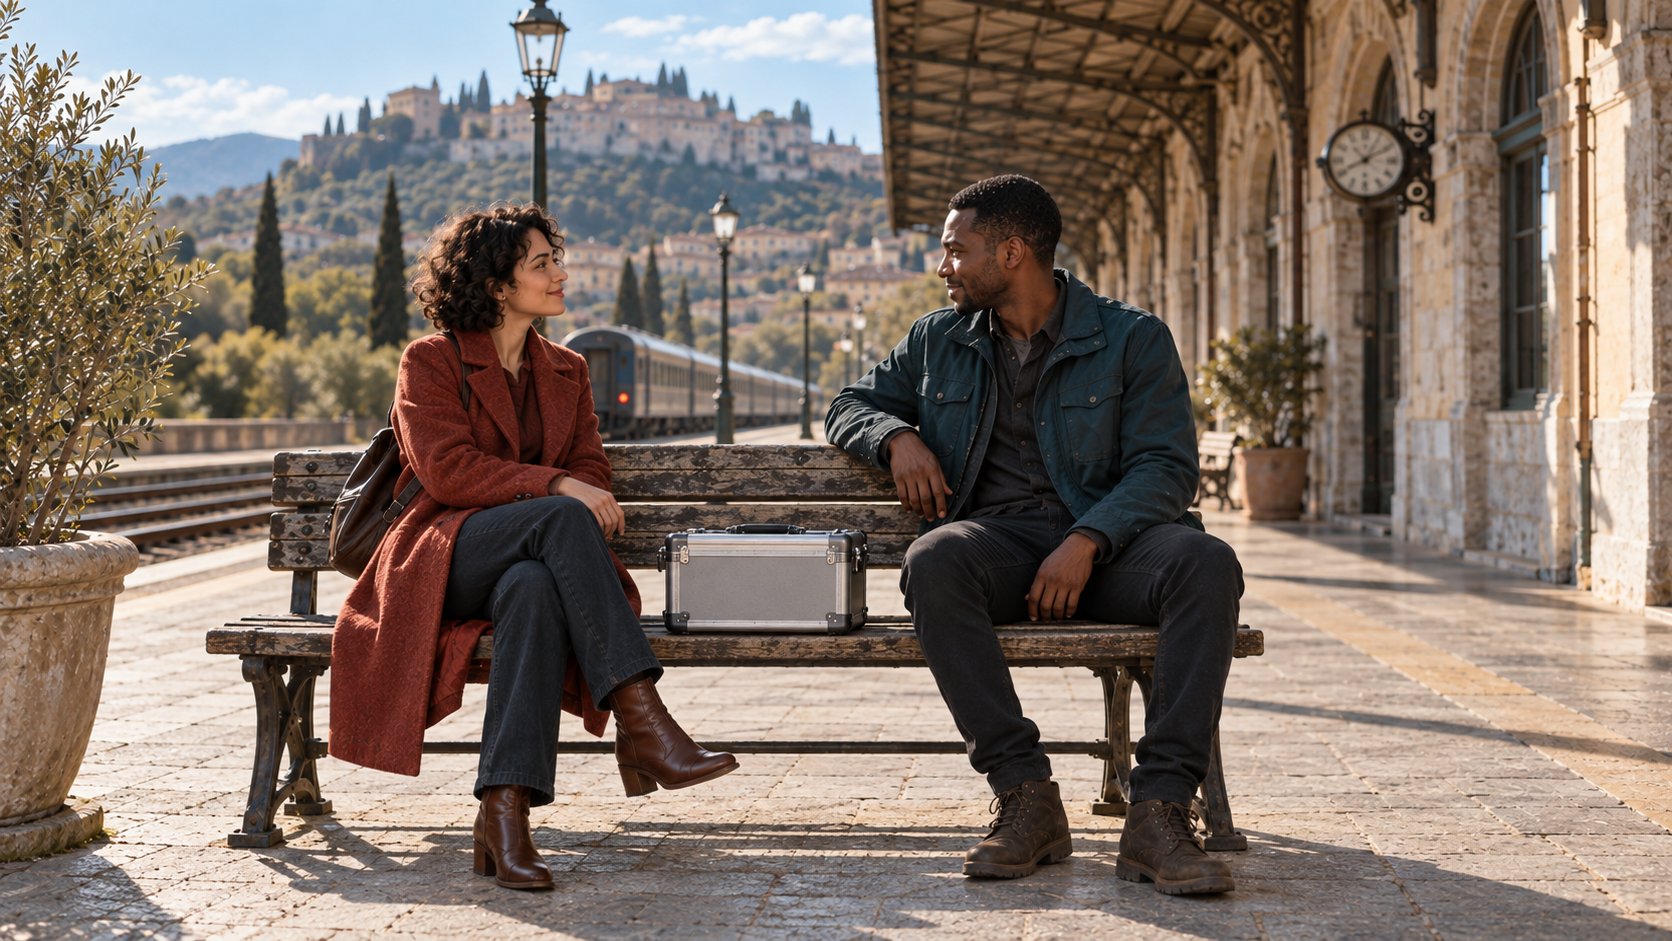
例示的な生成終了フレーム:同一の顔、コート、ベンチ、駅、ケース、照明条件により、継続性のずれを容易に検出可能。
失敗事例のレビューと最小限の再実行
各可視化された失敗に対し、1つのプロンプト変更を対応付ける
通常速度で動画全体をレビューした後、手渡しと対話を半速で検査する。人物の識別が入れ替わる場合は、被写体と参照の対応付けを強化し、カットを簡素化する。ワイドショットで顔が融合する場合は、被写体間の距離を広げたり、対話を中距離の2人ショットに移行したりする。この問題に関するフレーミングおよび参照選択については、遠距離顔修復ガイド を参照のこと。| 失敗 | 予想される原因 | 最小限の有効な修正 | | --- | --- | --- | | キャラクターの役割が入れ替わる | 類似した衣装、または曖昧なラベル | 明確に区別されたラベル、衣装、位置、および話者 ID を復元する | | 両方の口が動く | 聴取者の動作が明記されていない | 各行の後に「聞きながら、唇は閉じたまま」と追加する | | 余分な腕が出現する | ハンドオフで接触状態が飛ばされている | 共有サポート段階および解放段階を拡張する | | 小道具の形状が変化する | 行動が多すぎる、または小道具の定義が不十分 | 寸法、ハンドル、仕上げ、最終所有者を固定する | | カット後に視線が途切れる | 位置関係が再設定されていない | 新しい角度での双方の位置と視線を再記述する | | 環境がリセットされる | シーンのアンカーが暗黙的であった | プラットフォーム、ベンチ、列車、光源の方向、時刻を再記述する |
ハンドオフの1フレームが失敗したからといって、良好な確立(establishment)を再生成してはいけません。受け入れ済みのキャラクターリファレンス、プロンプトのバージョン、seed またはタスク記録(利用可能な場合)、出力、および失敗に関するメモを保存してください。その後、最小限のショットを、1つの矯正変更を加えて再実行します。Seedance Agent はこれらのリファレンスを整理し、候補を比較し、承認状態を維持し、失敗したセグメントのみを reference-to-video ワークフロー にルーティングできます。
結論
信頼性の高い MiniMax H3 の2人による動画ワークフローでは、適切な入力モード、2つの明確に識別可能な被写体記録、安定した S1 および S2 の話者 ID、1つの因果的なインタラクション、明示的な小道具の状態変化、そして終了状態が次のオープニングと一致するカット計画を用います。アイデンティティ、口の所有権、手、視線、小道具の幾何学的形状、環境、音をそれぞれ個別に確認し、失敗したビートのみを再実行します。リファレンス、ショット、承認、および標的化された修正を一元管理するために、Seedance Agent を用いて2キャラクターシーケンスを構築 してください。
自分でも試してみますか?
このガイドの手順をSeedanceでそのまま試し、プロンプトや画像を数分で完成度の高い動画に変えましょう。
登録で無料クレジット。プランは月額$20から。
Socialive Catalyst イヤリーアクセスガイド:有用な最初のパイロットを準備する
Socialive Catalyst へのアクセス資格者、早期ベータ版の内容、デモのための事前準備、およびブランド化されたエンタープライズ動画ワークフローを 1 件テストする方法について学びます。
記事を読む
FramePack Torch CUDA が有効になっていない:正しい環境の診断と修正
正確な Python ランタイムを確認し、CPU 専用の wheel を置き換え、ドライバーまたは RTX の互換性を処理することで、Torch に CUDA サポートがない状態の FramePack を修正し、その修復を検証します。
記事を読む
Google Vids パーソナルアバターのチュートリアル:録画、プロンプト入力、および問題修正
Google Vids でパーソナルアバターを作成し、顔と声のキャプチャを完了させ、実用的な Gemini Omni プロンプトを作成し、アクセス権限の不足を修正し、録画を管理します。
記事を読む