
AI Overview
AI 動画生成において、Seedance と Vidu のどちらが優れていますか?
Seedance は、計画立案、モデル選択、選択的再実行、および単一ワークスペース内でのマルチショット出力において優れています。一方、Vidu は、Q3 生成ルートまたは S2 リアルタイムワークフローがタスクに直接適合する場合に強力です。
参照の一貫性を重視する場合、どちらのツールが優れていますか?
Vidu Q3 は、対応するルートで 1~7 枚の参照画像および再利用可能な被写体を受け付けます。Seedance 2.5 は、より大規模な混合参照パッケージを受け付け、さらに全シーケンスにわたる連続性計画機能を提供します。
Vidu はネイティブ音声を生成できますか?
はい。Vidu Q3 は、同期された会話、環境音、効果音、および音楽を生成できます。Seedance 2.5 もネイティブ音声およびリップシンクをサポートしており、Seedance のワークスペースでは、異なるショットを適切なモデルにルーティングできます。
Vidu のオフピーク生成は無料ですか?
対象となるコンシューマー向け Web ジョブについては、クレジット不要のオフピーク生成として表示される場合がありますが、API ジョブは引き続き割引適用後のクレジットを消費します。プロジェクトの予算計画に際しては、正確なルート、モデル、設定、およびキュー状況を事前にご確認ください。
Seedance 対 Vidu:概要比較
有用な比較はもはや「マルチモデルプラットフォーム vs 単一のシンプルな動画モデル」ではありません。Vidu は現在、Q3 生成に加え、S2 リアルタイムアバターおよび編集ルートをカバーしています。一方、Seedance は、現行の生成オプションに加えて、より広範な制作レイヤー(参照の整理、ショット計画、モデルルーティング、レビュー、選択的再実行、編集、アセンブリ)を統合しています。
| 決定事項 | Seedance | Vidu |
|---|---|---|
| 最適な用途 | マルチショット制作および協調的な出力 | Vidu Q3 ファミリー内における直接生成 |
| 現行のロングフォームクリップ長範囲 | Seedance 2.5 は 4–30 秒をサポート | Q3 テキスト/画像/参照ルートは最大 16 秒をサポート |
| 参照戦略 | 画像・動画・音声を含む最大 50 点の混合アセット | 1~7 枚の画像に加え、再利用可能な被写体参照 |
| 音声 | ネイティブ音声およびリップシンクに加え、モデル選択可能 | ネイティブ音声(会話・音楽・環境音)、および複数話者対応音声 |
| 編集 | プロンプトベースの変更・延長・レビュー・アセンブリ | S2 リアルタイム編集およびモデル固有のコントロール |
| コスト調整手段 | モデルを選択し、不十分なショットのみ再実行 | 通常処理または割引適用の API オフピーク処理 |
4 枚の画像は、隠されたヘッドツーヘッド出力ではなく、1 つの制御された編集シーケンスを構成しています。いずれのツールでも、繰り返し登場するライダー、折り畳み自転車、ワードローブ、ヒンジ、および変化する光をチェックリストとして活用してください。
 このベンチマークは、1 人の識別可能な人物、機械的に特徴づけられた自転車、自然な濡れ道路のディテール、および意図的に洗練されていないドキュメンタリー風の見た目から始まります。
単一のクリップではなく、完成したキャンペーンを目的とする場合は、Seedance Agent で同じ brief を開き、最も魅力的な最初の生成結果だけでなく、完全なシーケンス全体を評価してください。
品質、モーション、およびカメラ制御
サムネイルではなく、難しい 2 フレーム目を評価する
両プラットフォームとも、洗練された最初のフレームを生成できます。真の試練は、人物が振り向くとき、手が機械的物体に触れるとき、布地の方向が変わるとき、あるいはカメラが前景のディテールを通過してパンするときに始まります。クリップ全体を通常速度で再生した後、最も難しい 1 秒間をフレーム単位で検査してください。指が融合している、足が滑っている、ヒンジが歪んでいる、ジャケットの縫い目が変化している、スポークが二重になっている、背景の幾何学的形状が脈動しているなどの出力は却下してください。
Vidu Q3 は、フレームを意識したカメラ動き、ショット分割、およびネイティブの音響・映像タイミングを重視しています。その専門化されたバリエーションにより、クリエイターは、以前の Vidu 生成よりも目的意識の高い選択肢を得られます。Seedance 2.5 は、より長い 4–30 秒のキャンバスを提供し、生成前に画像・動画・音声の参照を組み合わせることが可能です。また、より広範な Seedance ワークスペースは、同一の失敗パターンで何度も試行するのではなく、各ショットに異なるモデルを適用する必要がある場合にも役立ちます。
モーションを「原因と結果」で記述する
「サイクリストが遠ざかっていく、シネマティック」といった表現は避けましょう。制作に耐えるプロンプトでは、出演者、物理的アクション、カメラ挙動、環境反応、および連続性ルールを明示的に記述します:
女性がコバルトブルーの折り畳み自転車を浅い川沿いのカーブに沿って走行する。ホイール高さの低角度・3/4 トラッキング;軽い横風に対して彼女のジャケットと髪が反応;濡れた路面の反射が自然に滑る。彼女の顔、ワードローブ、自転車のヒンジ、ホイールの幾何学的形状、サドル、ラック、および抑制されたドキュメンタリー色調を維持すること。
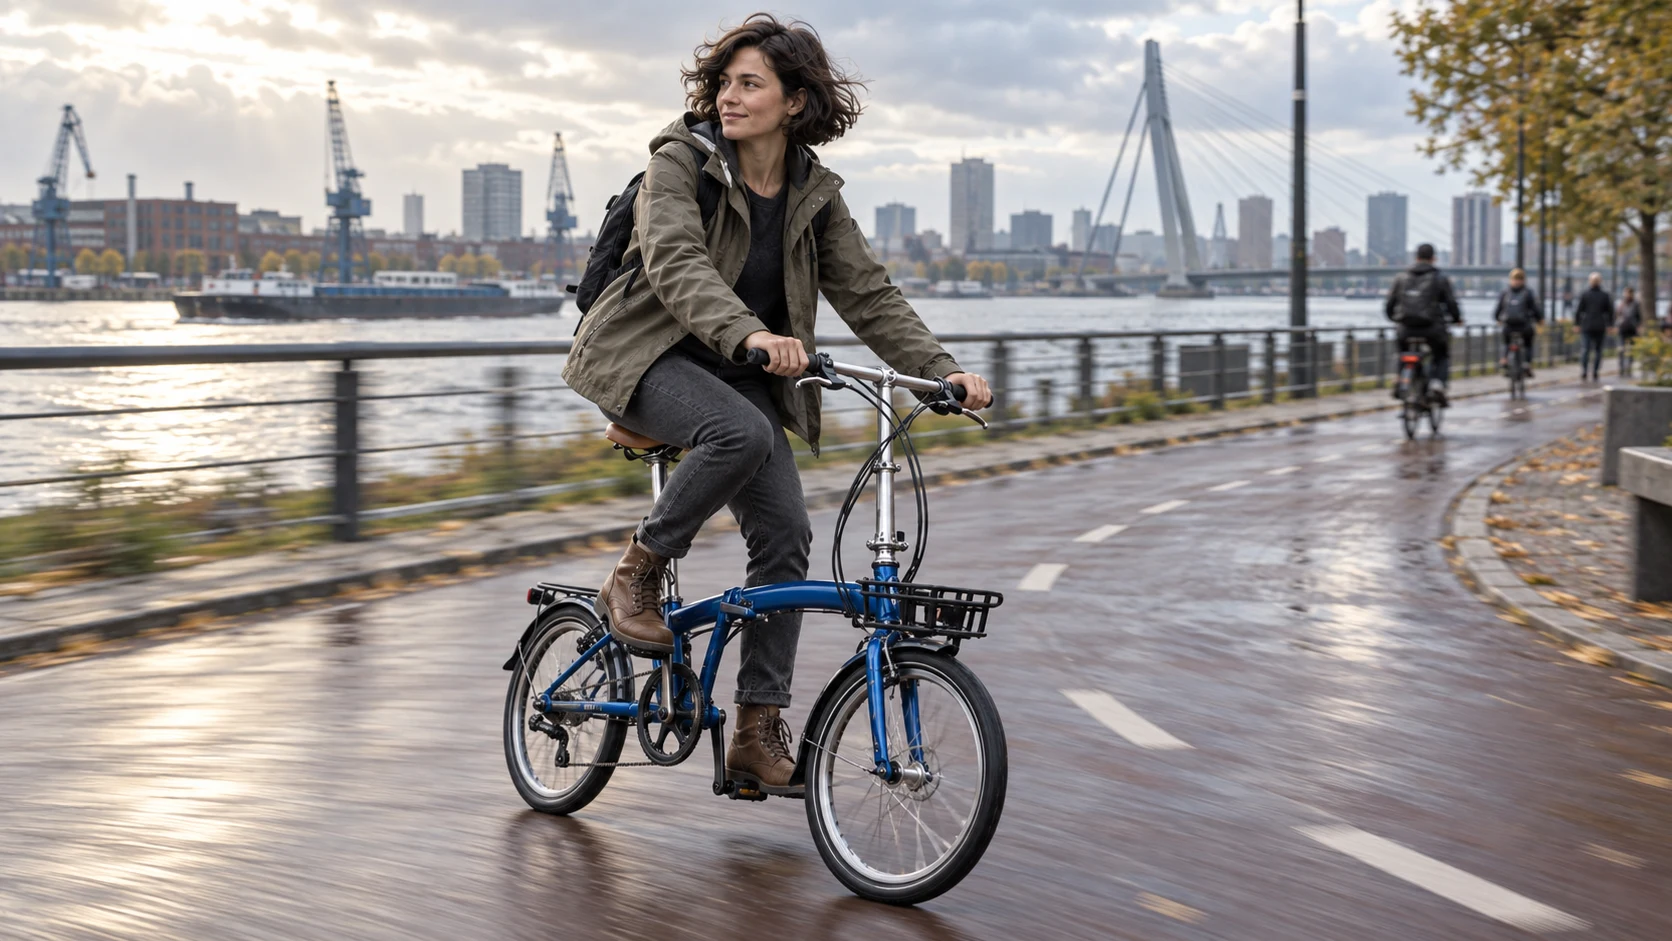 カーブ中の手・足・ホイールの幾何学的形状・スポーク・路面との接触・モーションブラー・ライダーの識別性を検査してください。
一度に 5 つのプロンプト変数を変更するのではなく、2~3 の制御されたバリエーションを実行してください。これにより、失敗の原因を特定しやすくなり、魅力的な偶然の成果が再現不可能な制作上の選択に発展することを防げます。
参照の一貫性およびマルチショット作業
Vidu Q3:焦点を絞った「参照→動画」制御
Vidu の現行「参照→動画」ルートは、1~7 枚の画像を受け付けます。その「被写体モード」では、最大 7 点の画像またはテキストによる被写体を定義でき、重要な被写体には複数のビューを関連付けることが可能です。この構造は、コンパクトなキャラクターパック、製品パック、またはアートディレクションボードを既に備えており、Vidu 内で直接クリップを生成したいクリエイターに適しています。以下に示すクローズアップ画像は、ヒーロー画像よりも意図的に実用的です。構図が変化した後でも、顔、ジャケットの質感、青いフレーム、タン色のサドル、黒いラック、銀色のヒンジ、そして雨天の雰囲気が読み取れるかどうかをテストします。
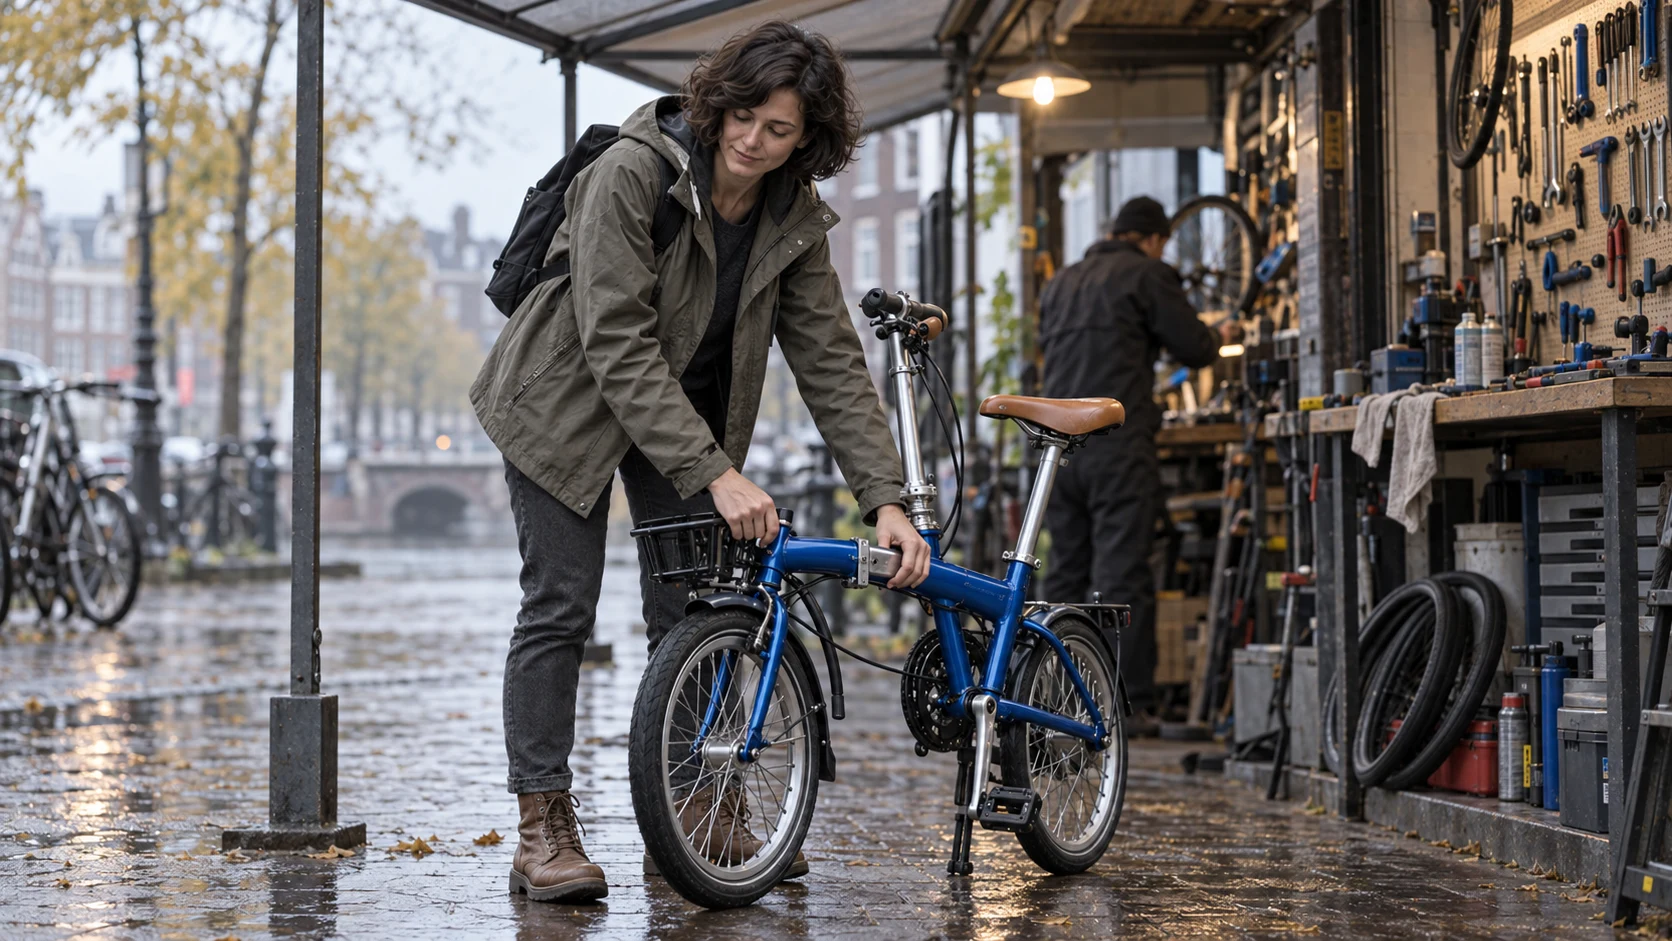 手作業による機械的操作によって、ワイドショットでは隠れがちな「アイデンティティのずれ」「指の誤り」「製品の幾何学的不具合」が露呈します。
Seedance 2.5: 大規模な混合参照パッケージ
Seedance 2.5 は最大50個の混合アセット(画像最大30点、動画最大10本、音声ファイル最大10件)をサポートします。入力数を増やしても、自動的に一貫性が高まるわけではありません。その利点は、各アセットに明確な役割を割り当てられることにあります。例えば、ある画像で顔を定義し、別の画像で自転車を定義し、動画でペダリングのリズムを、音声クリップで声や雰囲気をそれぞれ指定できます。
すべての参照素材には目的に応じたラベルを付け、必ず維持しなければならない要素を明記してください。Seedance 参照ガイドでは、「アイデンティティ」「衣装」「製品」「環境」「モーション」「サウンド」を分離して指定する方法を解説しており、モデルに各アップロードの役割を推論させることを避けます。
再利用可能なテストとして、各出力を「アイデンティティ」「ヒーロープロップ」「環境」「モーション」「音声」の5つの次元について0~2点で評価してください。10点満点中6点の美しいクリップであっても、欠落したポイントが連続性を損なう場合は、実際の制作には使用できません。この簡易な評価基準は、単一のプロンプトから「絶対的な勝者」を宣言するより、はるかに実用的です。
ネイティブ音声、編集、およびエージェントワークフロー
ネイティブ音声が受入テストを変える
Vidu Q3 は、対応ルートにおいて、スピーチ、背景音楽、アンビエンス、複数話者対応などのネイティブ音声付き動画を生成できます。Vidu の2026年9月の S2 追加機能により、リアルタイムのアバター対話および参照ガイド付きストリーム編集への対応が拡張されます。Seedance 2.5 は、ネイティブ音声にリップシンクと長尺クリップの計画機能を統合しています。いずれのシステムでも、音声はショットの一部として評価すべきです:声のアイデンティティ、ルームトーン、タイヤ音、風音、会話のタイミング、カットが単語を途中で遮断していないか、など。
音声タイミングとシーン音を確認するための実際の Seedance 出力です。これは音声ワークフローの例であり、Vidu の比較レンダリングではありません。
さらに詳しい受入基準については、会話中心のクリップを承認する前に、ネイティブ音声ワークフローガイド をご参照ください。
Seedance Agent が真価を発揮する場所
最も大きな違いは、初回生成後の段階に現れます。キャンペーンでは、ロケーションショット、製品のクローズアップ、動きの激しいアクション、会話、ロケーション変更、複数のアスペクト比など、さまざまなショットが必要になることがあります。Seedance Agent は、 brief と参照素材の整理・ショット計画・タスクに応じた適切なモデル選択・承認済み素材の保持・弱いセグメントのみの再実行・最終成果物の組み立てを一括で行えます。
Vidu は、クリエイターの広範なツールチェーン内において、特にその参照機能や Q3 専門性が該当ショットに適合する場合、引き続き強力なソースモデルです。一方、調整・連携がボトルネックとなる場合には、Seedance の方が適しています。これは、プロンプト・アセット・承認・バージョンを、接続されていない生成ステップと編集ステップ間で手動で移動させる作業を大幅に削減します。
料金、オフピーク、およびコスト管理
Vidu ウェブサイトと API を区別する
「Vidu オフピーク無料生成」は、あらゆる Vidu ルートに適用される一律ルールではなく、消費者向けウェブサービスの提供内容を表します。アカウントにゼロクレジットで実行可能なウェブジョブが表示された場合、待ち時間があってもよい探索やドラフト用途には有用かもしれません。ただし、利用可能状況、解像度、再生時間、音声オプション、ウォーターマーク条件、キュー待ち時間などは変動する可能性があるため、生成時に表示される設定を必ず確認してください。
一方、Vidu の API は異なります。API による生成はクレジットを消費します。オフピーク処理を有効化すると、サポートされるレートが通常の約半分程度に低下します。Vidu の公式ドキュメントによると、オフピークタスクは最大48時間待機する可能性があり、キャンセルされる場合もあるほか、指定ウィンドウ内に完了しなかった場合はポイントが返金されるとしています。現在の事例は変更される可能性があるため、コスト計算は消費者向けページの見出しではなく、常に最新の API 料金表に基づいて行ってください。
ステッカー価格ではなく、承認済みコストを比較する
最も安い生成が、必ずしも最も低コストなショットとは限りません。総クレジット数、キュー待ち時間、失敗した試行回数、編集時間、承認済み秒数の合計を追跡してください。$1のドラフトが6回の再試行を要する場合、$3の結果が2回目の試行で承認された場合よりも高コストです。
Seedance はさらに別のコスト調整手段を提供します:ショットをタスクに最も適したモデルへルーティングし、承認済みショットは保持しつつ、失敗した部分のみを再実行します。一貫性が多数の安価なバリエーション生成よりも重要である場合、参照から動画へワークスペース が有効です。
どちらを選ぶべきか?
製作が複数ステップにわたる場合、Seedance を選ぶ
マルチショットのCM、SNSキャンペーン、製品ストーリー、またはナラティブなシークエンスを制作するチームにとって、Seedance はより強力なデフォルト選択肢です。混合参照、長尺の Seedance 2.5 クリップ、モデル選択、レビュー、編集、延長、最終組み立てを、1つの統合されたワークフローで実行する必要がある場合に最適です。また、プロンプト専門家だけでなく、プロデューサーやマーケターといった関係者も、何が承認済みで、何がまだ作業中かを明確に把握できる点もメリットです。
ショットに Vidu のネイティブルートが適合する場合、Vidu を選ぶ
Vidu を選択するのは、直接的な Q3 ワークフロー、コンパクトな 1~7 枚の画像による参照セット、ネイティブな音声・映像生成、あるいは専門化された Vidu 変種が必要な場合です。その非ピーク時の API オプションは、キュー待ちを許容できるスケジュールと、コストモデルがこれを「無料」ではなく「割引」として扱うという条件のもとで、緊急性の低いバッチ処理作業に適しています。
コミットする前に 1 回の公正な評価を実行
両方のシステムで、同一のソースパックおよび受入ルールを用います。1 つのワイドショット、1 つの近接した機械的インタラクション、1 つの動きの多いショットをそれぞれ生成します。再生時間、アスペクト比、および音声のターゲットを比較可能なものに保ちます。試行回数と承認済みの秒数を記録します。最後に、この 3 つのクリップが依然として 1 つの物語として感じられるかを確認します。
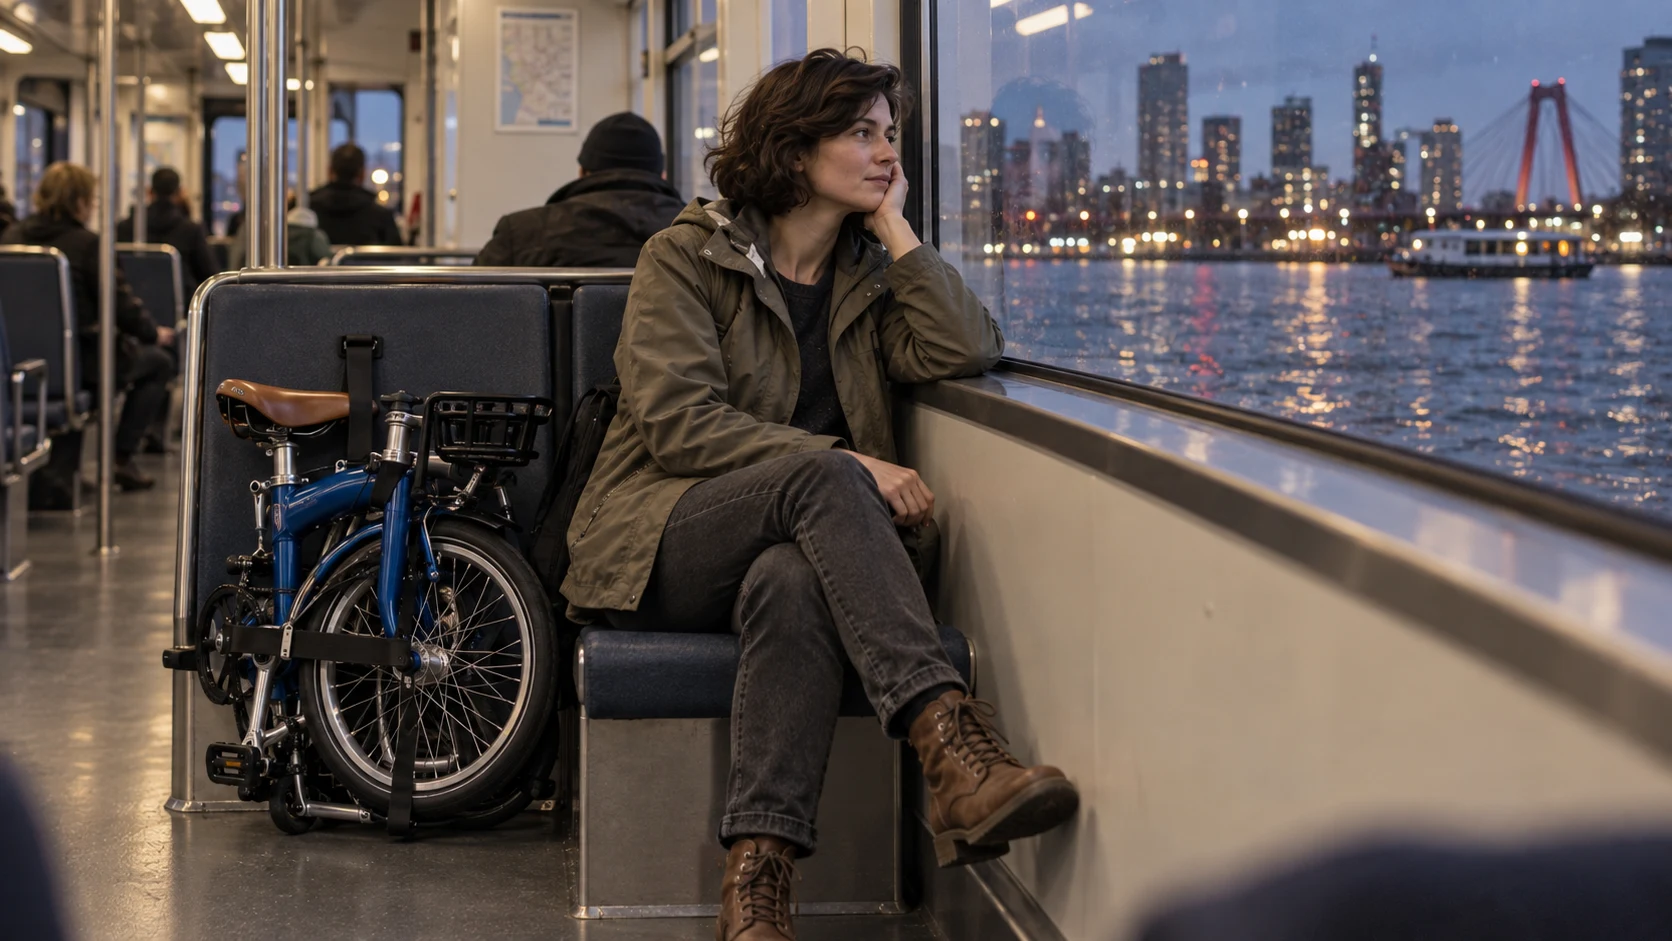 静かなフェリーのフレームは、人物の同一性、衣装、自転車の幾何学的形状、および抑制された色調が、大きなロケーションおよび照明の変化にも耐えられるかどうかをテストします。
あるプラットフォームが 2 ショットで勝ち、もう一方が 1 ショットで勝ったとしても、これは比較試験の失敗ではありません。むしろ、シーンごとに最適なモデルを選んでルーティングするワークフローの方が、すべてのシーンを単一のルートに強制するよりも効率的であるという証拠です。
結論
Seedance 対 Vidu は、単なる「美しさ」の競争ではなく、ワークフローの選択問題です。Vidu Q3 は、直接的な参照画像から動画への生成、ネイティブ音声対応、専門化された生成ルート、およびコスト重視の非ピーク時 API 作業において信頼できる選択肢です。一方、S2 は異なるリアルタイムアバターおよび編集機能を追加します。プロジェクトがより大規模な混合参照パック、より長い Seedance 2.5 クリップ、複数のモデル選択肢、連続性レビュー、部分的な再実行、編集、および配信を必要とする場合、Seedance の方がエンドツーエンドで優れた選択となります。両方を同一の 3 ショット仕様でテストし、目立つサムネイルではなく承認済みの秒数をカウントし、再作業を最も削減するルートを採用してください。選択された生成結果を完成済みのシークエンスに変換するには、Seedance 2.5 動画編集ガイド を参照してください。
自分だけのAI動画を作ってみませんか?
アイデア、テキストプロンプト、画像をSeedanceで洗練された動画に変えましょう。この記事が役立ったなら、次は実際に試すのが最短です。
登録で無料クレジット。プランは月額$28から。
関連記事
同じ言語で次に読みたい記事です。

しゃべるAIアバターの作り方|何度も使える固定キャラクターをSeedanceで作成
Seedanceで繰り返し使える話すAIアバターを作る方法。顔と声を固定し、トーキングフォトやSeedance 2.5のシーンで毎回話させます。
記事を読む
2026年最新:おすすめのAI Video-to-Videoモデル比較
2026年おすすめのAI Video-to-Videoモデル。Higgsfield Genjutsu、Seedance 2.x、Runway Aleph、Luma Modify、Kling Omniを比較し、撮影済み映像の編集に合うものを紹介。
記事を読む
Kling 4.0 vs Seedance 2.5: 徹底比較
Kling 4.0とSeedance 2.5をスペックで比較。長さ、10キーフレーム対50参照素材、音声、4Kと10-bitカラー、編集機能、用途別のおすすめを解説。
記事を読む