

AI Overview
MiniMax H3 は、1本の連続した会話アバタービデオを作成できますか?
はい。ただし、長尺の出力は、無制限な1回生成ではなく、複数の承認済みクリップとして計画すべきです。H3 の出力は4~15秒であるため、台本を自然な一時停止点で分割し、同一の顔・声・構図・ルームトーン(部屋の残響音)を共有するセグメント同士を結合します。
各セグメントでアバターの同一アイデンティティをどう維持しますか?
1枚の明確なアイデンティティ参照画像を用い、可視的な特徴をすべて再現し、S1 のような安定したスピーカーIDを1つ割り当てます。さらに、各継続セグメントは、承認済みの中立境界フレームから開始します。変更するのは対話内容と、最小限に必要なジェスチャーのみです。
会話アバターのカットがシームレスに見えるのはなぜですか?
各セグメントは、完全な文の終了後、口を閉じた状態・安定した視線・落ち着いた手の位置・短いルームトーンの末尾で終了させます。次のセグメントは、その同一の状態から開始し、自然な一時停止や控えめなカッタウェイ(切り替え)で接合部を隠します。
リップシンクのドリフト(ずれ)をどう防ぎますか?
各発話ブロックは1回の呼吸で収まる長さに保ち、<d> タグ内に正確な台詞を記述し、顔やカメラの動きとの競合を避けます。セグメントを承認する前に、通常速度および1フレーム単位で口元を確認します。
連続アバターを「短く承認済み」のセグメントとして計画する
呼吸単位のクリップからマスターを構築する
MiniMax H3 の連続会話アバター・ワークフローは、無制限の再生時間への要求ではなく、制作計画です。公式の H3 ツールは、4~15秒の整数値の再生時間を受け付けます。この上限を創造的制約として捉えてください:各クリップには、1つの完結したアイデア・控えめなジェスチャー・明確な終了状態が含まれるべきです。45秒の解説は、3本を無理に最大限まで伸ばすのではなく、10~13秒の4セグメントに分割するのが適切です。
生成を始める前に、あらかじめ台本に区切りをマークしてください。良い区切りは、句読点・呼吸・話題の転換に従います。悪い区切りは、人名・数字・感情的に結びついた語句を分断します。各セグメントをタイマー付きで音読し、開始時の安定化と終了時の保持のためにそれぞれ約1秒を確保します。すでに台詞が全長を占めている場合は、モデルに早口を強いるのではなく、台詞を短縮してください。
| セグメント | 発話の役割 | 目標となる動作 | 必須の終了状態 |
|---|---|---|---|
| A | トピックの導入 | 小さなオープンハンド・ジェスチャー | 口を閉じ、手を下げ始める |
| B | 主要ポイントの説明 | 抑えた人差し指によるジェスチャー1回 | 同じ視線、手は机の上 |
| C | 例の提示 | 短い頷き、カメラ移動なし | 中立的な表情とルームトーン |
| D | コール・トゥ・アクション(CTA)の提示 | やや前傾→その後落ち着く | 編集用に2ビートの保持 |
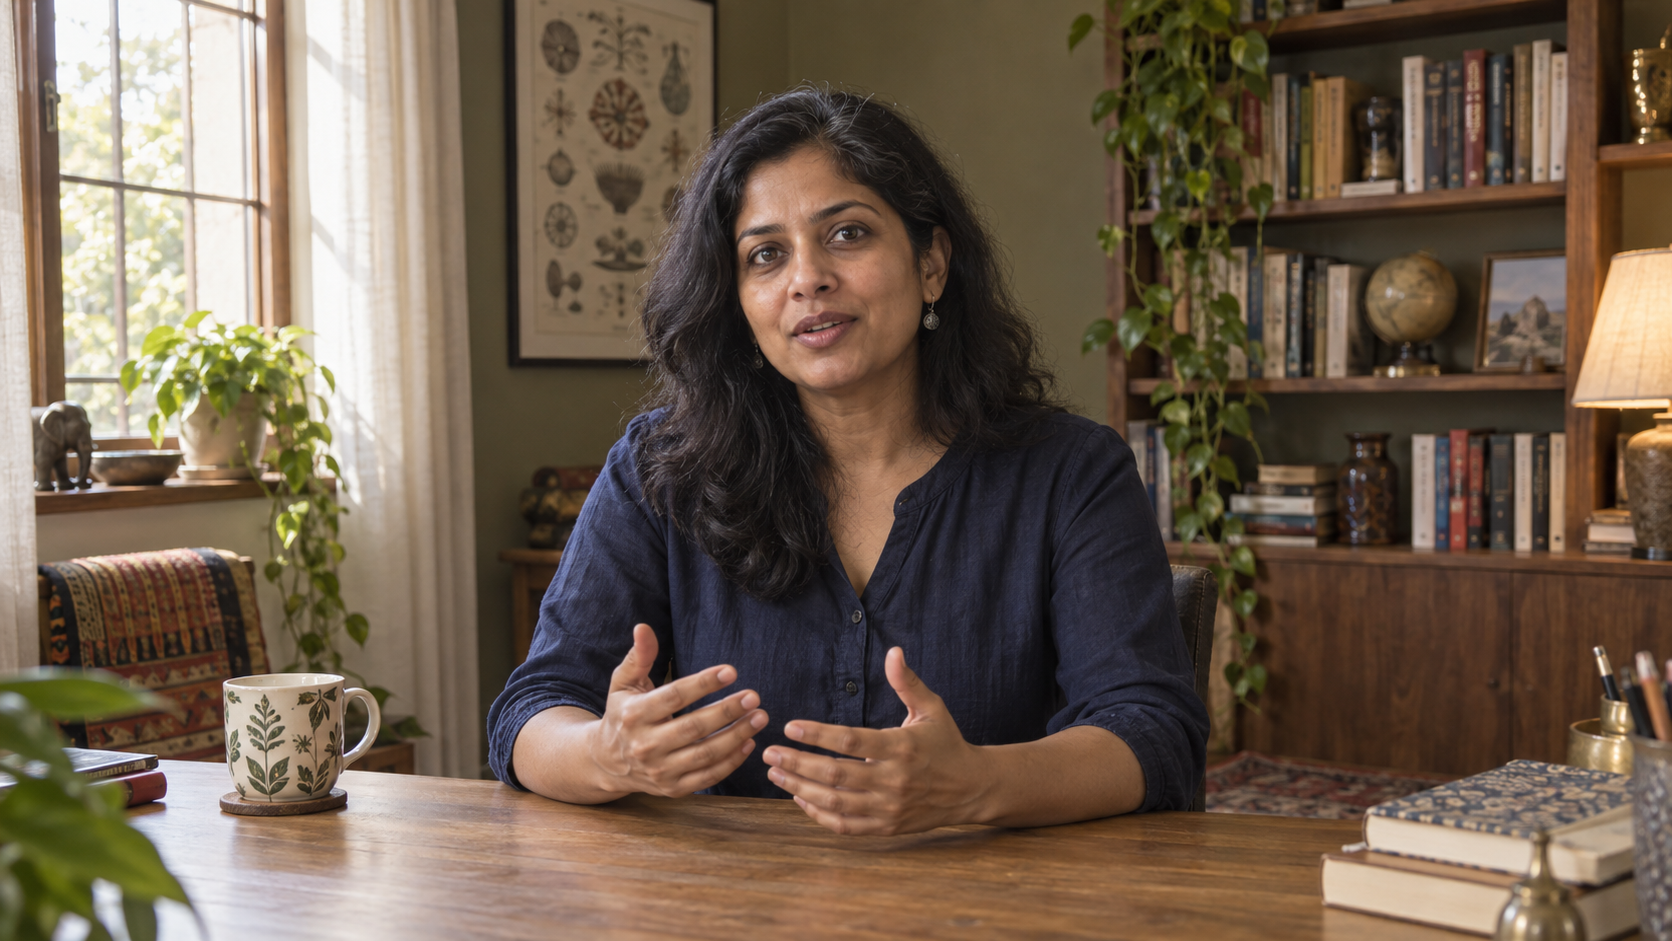
参考用生成静止画(MiniMax H3 の実際の出力ではありません):中間~やや寄りの構図、手の可視性、シンプルな衣装、安定した背景は、タイトなビューティーポートレートよりも、会話シークエンスの連続性を示す根拠となります。
この分割方式は、復旧コストも低減します。セグメントCの口の形が不十分であれば、他の承認済み素材をリスクにさらさずにCのみ再実行できます。再開可能なマルチショット・ワークフローにおける同じチェックポイント論理が、ここでも適用されます:すべてのセグメントについて、台本バージョン・参照セット・プロンプト・出力・承認済み境界フレームを保存してください。
顔・声・台本・フレームの準備
1つのコンパクトな連続性パケットを作成する
読み取り可能な顔・リラックスした唇・雑然としない背景・完成映像に必要な同一のカメラ角度を備えた参照画像を選択してください。ワイドショットより、中間またはやや寄りの構図の方が安全なことが多い理由は、口が検査可能な大きさを保てるためです。髪を唇から離し、手が下部の顔を遮らないようにし、硬い動きのある影ではなく柔らかい方向性の光を使用してください。
固定アイデンティティ・ブロックを1つ作成し、文字通りそのまま再利用します。年齢層・髪型・衣装・目立つがごく普通の特徴・声質・話す速さ・必要に応じてのみ指定するアクセント・カメラ高さ・ショットサイズ・光の方向・背景のアンカーを含めてください。後のセグメントで新しい形容詞を追加しないでください。無害に思える追加でも、スタイリング・年齢・顔のプロポーションを変える可能性があります。
参照駆動型生成では、H3 は画像・動画・音声の各アセットを活用できます。公式のフル参照ガイドでは、可視被写体・具体的な画像アンカー・ソース動画・音声参照を明確に区別しています。音声参照がコピー信号ではなく声のキャラクターを提供する場合、それを「音色および発話スタイルの参照」として記述します。アバターが実際に話す場所には、常に同一のスピーカーIDを付与してください。
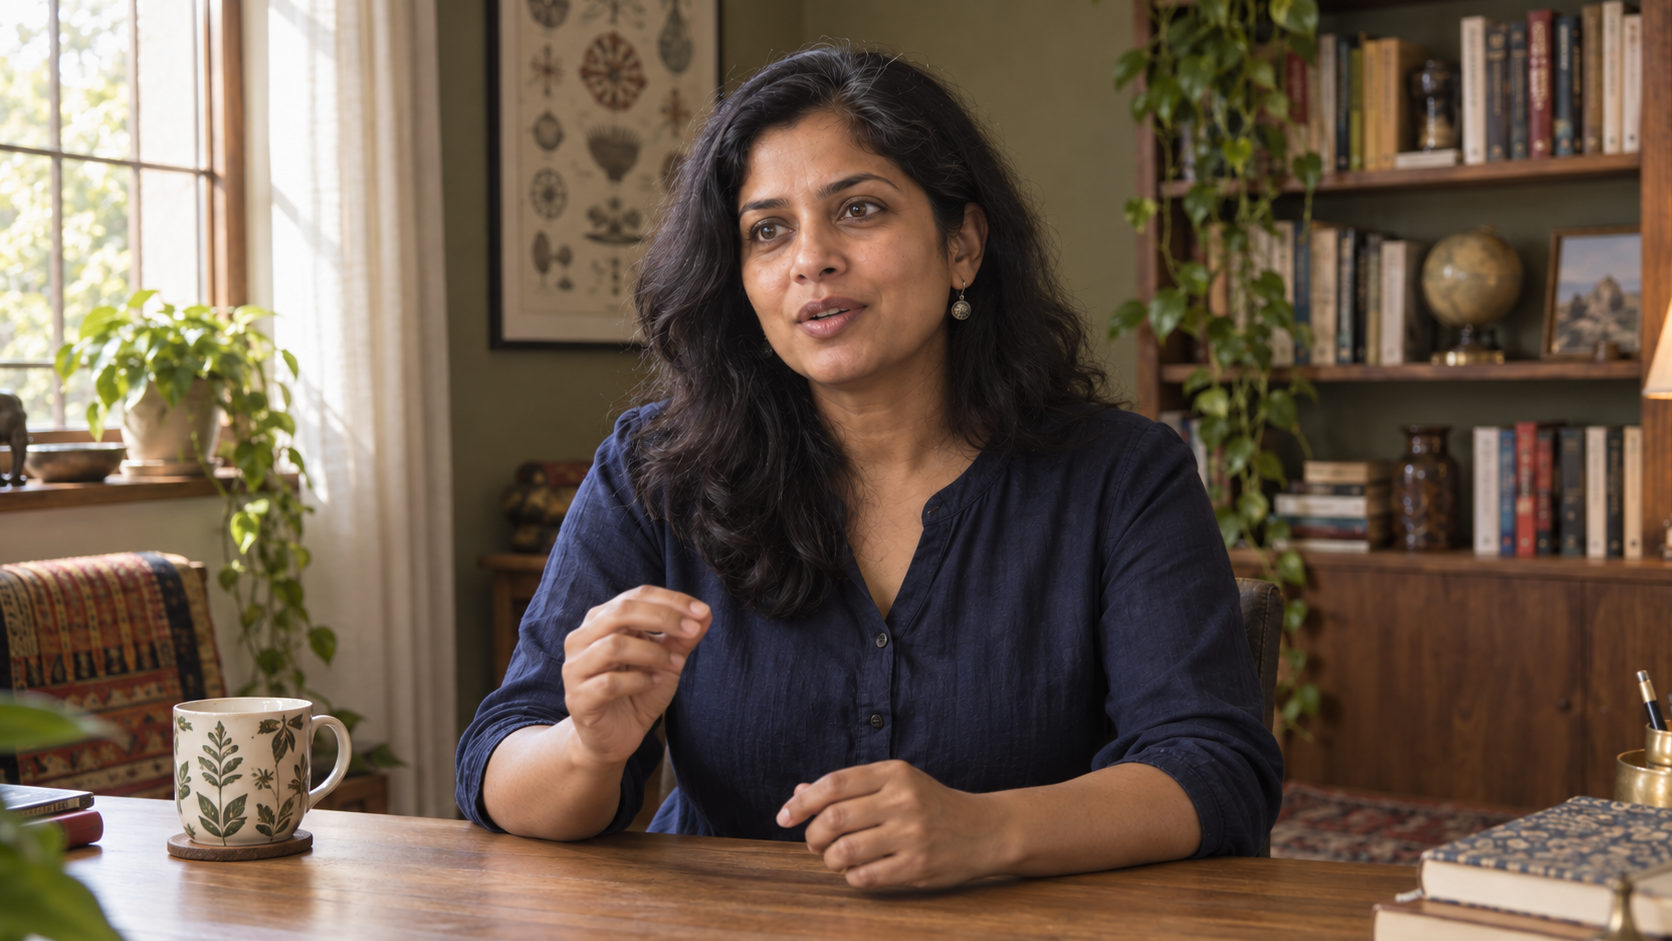
発話セグメントの連続性目標:アイデンティティ・レンズ・視線・衣装・照明は固定し、口の形と1つの小さなジェスチャーのみを変化させる。
特定の声が必要な場合は、クリーンな台詞を録音してください。静かな部屋・一定のマイク距離・バックグラウンドミュージックなし・各セグメントごとに個別のファイルを使用します。生成前に、音量とルームトーンを揃えてください。目的が単に妥当なネイティブな声である場合、安定した音色とペースを指定しますが、プロンプト内には依然として正確な台詞を記載し続けてください。ボイスの一貫性維持ガイドに掲載されている有用なリスニング・チェックリストは、H3 出力のレビュー時にも有効です。
スピーカーのアイデンティティを損なわず H3 の台詞を書く
対話タグの外側に視覚的な指示を保持する
公式の H3 ベースガイドでは、(S1) のような安定した話者 ID を使用し、発話される言葉のみを <d> タグ内に配置します。識別句、動作、話し方、および話者 ID はすべてタグの外側に残します。この分離により、パフォーマンスに関する注釈が誤って対話として解釈されるのを防ぎます。
[ショット 1] 同じ科学教育者がオーク製のデスクに座っているリアルな中間ショット。カメラ、レンズ、ライティングの方向、衣装、本、植物、コップはすべて変更しない。落ち着いた大人の女性(S1)が、温かみのある低〜中音域の声、一定のペース、明瞭な発音で、レンズのすぐ横を見つめています。彼女は小さなオープンハンド・ジェスチャーを1回行い、<d>[English] A stable avatar begins with a stable handoff between every approved clip.</d> と述べます。文の終了後、彼女の唇は閉じ、手はデスクに戻り、同じ視線を1秒間保ちます。静かなルームトーンが継続。BGMなし、カメラ移動なし、テキストオーバーレイなし。
新しい生成時に S1 の正体を忘れてしまう可能性がある場合は、識別句を再び記述してください。次のクリップで同一アバターに新たな話者番号を割り当てないでください。別の声が登場する場合は、S2 を一度だけ割り当て、役割を明示的に維持してください。単一人物による解説動画では、他の可聴音声を除外することで、不要なドリフト要因を排除できます。
1つの可視アクションにつき、1つの発話節(spoken clause)を記述してください。素早い首の回転、大きな腕の動き、カメラプッシュ、長い文は、いずれも短い時間間隔内で競合します。口の動きの精度が重要である場合、カメラは静止させ、上半身の動きを最小限に抑えます。H3 マイクロエクスプレッション・プロンプトガイド に記載されている実用的な表情制御機能を活用し、顔全体の変化を伴わずに、控えめな眉の上げや頷きを指示できます。
各カットにわたって「アンカー状態」を維持する
次の開始を依頼する前に、まずきれいに終了させる
1つのクリップの最終秒が、次のクリップに対する視覚的な約束となります。以下の「ロックされた終了状態」を明示的に指示してください:唇は閉じている、顎はリラックスしている、視線は同じマーカーに向けられている、手は指定された位置にある、肩は水平で、背景の物体は変更されていない。生成ルートが許す場合は、その承認済み終了フレームを次の画像アンカーとしてエクスポートしてください。中立的なホールド(静止)は、単語の途中でキャプチャされたフレームよりも再利用性が高いです。
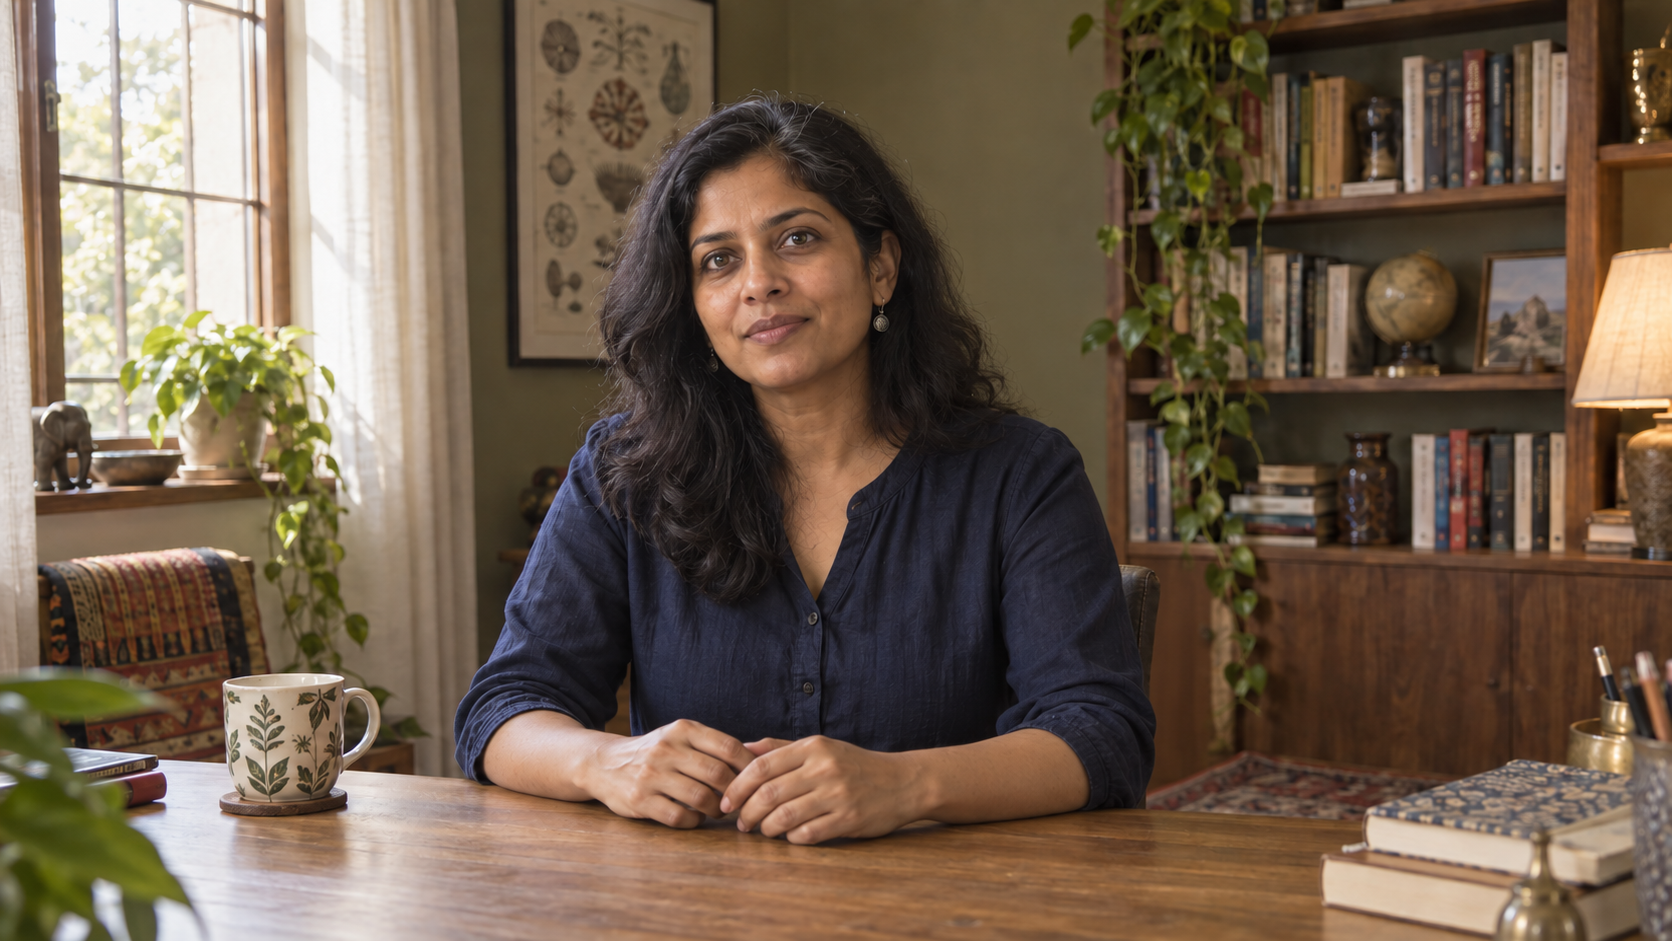
有用な境界フレームは意図的に無事象(uneventful)です:口は閉じており、視線と姿勢は安定しており、編集をまたいで「魔法のように」継続しなければならないジェスチャーはありません。
セグメント B の冒頭では、新しいアクションの前に、そのロックされた状態を再確認してください。頭部のサイズ、カメラの高さ、視線、ライティングの方向、袖の位置、および高コントラストな背景オブジェクトの位置を維持します。最初の動きは、短い安定期間の後に始めるべきであり、フレーム1から始めてはいけません。次のクリップが異なるポーズで始まる場合、視聴者は言葉を聞く前にジャンプ(不連続)に気づいてしまいます。
H3 は「最初/最後のフレームモード」と「参照モード」をサポートしていますが、作業内容に合致するモードのみを使用してください。具体的な境界画像はフレームアンカーであり、音声サンプルは音色(timbre)のガイドとなり得ます。以前の動画は、モーションや継続性のコンテキストを提供できます。ただし、参照資産の数が多いほど良いというわけではありません。承認済みの構図、衣装、または声と矛盾する資産はすべて削除してください。
このハンドオフ手法は、マルチキーフレーム計画 と密接に関連していますが、トークアバターにはより少ない視覚的野心で十分です。境界ごとに1つの安定したアンカーを設定する方が、顔・手・カメラ・部屋のすべてを同時に変化させようとする密度の高いストーリーボードよりも通常は優れています。
音声的・視覚的なジャンプ(不連続)を伴わず、セグメントを組み立てる
ポーズでカットし、ルームトーンを維持する
すべての承認済みクリップを、脚本順に1本のタイムライン上に配置してください。重複する安定フレームはトリミングしますが、口が開いている状態からカットをずらすために、十分な中立的な素材は残しておいてください。トランジションを追加する前に、スケールと位置を一致させてください。自然なポーズ中に直切り(straight cut)を行うのが、通常は最もクリーンです。フェードアウト/インやディゾルブは、一時的に2つの口が表示され、顔が不安定に見えるため、避けた方がよいでしょう。
これは実際の Seedance 出力であり、MiniMax H3 の結果ではありません:このネイティブ音声サンプルを、発話タイミング、顔の動き、途切れのない環境音のレビュー基準としてご活用ください。
映像を非表示にして、音声のつなぎ目を聞いてください。対話の音量、ノイズフロア、残響、および各呼吸の長さを揃えてください。小さなギャップが「部屋の音が途切れた」ように聞こえないよう、シーケンス全体の下に短い連続的なルームトーンをレイヤーとして配置してください。音声のカットが問題なく機能するまでは、BGMは避けてください。サウンドトラックは編集時に不良なつなぎ目を隠すことはできても、それを修正することはできません。
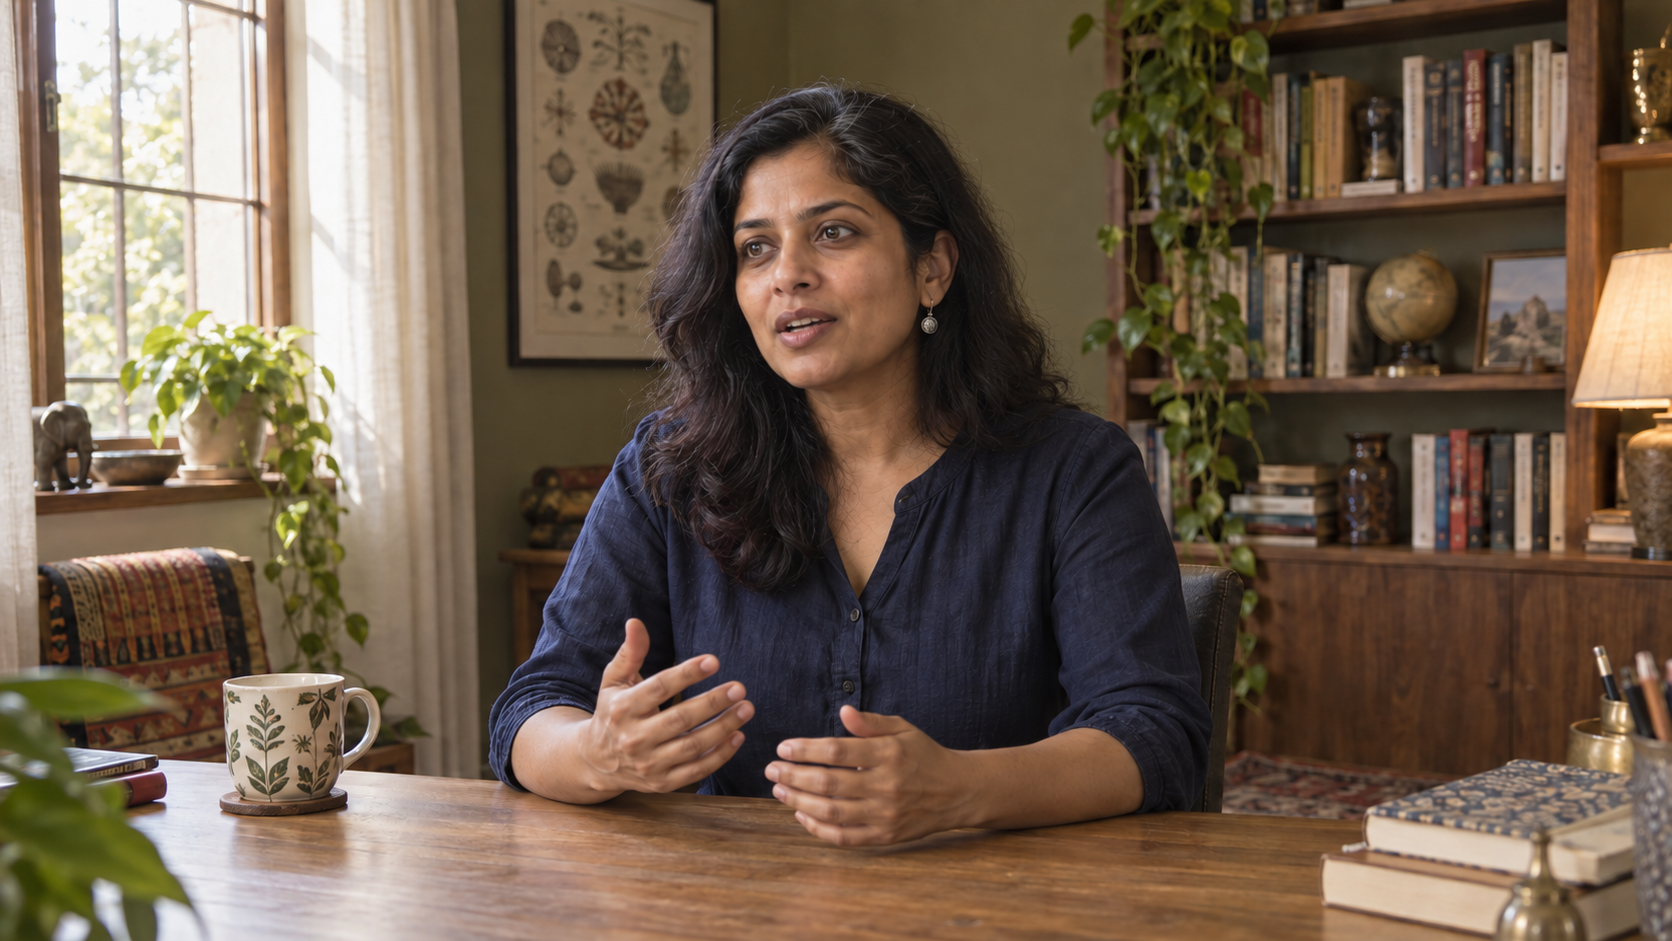
継続の目標:アイデンティティおよび視覚的アンカーは安定したまま、新しい文は、わずかに異なるが依然として自然な手のジェスチャーとともに始まります。
それでもジャンプ(不連続)が残る場合は、関連性のあるカッタウェイを1〜2秒挿入してください:話者のノートブック、彼女が言及するオブジェクト、あるいは同じ部屋からの広角ビューなどです。ランダムなストック映像を挿入しないでください。カッタウェイは、発話された文の内容を説明・補足し、その後、同一のアバター状態へ戻るべきです。
リップシンク、声、および連続性の失敗をレビューする
各クリップを5つの独立したパスで承認する
まず、意味と自然なリズムを把握するために通常の速度で再生します。次に、音声をミュートして、顔の同一性、歯、唇、顎、目、手を確認します。第三に、映像を見ずに音声のみを聴き、声質、話す速さ、部屋の残響(ルームトーン)、クリック音などをチェックします。第四に、各セグメントの冒頭および終了の12フレームを1フレームずつ確認します。第五に、スマートフォンサイズのプレーヤーで組み立てられたシークエンスを再生し、微細な表情の変化をより明確に感じ取るようにします。
以下のいずれかが発生した場合、そのクリップは却下します:口の動きが音声の終了後も継続する、歯の形状がフレームごとに変化する、顎が横方向に滑動する、目の色が変化する、手が顔を透過する、あるいは声の年齢感や距離感が急激に変化する。同一性の崩れをシャープネス調整で修復してはいけません。最後に承認されたアンカーから、最も小さな失敗セグメントを再実行します。
複数の失敗が同一の原因に起因する場合は、再生成の前に簡略化を行います。台詞を短縮する、ジェスチャーを削除する、カメラを固定する、画角内の顔を拡大する、あるいは曖昧な参照を置き換えるなどの措置を講じます。この段階では Seedance Agent が有効です。なぜなら、参照パケット、セグメントプロンプト、実際の出力、メモ、および承認済みの再実行ポイントを一元管理できるからです。プロジェクトを散在するファイルから再構築する代わりに、H3 の結果を制御された 参照映像生成ワークフロー(reference-to-video workflow) と比較できます。
結論
信頼性の高い MiniMax H3 の連続会話アバターは、短くレビュー可能な音声セグメントから構成されます。脚本のタイミングを計り、同一の人物像と S1 の声の定義を維持し、正確な台詞を <d> タグ内に配置し、すべてのクリップを中立的なアンカーで終了させ、承認済みのテイクを連続したルームトーン上で結合します。この手法は無限の生成を保証するものではありませんが、顔・声・口の動き(リップシンク)の品質を犠牲にすることなく、より長い解説を構築するための回復可能な方法を提供します。参照素材、プロンプト、出力、承認、選択的再実行を単一の制作プロセスで計画するには、Seedance Agent を用いた会話アバタープロジェクトを開始してください。
自分でも試してみますか?
このガイドの手順をSeedanceでそのまま試し、プロンプトや画像を数分で完成度の高い動画に変えましょう。
登録で無料クレジット。プランは月額$20から。
MiniMax H3 カメラの焦点距離制御:ワイド、ノーマル、テレフォト風の表現
MiniMax H3 において、ショットサイズ、カメラ距離、ズーム表現、参照フレーム、および再現可能な 24mm~85mm プロンプトテストを用いて、見た目のレンズ効果を制御します。
記事を読む
MiniMax H3 2人動画ワークフロー:役割・台詞・動きを明確に保つ
ミニマックスH3を用いた2人シーンを構築し、被写体のラベルを安定させ、ブロッキングを読みやすくし、台詞を割り当て、小道具の受け渡しをクリーンにし、実用的な失敗検出ワークフローを導入します。
記事を読む
Socialive Catalyst イヤリーアクセスガイド:有用な最初のパイロットを準備する
Socialive Catalyst へのアクセス資格者、早期ベータ版の内容、デモのための事前準備、およびブランド化されたエンタープライズ動画ワークフローを 1 件テストする方法について学びます。
記事を読む