
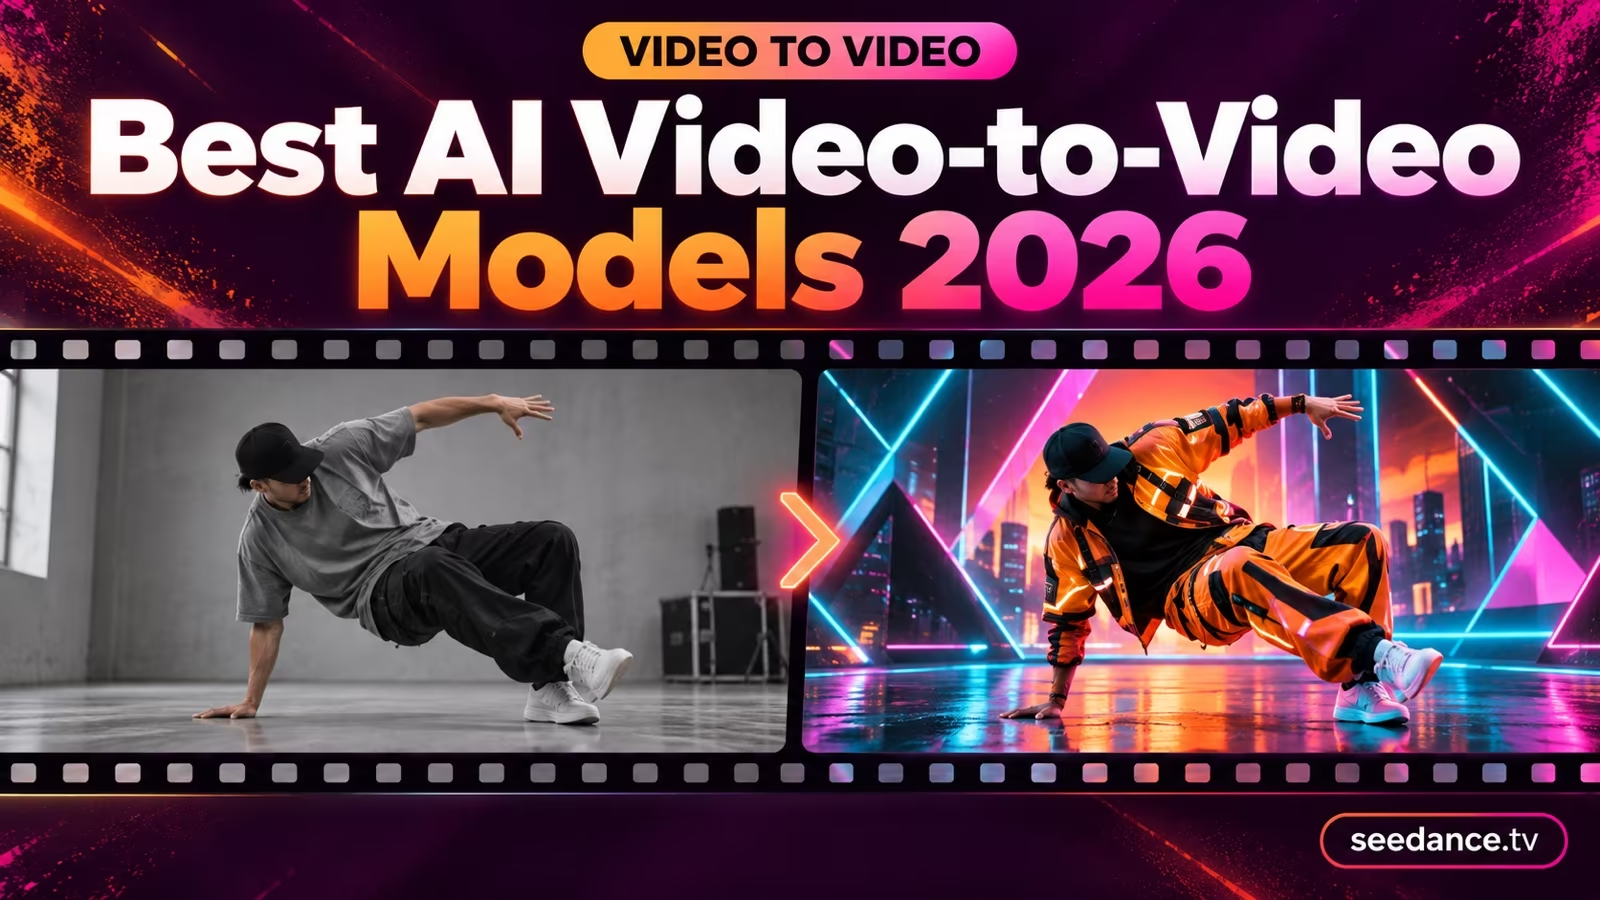
クイック回答: パフォーマンスを維持したまま、キャスト、衣装、セットを変更したい場合は、まず Higgsfield Genjutsu を検討してください。テキストプロンプトと参照画像を1か所で使用してクリップを作り直したい場合は、Video to Video の Seedance 2.x が最も早く始められる方法です。Runway Aleph、Luma Modify、Kling の Omni モデルは、ショットレベルの編集、俳優の入れ替え、プロンプトによる変更に強力な選択肢となります。
テキストから動画(Text-to-video)が注目を集めていますが、2026年における実用的な作業の多くは、既存の映像から始まります。お気に入りのダンスのテイク、すでにレビューを通過した広告、あるいはタイミングの良いコントなどがあるでしょう。必要なのは新しいショットではなく、新しい衣装、新しいロケーション、あるいは新しい製品です。
それこそが Video-to-Video モデルの役割です。ソースクリップに加えて、プロンプトや参照画像を提供すると、動きを維持したまま画面上の内容を再構築します。このガイドでは、今年知っておくべきモデル、それぞれの得意分野、そしてそれらの選び方について解説します。
私たちはラボでのベンチマークテストは行っていません。以下のメモは、各モデルの公開ドキュメントや公式の例、および seedance.tv でこれらのツールをどのように使用しているかに基づいています。
Video-to-Video モデルで注目すべき点
名前を比較する前に、どのような編集が必要かを決定しましょう。ほとんどの作業は次の4つのタイプのいずれかに分類されます。
- モーショントランスファー(動きの転送): 振り付け、カメラパス、タイミングを維持し、それ以外をすべて参照から再構築します。
- オブジェクトまたはキャラクターの入れ替え: 1つの要素(ジャケット、製品、人物)だけを変更し、残りは撮影時のままにします。
- リスタイル: クリップ全体を、アニメ、クレイアニメ、フィルム粒子などの新しい外観に変更します。
- プロンプトによる編集: 「夜にする」や「看板を消す」など、言葉で変更を指示します。
次に、実用的な制限を確認してください。ソースクリップの長さ、受け入れ可能な参照画像の数、出力解像度、そして元の音声が維持されるかどうかです。
1. Higgsfield Genjutsu: パフォーマンスの配役変更に最適
Genjutsu は Higgsfield の最新の Video-to-Video モデルです。その主なコンセプトはシンプルです。ソースクリップは「パフォーマンスのトラック」として機能します。動き、カメラパス、カットは固定されたまま、人物、服、小道具、セットが参照画像から再構築されます。
Higgsfield は3つのワークフローをドキュメント化しています。
- Motion Transfer は、元の動きに合わせてキャスト、ロケーション、外観を再構築します。
- Object Swap は、衣装や製品など、指定した要素のみを変更します。
- Restyle は、クリップ全体にスタイルのプリセットを適用し、元の音声を維持します。
Higgsfield のドキュメントによると、ソースクリップは少なくとも4秒必要で、30秒を超えるものはトリミングされます。出力は 480p、720p、または 1080p です。Motion Transfer と Object Swap は、1回の API コールで1〜8枚の参照画像を受け取ります。
公式のビフォー・アフター動画が、このモデルを判断する最良の方法です。この Higgsfield Genjutsu examples page では、左側にオリジナル、右側に Genjutsu を配置した6つの例を並べて確認できます。キャスト全員の衣装の入れ替えや、オフィスシーンでのマスコットキャラクターへの配役変更は、このモデルの強みを示しています。
最適: ミュージックビデオ、ダンスコンテンツ、ファッションルックブック、およびタイミングがすでに承認されている広告バリエーション。衣装の入れ替えが主な用途である場合は、専用の UGC virtual try-on video maker を使用して、1つの衣服を異なるクリエイターに着せるのも一つの方法です。
注意点: 小さなテキスト、ロゴ、手。製品やブランドの入れ替えを公開する前に、すべてのフレームを確認してください。
2. Seedance 2.x: 今すぐ使える最高のオールラウンドな選択肢
Seedance 2.0およびSeedance 2.5は、画像やテキストだけでなく、ビデオをリファレンスとして受け入れます。これにより、クリップをアップロードし、リファレンス画像を追加して、変更内容を記述するだけで済む、柔軟なビデオ・ツー・ビデオ(video-to-video)ツールとなっています。
seedance.tvでは、これはVideo to Videoページで動作します。リスタイル、衣装や背景の変更、「同じショットで新しい雰囲気」にする編集に適しています。Seedance 2.0 video to videoで詳細なウォークスルーを解説しています。
最適な用途: 別の編集アプリを学ぶことなく、1つの場所でクリップのリスタイル、いくつかのプロンプトの試行、書き出しを行いたいクリエイター。
注意点: 非常に長いソース素材。アップロード前に実際に必要な部分だけにクリップをカットすると、より綺麗な結果が得られます。
3. Runway Aleph: ショットレベルの編集に最適
RunwayのAlephは、プロンプトを使用して既存の映像を編集するために構築されています。照明の変更、オブジェクトの追加や削除、カメラアングルの変更、またはショット全体に特定のルックを適用することが可能です。Runwayの広範な編集ツールキット内に組み込まれているため、すでにRunwayでプロジェクトを編集している場合に便利です。
最適な用途: 特定のショットに対して精密な変更を加えたい、すでにRunwayを使用しているエディター。
注意点: 長いプロジェクトでのコスト。プロンプトによる編集は微調整のために何度も繰り返しやすいためです。
4. Luma Modify: 俳優の演技を維持するのに最適
LumaのModifyワークフローは、オリジナルの動き、タイミング、感情表現を維持しながら映像を変換するように設計されています。演技をそのままに、俳優を入れ替えたり、シーン全体の世界観を変えたりする場合によく選ばれます。
最適な用途: セットよりも演技が重要となるナラティブな短編映画やキャラクター作品。
注意点: 多くの人が動いている複雑な背景。シンプルなショットの方が、通常はより綺麗に変換されます。
5. Kling Omni モデル: プロンプト主導の変更に最適
KlingのOmniラインは、生成と編集を1つのモデルに統合しています。既存のクリップを読み込ませ、テキストやリファレンスで変更を指示できるため、短く的を絞った編集に適しています。すでにKling 3.0で生成を行っている場合、Omniのワークフローは馴染みやすいでしょう。Klingは2026年9月28日にKling 4.0を発表しました。これにはキーフレーム制御とOmniリファレンスモードが含まれています。公式の詳細と例はこのKling 4.0モデルページにまとめられています。
最適な用途: 言葉で編集内容を説明したい短いクリップ。
注意点: クリップの長さ。Omni編集は短いセグメントで最も効果を発揮するため、まずトリミングを行ってください。
クイック比較
| モデル | 得意なこと | 入力 | 備考 |
|---|---|---|---|
| Higgsfield Genjutsu | 配役変更、衣装および製品の入れ替え | ソースクリップ + 1–8枚のリファレンス画像 | 4–30秒のソース、最大1080p |
| Seedance 2.x | オールラウンドなリスタイルと編集 | ソースクリップ + 画像 + プロンプト | seedance.tvで利用可能 |
| Runway Aleph | ショットレベルのプロンプト編集 | ソースクリップ + プロンプト | Runwayのエディターの一部 |
| Luma Modify | 俳優の演技の維持 | ソースクリップ + リファレンス | キャラクター作品に強い |
| Kling Omni | プロンプト主導の短い編集 | ソースクリップ + プロンプト + リファレンス | 短いセグメントに最適 |
選び方
- キャストや衣装を変えて同じ演技を再現したい場合: まずはGenjutsuから始め、公式の例を確認してください。
- 数分でリスタイルを試したい場合: Video to VideoでSeedance 2.xを使用してください。
- すでにタイムラインツール内で編集している場合: Runway Alephがそのワークフローに適しています。
- 演技が重要な場合: Luma Modifyを試してください。
- 小さな変更を言葉で説明したい場合: Kling Omniモデルを使用してください。
- 有料のソーシャル広告を作成している場合: 承認済みのクリップをvideo-to-video adsワークフローで新しいクリエイティブに変換し、バリエーションを比較テストしてください。
Higgsfieldを他のプラットフォームとより広く比較したい場合は、Higgsfield alternativesのリストで価格やワークフローの違いを確認できます。Nereoのようなマルチモデルプラットフォームでは、これら複数のビデオモデルを1つのアカウントで利用できるため、同じクリップを複数のエンジンでテストしたい場合に便利です。各エンジンで何ができるかは、このAI video and image model directoryで閲覧できます。
ビデオ・トゥ・ビデオ(Video-to-Video)の結果を向上させるヒント
- クリーンなソースから始める。 安定した映像、良好な照明、明確な被写体があれば、どのモデルでもより良い結果が得られます。
- アップロード前にトリミングする。 必要な秒数だけを使用してください。ソースが短いほど処理が速く、通常は仕上がりも綺麗になります。
- 形容詞ではなくリファレンスを使用する。 「かっこいい赤いジャケット」と説明するよりも、目的のジャケットの写真を用意する方が効果的です。
- 一度に一つのことだけを変更する。 まず衣装を変え、次に背景を変えます。一度に複数の編集を重ねると、エラーの修正が難しくなります。
- 細部を確認する。 顔、手、ロゴ、画面上のテキストは、ビデオ・トゥ・ビデオがまだ苦手とする部分です。
FAQ
2026年で最高のAIビデオ・トゥ・ビデオモデルは何ですか?
唯一の勝者はいません。演技のキャスト変更や、衣装・製品の入れ替えにはHiggsfield Genjutsuが最も強力な選択肢です。seedance.tvのSeedance 2.xは、最も簡単なオールラウンドなオプションです。Runway Aleph、Luma Modify、Kling Omniは、それぞれ特定の種類の編集において優れています。
Higgsfield Genjutsuとは何ですか?
GenjutsuはHiggsfieldのビデオ・トゥ・ビデオモデルです。ソースクリップの動き、カメラワーク、タイミングを維持したまま、参照画像を使用して画面に映る内容を置き換えます。Motion Transfer、Object Swap、Restyleのワークフローをサポートしています。
ビデオ・トゥ・ビデオAIは元の音声を保持できますか?
保持できるワークフローもあります。Higgsfieldのドキュメントによると、GenjutsuのRestyleワークフローはソース音声を保持します。他のモデルについては、エクスポート設定を確認するか、エディターで元の音声を再度追加してください。
ソースビデオの長さはどのくらいまで可能ですか?
モデルによって異なります。Genjutsuは最低4秒必要で、30秒を超える部分はトリミングされます。ほとんどの他のモデルは短いクリップで最適に動作するため、最初にトリミングする習慣をつけるのが良いでしょう。
ビデオ・トゥ・ビデオAIは無料ですか?
ほとんどのプラットフォームで無料クレジットが提供されますが、本格的な利用は有料です。大量に処理する計画を立てる前に、現在の価格設定を確認してください。
自分だけのAI動画を作ってみませんか?
アイデア、テキストプロンプト、画像をSeedanceで洗練された動画に変えましょう。この記事が役立ったなら、次は実際に試すのが最短です。
登録で無料クレジット。プランは月額$28から。
関連記事
同じ言語で次に読みたい記事です。
Kling 4.0 vs Seedance 2.5: 徹底比較
Kling 4.0とSeedance 2.5をスペックで比較。長さ、10キーフレーム対50参照素材、音声、4Kと10-bitカラー、編集機能、用途別のおすすめを解説。
記事を読む
Kling 4.0 キーフレーム&Omni Reference 完全ガイド
Kling 4.0の10キーフレームと15個のOmni Referenceで30秒動画を設計する方法。3つの実践プラン、よくあるミス、Seedance 2.5との使い分けも紹介。
記事を読む
Kling 4.0 Flash vs Kling 4.0:主な違いを徹底比較
Kling 4.0 Flashとフル版の違いを解説。長さ、解像度、色、キーフレームを比較し、Flashで十分な場面と「Flashで下書き、フル版で仕上げ」の流れを紹介。
記事を読む