
AI Overview
FramePack は本当に 6GB の VRAM で動作しますか?
はい。公式プロジェクトでは、NVIDIA RTX 30・40・50 シリーズ GPU に対して、6GB を最低要件として明記しています。これは「高速な生成が保証される」ものではなく、「最低限動作する」目標値です。
Windows 向けの最も安全な FramePack インストール方法は何ですか?
公式のワンクリックパッケージを使用し、それをシンプルなローカルパス(例:D:\\FramePack)に展開します。その後、update.bat を実行し、続いて run.bat を実行します。最初のテストでは、デフォルトのアテンション設定および TeaCache 設定をそのまま使用してください。
FramePack で発生する CUDA のメモリ不足(Out-of-Memory)エラーをどう修正しますか?
他の GPU 利用アプリケーションをすべて終了し、プロセスを再起動します。デフォルトのワークフローでテストを実行し、システムメモリへの競合負荷を軽減します。効果を明確に測定できるよう、最適化は一度に 1 つだけ追加してください。
6GB GPU では TeaCache を有効にするべきですか?
クリーンなデフォルトレンダリングが成功した後のみ、ドラフト生成を高速化するために TeaCache を使用してください。公式ドキュメントでは、TeaCache が品質低下を引き起こす可能性があると警告しており、重要な最終出力にはフルディフュージョンを使用することを推奨しています。
6GB 対応の真の意味
FramePack は、動画長に比例して作業メモリが増大しないよう設計されています。フレームコンテキストのパッキングおよびドリフト防止型スケジューリングにより、モデルが順次ストリーミング処理を行う間も、アクティブな計算量は一定範囲内に抑えられます。この設計のおかげで、公式プロジェクトは、RTX 3060(ノートPC 搭載)および 6GB VRAM の環境で 13B モデルによる動画生成を実証しています。ただし、ワークフローのすべての部分が軽量になるわけではありません。モデルファイル自体は依然として 30GB を超えるディスク容量を必要とし、システム RAM や仮想メモリも高負荷になる可能性があり、長時間の生成には相当の時間がかかることがあります。
また、公式でサポートされるベースラインは明確に限定されています。公式 README では、NVIDIA RTX 30・40・50 シリーズ GPU(fp16 および bf16 をサポート)を搭載した Windows または Linux 環境が対象とされています。GTX 10・20 シリーズは明示的に「未検証」と記載されています。6GB の VRAM は、6GB のシステム RAM とは異なります。最低要件を満たしたからといって、実験的な量子化(quantization)、サードパーティ製ノード、すべてのアテンションカーネル、あるいは積極的なキャッシュ設定が互いに正しく動作することを保証するものではありません。
本 FramePack 6GB VRAM セットアップガイドは、1 つの「既知の良好なレンダリング結果」へ到達するための制御された手順としてご活用ください。まず、公式アプリケーション、公式モデル、およびデフォルト設定が正しく動作することを確認します。その後、変更点を 1 つずつ導入・測定することで、万が一失敗した場合でも、その原因が GPU のメモリ制限、実行環境、あるいは特定の最適化によるものかを正確に特定できます。
ベンチマーク画像ではありません。被写体が明瞭で、シルエットが読みやすく、背景が単純である静止画は、混雑したアクションシーンよりも、6GB 環境での初回テストに適しています。
Windows または Linux の準備
6 項目の事前チェックを実施
ダウンロードを開始する前に、以下の 6 つの項目を確認してください:
・対応済み NVIDIA RTX GPU(最低 6GB VRAM)の存在
・最新のドライバのインストール状況
・パッケージおよび依存関係、さらに 30GB を超える自動モデルダウンロード分を含む十分な空きディスク容量
・短いローカルインストールパス(例:D:\\FramePack)
・安定したネットワーク接続
・該当フォルダ内にファイルを作成する権限
最小限のメモリ構成のマシンでは、初回起動前にゲーム、3D ソフトウェア、GPU 加速を有効にしたブラウザタブ、その他のローカル AI サーバーをすべて終了させてください。
入力は控えめにしましょう。主な人物または物体が 1 つだけ写り、背景がシンプルで、動きが 1 文で説明可能な静止画を選択してください。初回実行は、環境の動作確認であり、最終的なクリエイティブな仕様書ではありません。ローカル環境の維持価値を判断する際は、単に宣伝されている VRAM 容量だけでなく、クラウド GPU ベンチマークとの総合的な比較をおすすめします。
Windows の場合、公式ワンクリックパッケージにはすでに CUDA 12.6 と PyTorch 2.6 が同梱されています。ベースラインが正常に動作する前に、別途 Python 環境を内部に追加しないでください。Linux の場合、既存の ComfyUI やシステム Python がパッケージを無意識に上書きしないよう、独立した Python 3.10 環境をご使用ください。この分離の原則は、こちらの ローカル AI 動画セットアップガイド にも同様に適用されています。ドライバのバージョン、インストールフォルダ、空きディスク容量を記録しておいてください。これらの 3 つの情報は、後のバグ報告において「停止しました」という曖昧な記述よりもはるかに有用です。
公式ソースから FramePack をインストール
Windows 向け:ワンクリック方式
公式 FramePack プロジェクトとして開発者によって指定されたリポジトリからのみダウンロードしてください。プロジェクトでは模倣サイトへの注意喚起が行われており、任意のパッケージを実行する前にリポジトリ所有者を必ず確認してください。アーカイブは完全に展開し、D:\\FramePack のような短いパスに配置してください。圧縮アーカイブ内や、深くネストされたクラウド同期フォルダ内から直接実行すると、回避可能なファイルアクセスおよび権限の問題が発生します。
update.bat を 1 回実行し、完了を待ってから run.bat を実行します。初回起動時は、大規模なモデルファイルのダウンロードおよび初期化のため、一見アイドル状態のように見えることがあります。ブラウザを何度も更新するのではなく、ターミナルの出力を観察してください。ウォームアップ中にプログレスバーが一時停止したからといって、中断しないでください。後続のアップデートで正常に動作していたインストールが破損した場合は、新しいコピーが同じ健全性チェック(sanity check)を通過するまで、最後に正常に動作していたフォルダを保持してください。
Linux 向け:環境構築方式
クリーンな Python 3.10 環境を作成し、これを有効化します。公式 PyTorch インデックスから CUDA 12.6 および PyTorch パッケージをインストールし、続いて FramePack の要件を満たすパッケージをインストールします。その後、python demo_gradio.py を起動します。この環境は FramePack 専用に保ち、大規模な ComfyUI 環境と混在させないでください。混在すると、pip が「成功」と報告しても、Torch、Triton、あるいはアテンション関連パッケージ間に相互に非互換な状態が発生しやすくなります。デフォルトのパスでは PyTorch アテンションが使用されます。FramePack はまた xformers、FlashAttention、および SageAttention をサポートしていますが、これらのサポートがあるからといって、すべてをインストールするよう指示しているわけではありません。最も明確な基準点であるデフォルトから始めましょう。同様の disciplined(厳密な)アプローチは、INT8 と INT4 エンコーダーの選択肢の比較においても有効です:最終出力が依然として品質審査を通過するのであれば、Footprint(リソース占有量)の削減は有用です。
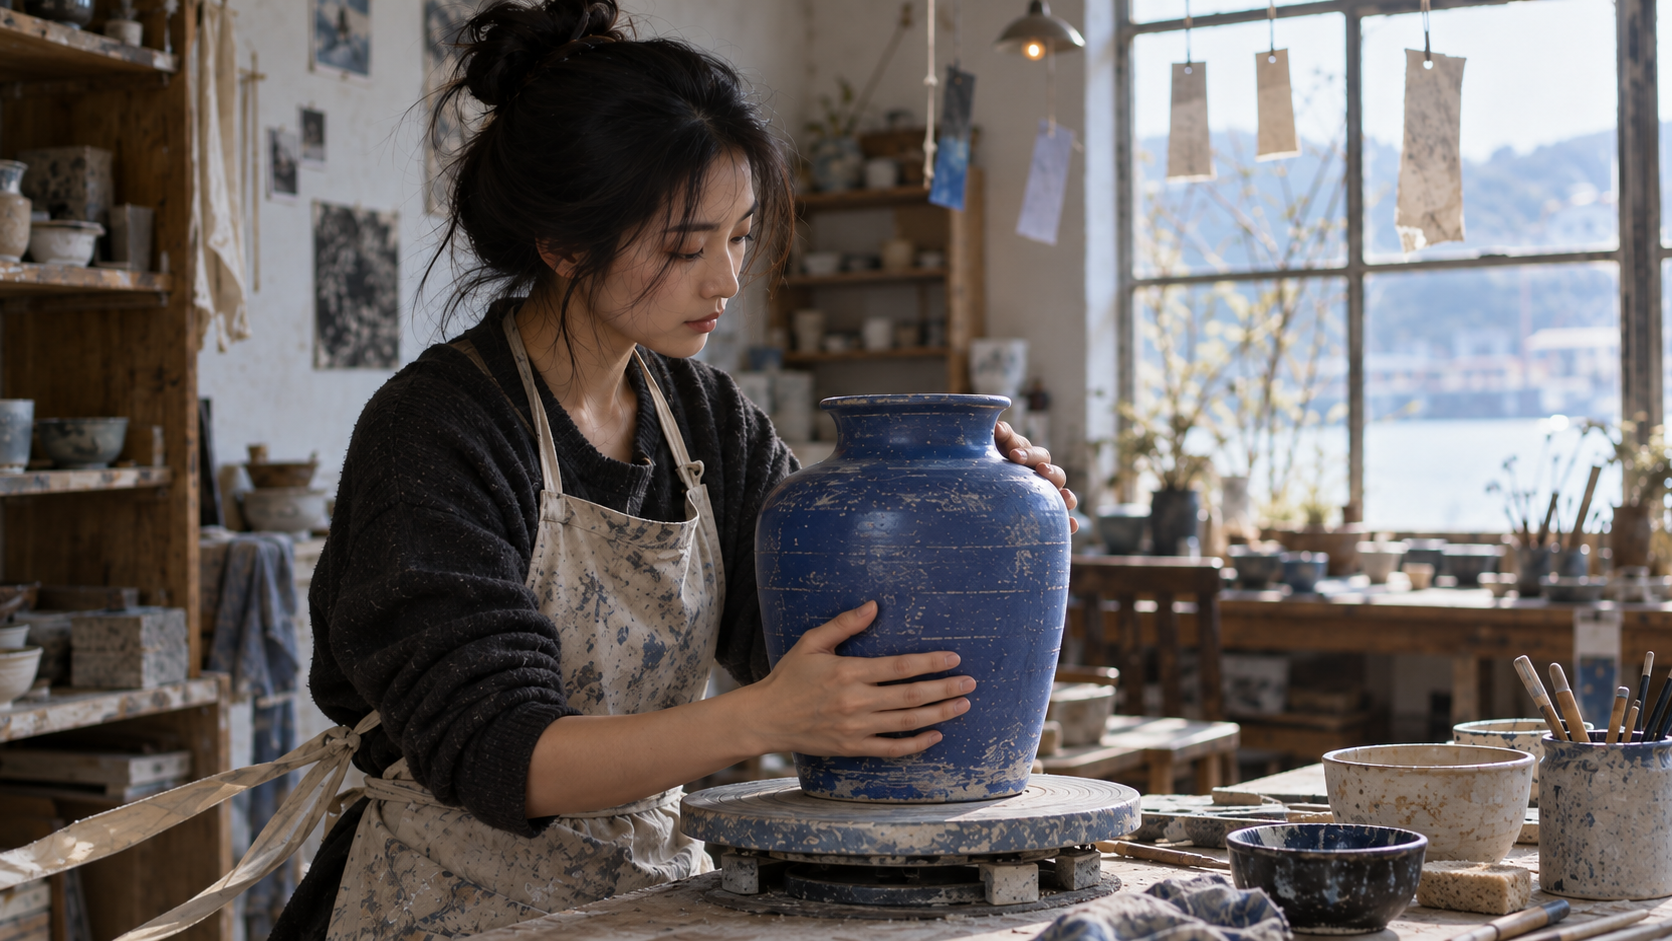
参考用の最初のフレーム候補。環境を変更する前に、この画像、プロンプト、シード値、および設定を保存しておき、各テストで安定した視覚的基準を確保してください。
6GB サニティチェックを実行する
変数を固定する
公式のデフォルト設定を使用し、TeaCache は無効のままにし、最初のレンダリングでは SageAttention、bits-and-bytes 量子化、および GGUF を避けます。本プロジェクトでは、このデフォルト構成を「サニティチェック」と呼びます。事前に準備された画像を読み込み、被写体と動きを優先する簡潔なモーション・プロンプトを作成します。例:「陶芸家がコバルト色の花瓶をゆっくりと時計回りに回転させ、窓からの光で釉薬を確認し、両手を静止させて停止する;カメラは固定されたまま」。
4つのカラム(ビルドと環境、入力とプロンプト、変更された設定、結果)を持つ小さなテスト記録を保存します。1行目には「公式デフォルト;変更なし」と記載します。アプリがモデルを正常に読み込み、サンプリングを開始し、再生可能なファイルを生成し、基本的な被写体を保持できた場合にのみ、この実行は合格とみなされます。速度は二次的な評価項目です。6GB のGPUカードでは、「成功したが遅い」という結果は、環境が正しく動作しているという証拠になります。一方、「即座にクラッシュする」という結果は、モデルが原理的に不可能であるという証拠にはなりません。
ウォームアップにより、開始部分が後続のセクションよりも遅く見えることがあります。診断を行う前に、ターミナルが明示的な完了またはエラー状態に達するまで待ちます。出力全体を再生し、被写体のドリフト(ずれ)、シーンの置き換え、動きの停止、あるいは最終秒の破損がないかを確認します。「再生可能ではあるが品質が低い」ファイルは創造的な成果物であり得ますが、CUDA 例外はシステム障害です。
これは公式プロジェクトページから実際に取得した FramePack の出力であり、Seedance レンダリングでもなければ、速度保証でもありません。その目的は、公開されている6GBルートが連続したモーションを生成できることを実証することです。
失敗を隠さずに速度を最適化する
ドラフト→ファイナルの段階的アプローチを採用する
デフォルト実行が成功したら、3段階のラダー(段階的アプローチ)を作成します。ステップ1は、一切変更されていない品質基準です。ステップ2では、アイデア探索のために TeaCache などの1つの速度向上機能を有効にします。ステップ3では、選択された最終カットに対してフルディフュージョンを再適用します。各ステップで、同一の入力、プロンプト、および概ね同じ長さの出力を比較します。壁時刻(実測時間)、利用可能な場合はピーク VRAM、視覚的欠陥、および結果が許容可能かどうか(単に「より速いかどうか」ではなく)を記録します。
公式ガイドラインでは、TeaCache が一部のユーザーにおいて結果を悪化させる可能性があると明記されており、最終品質ではなくアイデア試行に推奨されています。同様の注意喚起が SageAttention、bits-and-bytes 量子化、および GGUF に対しても行われています。これらのオプションは有用ですが、複数を重ねると制御を失います:手の形が歪んだり、テクスチャがパルス状に変化したりした場合、どのショートカットが原因か特定できなくなります。1つだけ追加し、1度だけレンダリングを行い、保存済みの基準画像の方が優れていると判断された場合には直ちに元に戻すようにしてください。
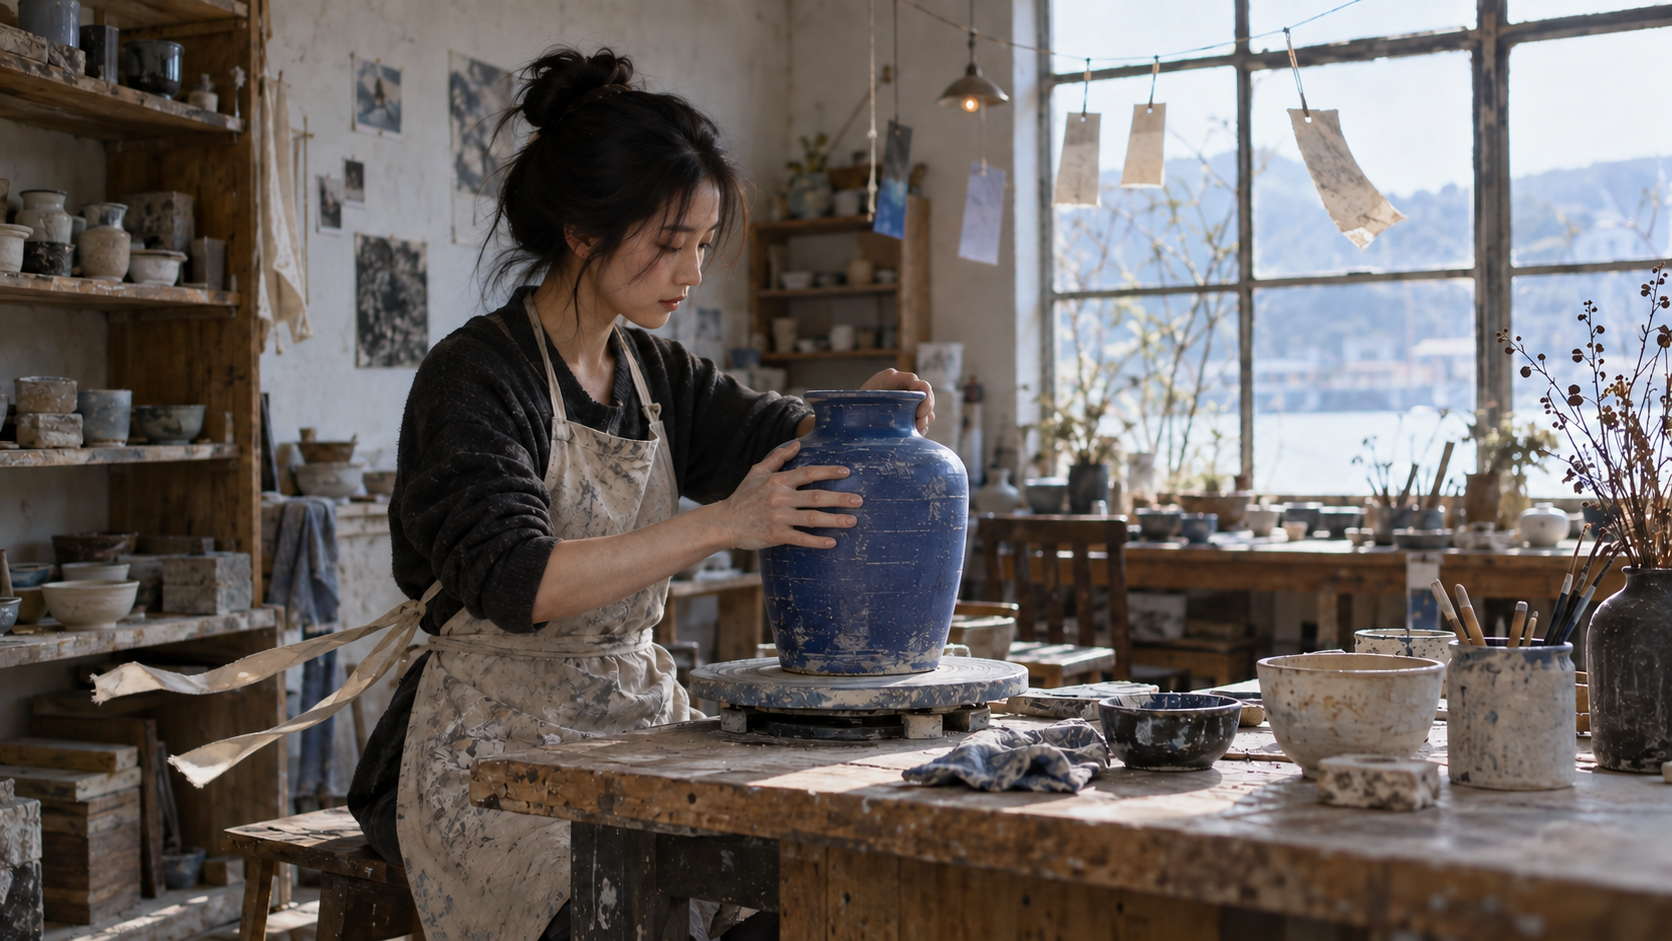
参考用のモーション目標。花瓶の形状、顔、手、スタジオの線を保存済みの最初のフレームと比較してください。これらのアンカー(基準要素)がドリフト(ずれ)した場合、速度向上は勝利とは言えません。
プロンプトの経済性も重要です。FramePack 自体の推奨は、簡潔でモーションに焦点を当てた言語の使用です。被写体、主なアクション、および1つのカメラ挙動を明記します。矛盾するレンズ変更、衣装の変化、シーンカットなどを含む長文のプロンプトは避けてください。複数の明確に異なるショットが必要な場合は、画像から動画へ(image-to-video)のワークフローを通じてそれぞれを個別に計画・承認し、その後で結果を編集してください。1回の生成は、1つの可視的なビート(動きの単位)を解決すべきです。
低 VRAM 環境における問題のトラブルシューティング
ランダムなチェックリストではなく、失敗の兆候に従って対応する
アプリケーションがそもそも起動しない場合、最初のターミナルエラーを確認し、不足しているパッケージ、非対応GPU、または破損したダウンロードがないかを調べます。いくつかのライブラリを盲目的にパッチする代わりに、公式アップデーターを再実行するか、クリーンなフォルダに再インストールしてください。モデルの読み込みが始まり、その後で失敗する場合、空きディスク容量、システムメモリの圧迫状況、ページファイルまたはスワップ領域の可用性を確認します。競合するプロセスを終了し、マシンを再起動してから、モデルの変更を検討してください。サンプリングが始まり、その後 CUDA のメモリ不足例外が発生する場合、他のGPUプロセスがメモリを保持していないかを確認し、公式デフォルトテストを再度実行してください。
オプションのカーネルのみが失敗する場合、そのカーネルを削除し、PyTorch アテンションに戻ります。現在のドライバおよびGPU上で実行できない最適化は、FramePack そのものにとって必須ではありません。生成が完了した後にUIがフリーズする場合、その症状を CUDA メモリ関連の問題とは分離し、生成後のフリーズ診断(post-generation freeze diagnosis)に従って対応してください。最後の1行だけでなく、ターミナル出力の完全なメッセージをキャプチャし、再現可能な入力および設定を保存しておいてください。遅いが成功する実行の場合、実際に時間が納品を妨げているかどうかを判断します。6GB のローカル GPU は、一晩かけての探索には適していますが、締め切りがある場合、共同作業が必要な場合、あるいは多数のバリエーションを試す場合には、ホスティングされたワークフローの方が適しています。Seedance Agent は別の本番導入ルートを提供します:参照素材を整理し、ショットを計画し、実際の出力をレビューして、失敗した部分のみを再実行する——ローカルの依存関係スタックを維持する必要はありません。これは、あるモデルが FramePack を置き換えるという主張ではありません。むしろ、環境を自前で所有することと、マネージドなワークフローを購入することとの比較です。
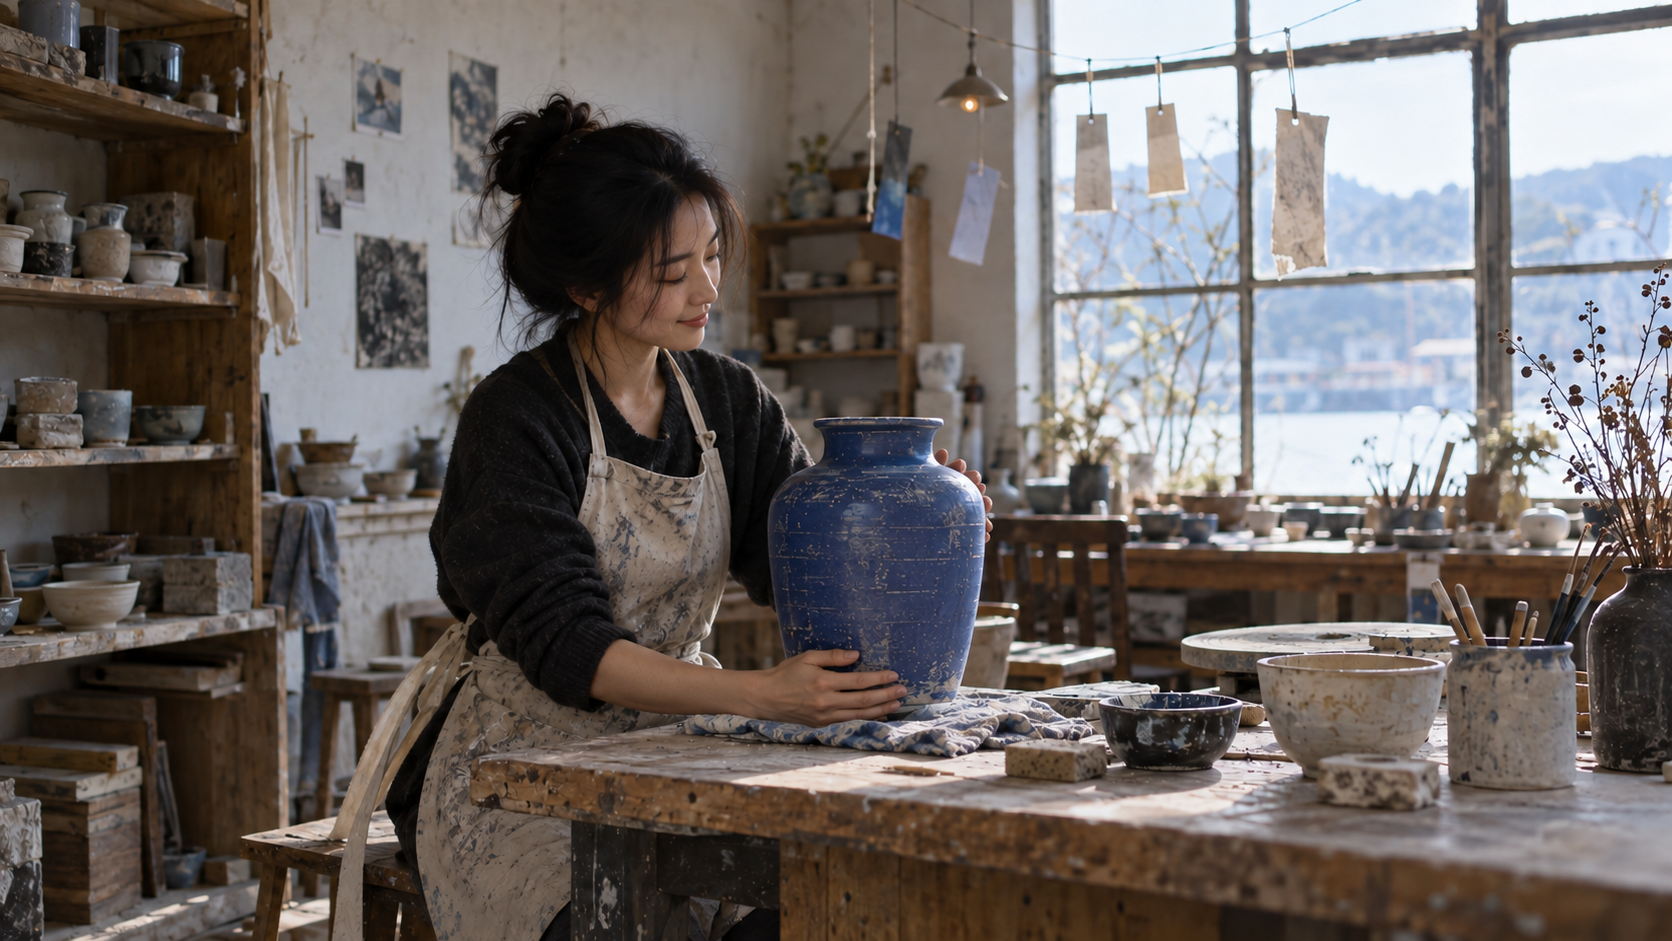
例示的な最終承認用フレーム。実行を完了と判断する前に、同一性、花瓶の形状、照明、背景の一貫性について、開始時のフレームと比較してください。
結論
信頼性の高い FramePack 6GB VRAM 設定は、公式パッケージ、対応済みの RTX GPU、十分なディスク容量およびシステムメモリ、単一のシンプルなソース画像、デフォルトの PyTorch アテンション、および無効化された TeaCache から始めます。キャッシュ、代替アテンションカーネル、または量子化を追加する前に、まずこのベースラインを検証してください。各変更は、保存済みの同一入力およびフル動画によるレビューと比較して測定します。6GB は実用可能な最小限の容量となり得ますが、真の判断ポイントは、ローカルでの生成時間および依存関係のメンテナンスがプロジェクトに適合するかどうかです。もし、ショットの計画、参照素材の制御、出力のレビューを、1 つのマネージドなパスで行いたいのであれば、Seedance Agent で次の動画を開始してください。
自分でも試してみますか?
このガイドの手順をSeedanceでそのまま試し、プロンプトや画像を数分で完成度の高い動画に変えましょう。
登録で無料クレジット。プランは月額$20から。
Google Vids スライドから動画へ:プレゼンテーションを公開可能な動画に変換
Google スライドを Google Vids のシーンに変換し、スピーカーノートとオプションの Gemini 音声解説を活用して、静的なスライドを動きのあるものに置き換え、公開可能な完成動画をエクスポートします。
記事を読む
MiniMax H3 動画広告向けプラスチック肌の修正:リアリズム作業フロー
より適切な参照画像、自然なライティング、制御されたプロンプト、モーションのレビュー、および明確な「再生成するか完了するか」チェックリストを用いて、MiniMax H3 動画広告におけるプラスチックのような肌質を修正します。
記事を読む
VEED オート字幕(無料):公開可能な字幕を作成する実践ガイド
無料プランで VEED のオート字幕機能を活用し、字幕のタイミングとスタイルを修正し、ウォーターマークおよび SRT 制限について理解し、Seedance を使って字幕対応動画を準備します。
記事を読む