
MiniMax H3-Zwei-Personen-Video-Workflow: Rollen, Dialog und Bewegung klar halten
AI Overview
Kann MiniMax H3 zwei Personen in einem Video generieren?
Ja. H3 kann mehrere Charaktere inszenieren, doch jede Person benötigt eine klare Identität, Position, Aktion und Sprechrolle. Eine kurze Szene mit einer einzigen Interaktion ist zuverlässiger als ein überladener Prompt mit mehreren gleichzeitigen Bewegungen.
Wie verhindert man, dass sich zwei Charaktere ihre Identitäten austauschen?
Weisen Sie stabile Bezeichnungen wie Subject 1 und Subject 2 zu, geben Sie jedem eine eindeutige Kleidung und Bildposition und wiederholen Sie ausschließlich die Merkmale, die unbedingt erhalten bleiben müssen. Verwenden Sie separate Referenzbilder, wenn hohe Identitätstreue erforderlich ist.
Wie sollte ein Dialog zwischen zwei Personen in MiniMax H3 formuliert werden?
Geben Sie den Sprechern stabile IDs wie S1 und S2 und nennen Sie vor jeder Zeile, wer spricht. Platzieren Sie innerhalb des Dialog-Tags ausschließlich die exakten gesprochenen Wörter. Geben Sie an, dass der Zuhörer den Mund geschlossen hält.
Welcher H3-Modus eignet sich am besten für eine Szene mit zwei Charakteren?
Verwenden Sie den Text- oder First-Frame-Modus für eine einfache, frei erfundene Szene, den First-and-Last-Frame-Modus für einen kontrollierten Übergang und den Full-Reference-Modus, wenn separate Bilder, Bewegungsdaten oder Sprachressourcen die beiden Personen definieren müssen.
Wählen Sie den richtigen H3-Modus für zwei Personen
Lassen Sie die strengste Einschränkung die Eingabemethode bestimmen
Ein MiniMax H3-Two-Person-Video-Workflow beginnt bereits vor dem Schreiben des Prompts. Entscheiden Sie, was kontrolliert werden muss. Text-to-Audio-Video reicht aus, wenn beide Charaktere frei erfunden werden können. Ein erster Frame hilft, wenn Zusammensetzung, Kleidung und relative Positionen am Anfang bereits entscheidend sind. Der First-and-Last-Frame-Modus ist nützlich, wenn eine einzelne Interaktion auf einem festgelegten Endzustand landen muss – etwa wenn eine Person einer anderen einen Koffer übergibt.
Der Full-Reference-Modus ist die bessere Wahl, wenn Charakter A und Charakter B aus unterschiedlichen Identitätsbildern stammen, wenn ein separates Video die Körperbewegung vorgibt oder wenn Sprachreferenzen relevant sind. MiniMax unterstützt bis zu neun Referenzbilder, drei Videos und drei Audio-Clips – insgesamt zwölf Referenzdateien. Referenz-Audio darf nicht die einzige Eingabe sein; es muss stets von einem Bild oder Video begleitet werden. Mischen Sie Aufgaben mit Frame-Control und Full-Reference nicht in einer einzigen Anfrage.
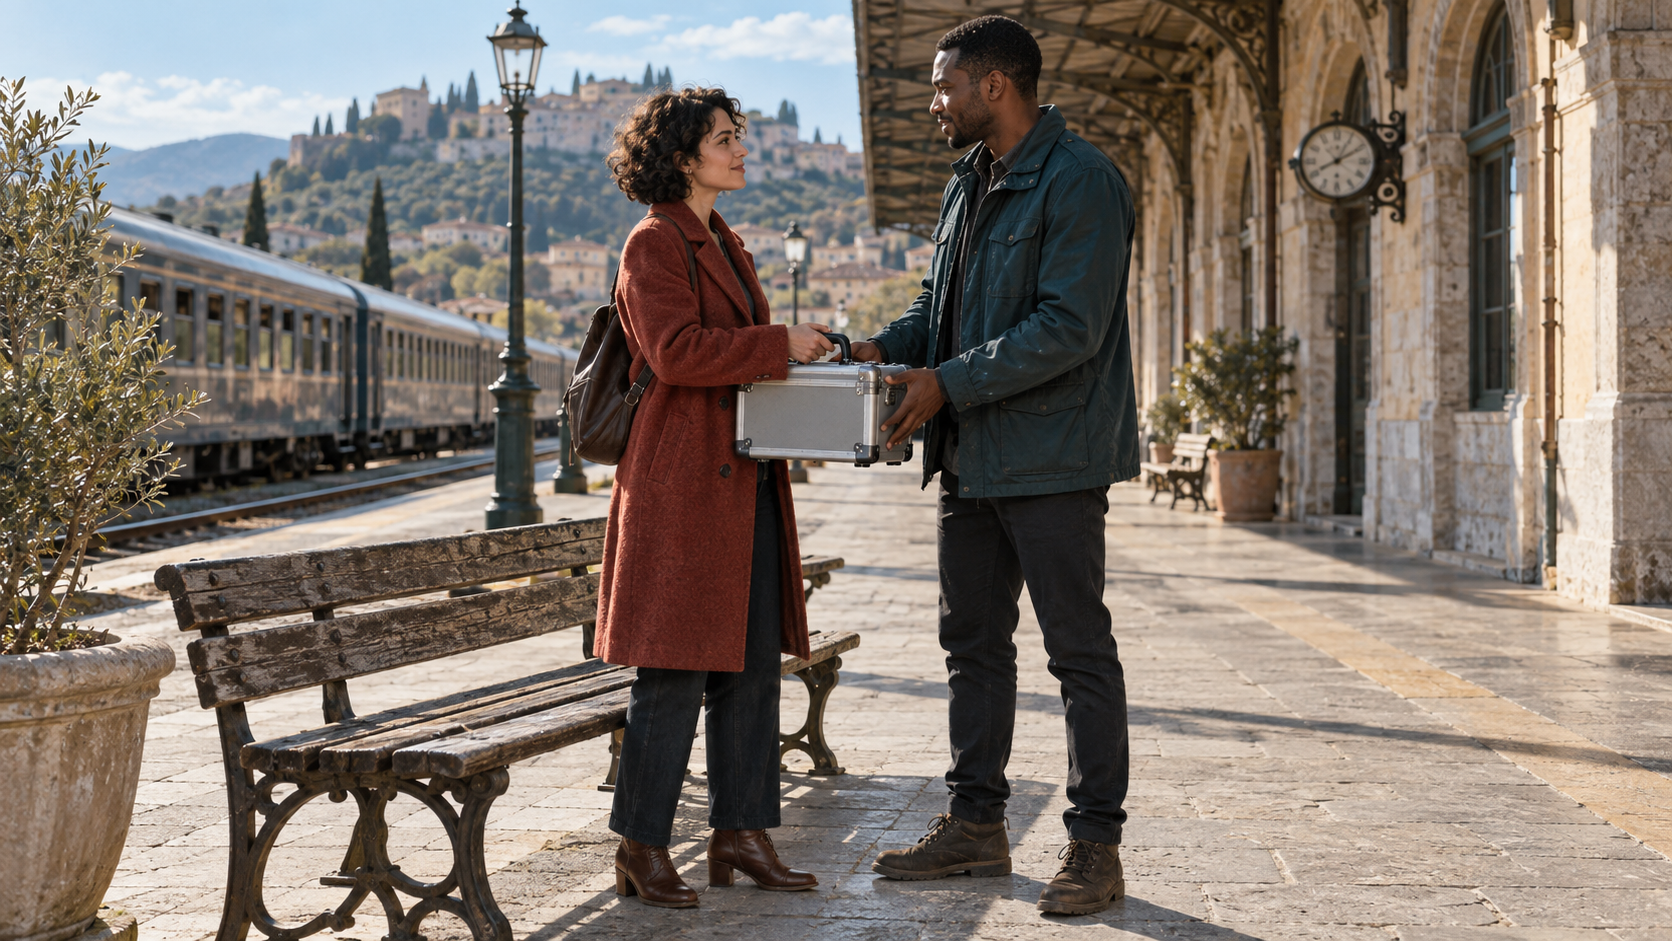
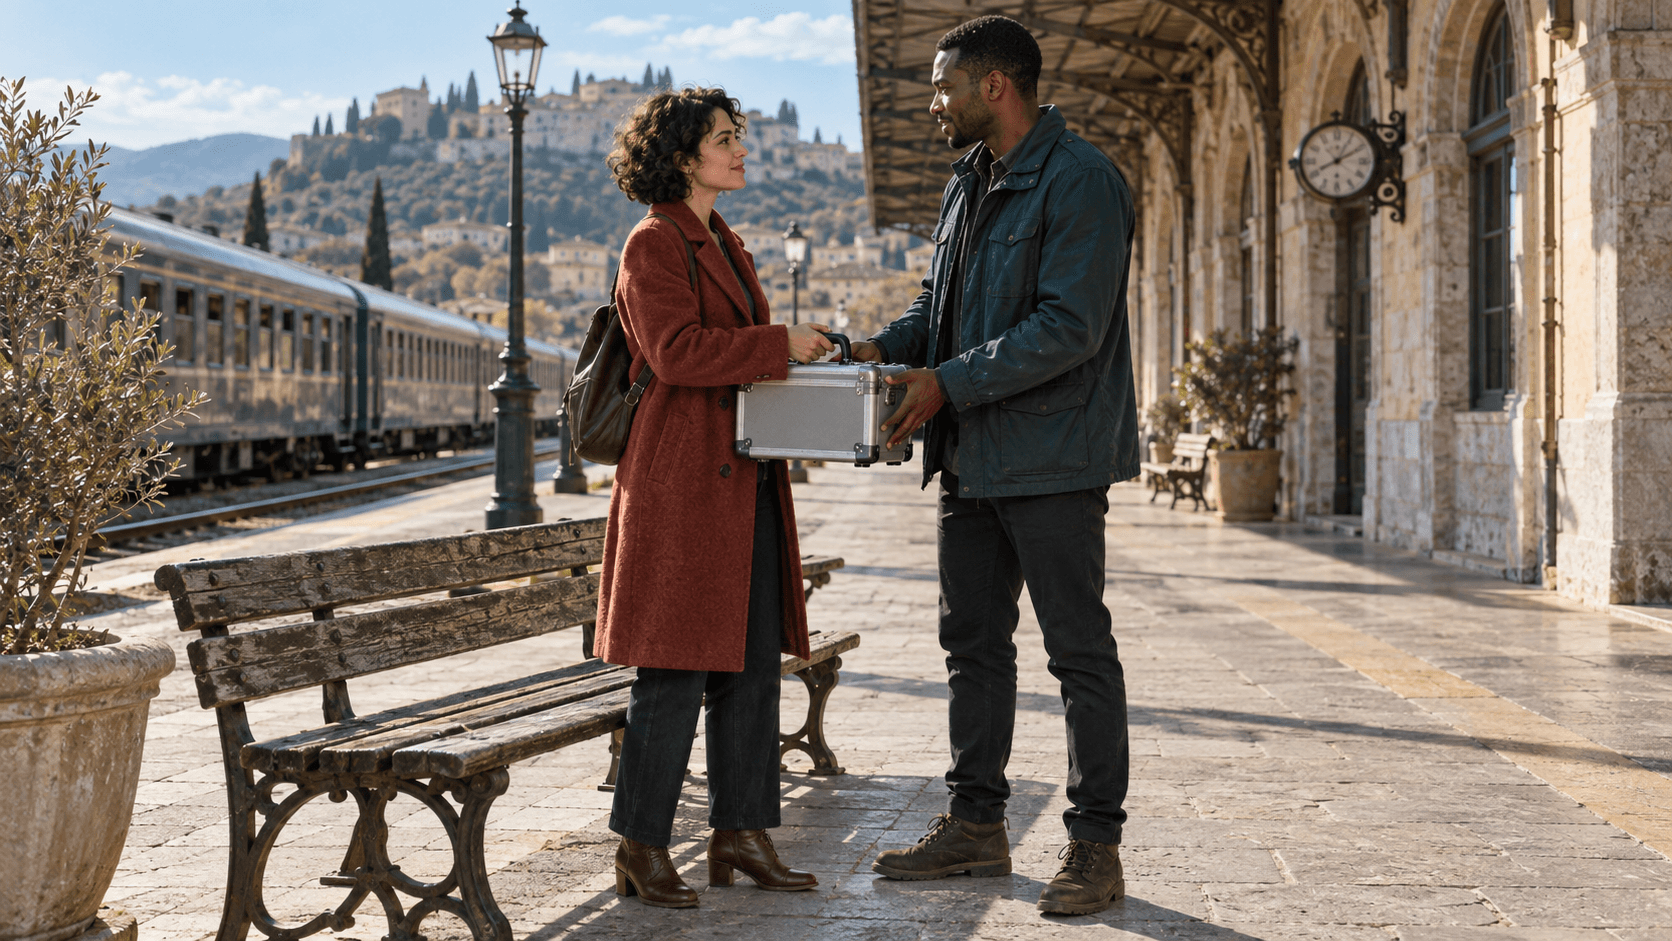
Illustratives generiertes Referenz-Frame: zwei unterschiedliche Mäntel, getrennte Silhouetten, ein fester Steig und ein gemeinsames Requisit schaffen nachvollziehbare Kontinuitätsanker.
Nutzen Sie die Dauer als „Aktionsbudget“. H3 unterstützt 4–15 Sekunden, doch 15 Sekunden bedeuten nicht, mehr Handlung unterzubringen. Geben Sie zwei Personen einen kausalen Handlungsabschnitt: Annähern, Austauschen und Beruhigen; Fragen, Antworten und Reagieren; oder Betreten, Wahrnehmen und Verlassen. Falls die Szene einen zweiten Ort oder eine weitere bedeutende Aktion benötigt, erstellen Sie einen neuen Clip und verbinden Sie ihn über einen fortsetzbaren Multishot-Workflow.
Definieren Sie Subject 1 und Subject 2
Erstellen Sie eine kompakte Identitäts- und Blocking-Karte
Formulieren Sie die beiden Charaktere als getrennte Produktionsunterlagen, bevor Sie die Timeline schreiben. Jede Karte benötigt eine sichtbare Identität, Kleidung, Ausgangsposition, Requisit-Zuordnung, Bewegungseinschränkung, Sprecher-ID und Referenzquelle. Unterschiede sollten auf einen Blick erkennbar sein; „zwei Personen in dunklen Jacken“ lädt zur Mehrdeutigkeit ein.
| Steuerung | Subject 1 | Subject 2 |
|---|---|---|
| Identität | Frau, Anfang 30, kurze dunkle Locken | Mann, Mitte 30, kurz geschnittenes Haar |
| Kleidung | Rostroter Wollmantel, braune Stiefel | Tieftürkiser Feldmantel, dunkle Stiefel |
| Startposition | Links im Bild, neben einer Bank | Rechts im Bild, nahe der Stationswand |
| Requisit-Zustand | Hält den Koffergriff | Stützt den Kofferkörper |
| Sprecher-ID | S1 | S2 |
| Bewegungseinschränkung | Ein Schritt nach vorn, löst den Griff | Nimmt den Koffer entgegen, tritt zurück |
Im Full-Reference-Modus definieren Sie, welchen Beitrag jede Ressource leistet. Eine Subjektbezeichnung steht für wiederverwendbare sichtbare Inhalte, während die Labels „Picture“, „Video“ und „Audio“ Quellmedien oder strukturelle Referenzen identifizieren. Nennen Sie das gesamte erste Bild nicht einfach Subject 1, wenn es zwei Personen und einen Ort enthält. Stattdessen geben Sie an, dass Subject 1 die Frau aus Bild 1 und Subject 2 der Mann aus Bild 2 ist; definieren Sie den Bahnhofssteig separat nur dann, wenn er aktiv wiederverwendet werden muss.
subject_definitions:
<Subject 1> ist die Frau aus <Picture 1>, wobei ihre kurzen dunklen Locken, ihr rostroter Mantel, ihr Gesicht und ihre braunen Stiefel erhalten bleiben.
<Subject 2> ist der Mann aus <Picture 2>, wobei sein kurz geschnittenes Haar, sein tieftürkiser Mantel, sein Gesicht und seine dunklen Stiefel erhalten bleiben.
<Subject 3> ist der kleine silberne Gerätekoffer aus <Picture 3>, wobei Größe, Griff, Verschlüsse und gebürstete Metalloberfläche erhalten bleiben.
Vermeiden Sie es, ein Gesicht in späteren Shots anders zu beschreiben. Stabile Bezeichnungen reduzieren Konkurrenz zwischen Adjektiven und Referenzen. Für Szeneanker, die auch bei Blickwinkelwechseln bestehen bleiben müssen, zeigt der MiniMax H3-Leitfaden zur Umgebungskonsistenz, wie Architektur, Lichtrichtung, Möbel und Hintergrundobjekte benannt werden – ohne den Prompt in einen Katalog zu verwandeln.
Blocken Sie die Interaktion und die Requisit-Übergabe
Beschreiben Sie Zustandsänderungen, nicht nur Absichten
„Sie tauschen den Koffer natürlich aus“ verschleiert die schwierigsten Frames. Beschreiben Sie den Objektzustand in Wiedergabereihenfolge: Subject 1 hält den Griff; Subject 2 legt beide Hände unter den Koffer; beide stützen ihn kurz; Subject 1 öffnet ihre Finger und zieht sie zurück; Subject 2 tritt mit dem Koffer zurück; beide nehmen ihre Endposition ein. Das Modell erhält so einen beobachtbaren Pfad statt einer vagen sozialen Handlung.
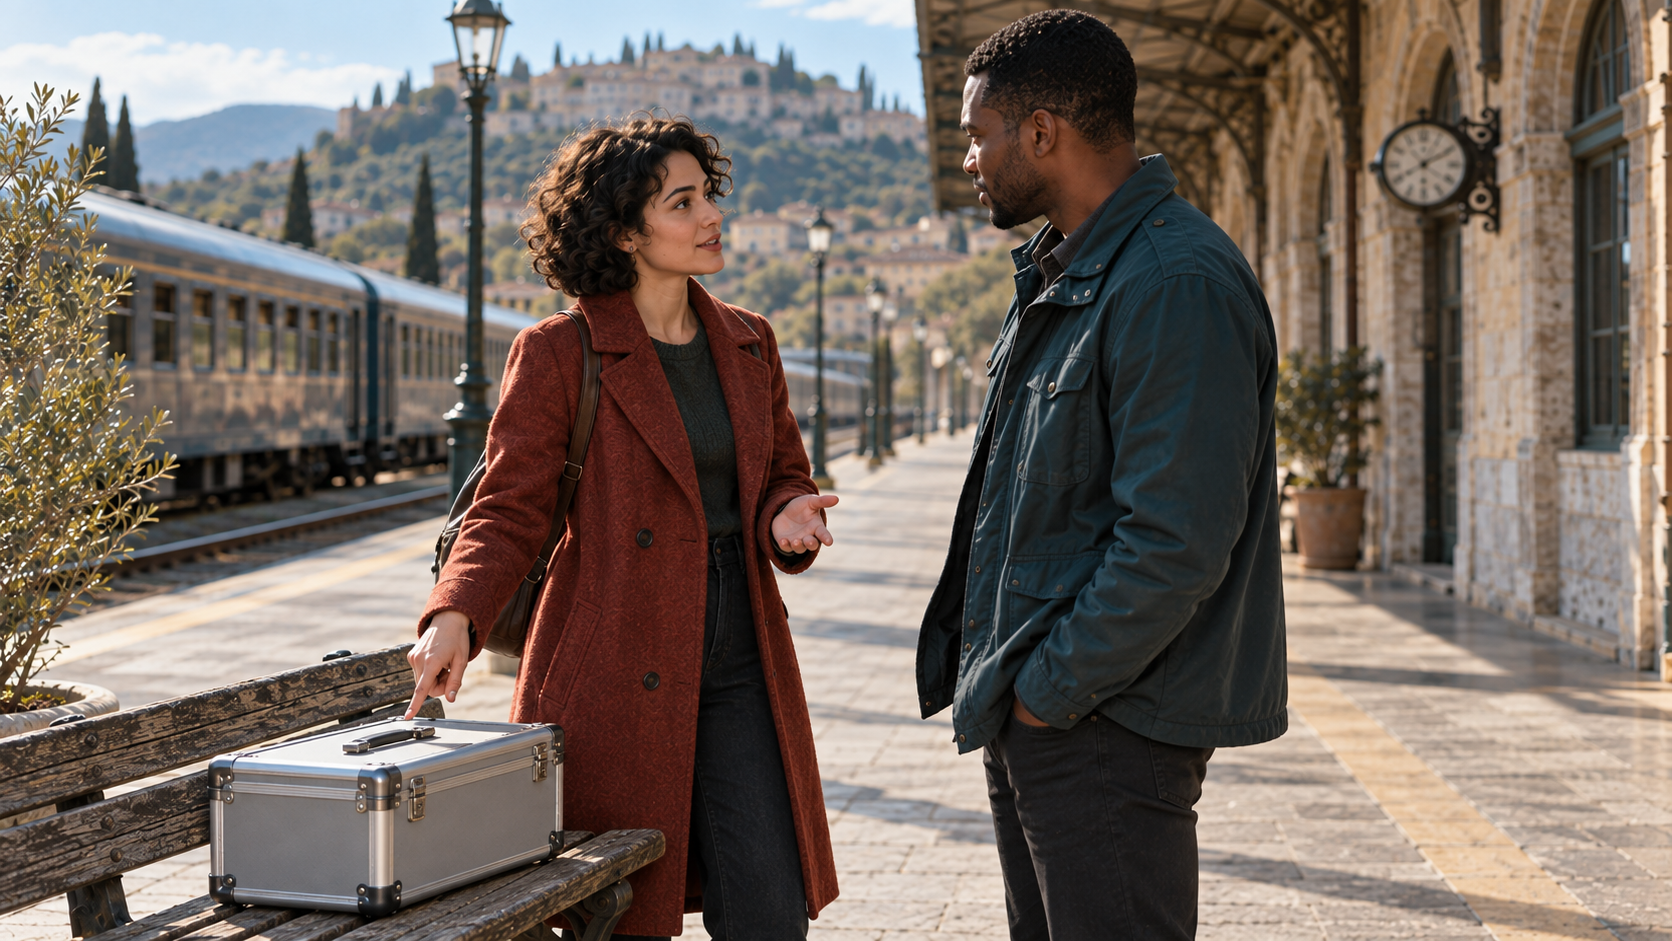
Illustrativer generierter Blocking-Frame: Die Sprecherin führt die Geste aus, die Zuhörerin hat eine klare Blickrichtung, und der Koffer befindet sich an einer stabilen Position vor der Übergabe.
Halten Sie die räumliche Sprache konsistent. „Bildschirm links“ und „Bildschirm rechts“ beziehen sich auf die Kamera; Ausdrücke wie „in der Nähe der Gleise“ oder „in der Nähe der Stationswand“ sind bei einem Wechsel der Blickrichtung robuster. Wenn ein Schnitt die Orientierung ändert, stellen Sie beide Personen vor der nächsten Aktion erneut dar. Verwenden Sie jeweils nur eine Kamerabewegung – etwa eine langsame Annäherung an das Paar – statt mehrere Bewegungen wie eine Kreisfahrt, ein Zoom, eine Panoramaaufnahme und ein wackelnder Handkameraeffekt zu kombinieren.
Hände scheitern, wenn beide Personen sich gegenseitig durchgreifen oder der Prompt eine Kontaktphase überspringt. Geben Sie dem Koffer ausreichend Größe für zwei gut erkennbare Griffpositionen, verhindern Sie, dass einer der Körper den anderen kreuzt, und lassen Sie den Austausch mehrere Sekunden dauern. Ein sauberes Ende ist entscheidend: Identifizieren Sie, wer den Koffer besitzt, wo jede Person steht, wohin sie schaut und ob einer der Münder sich bewegt.
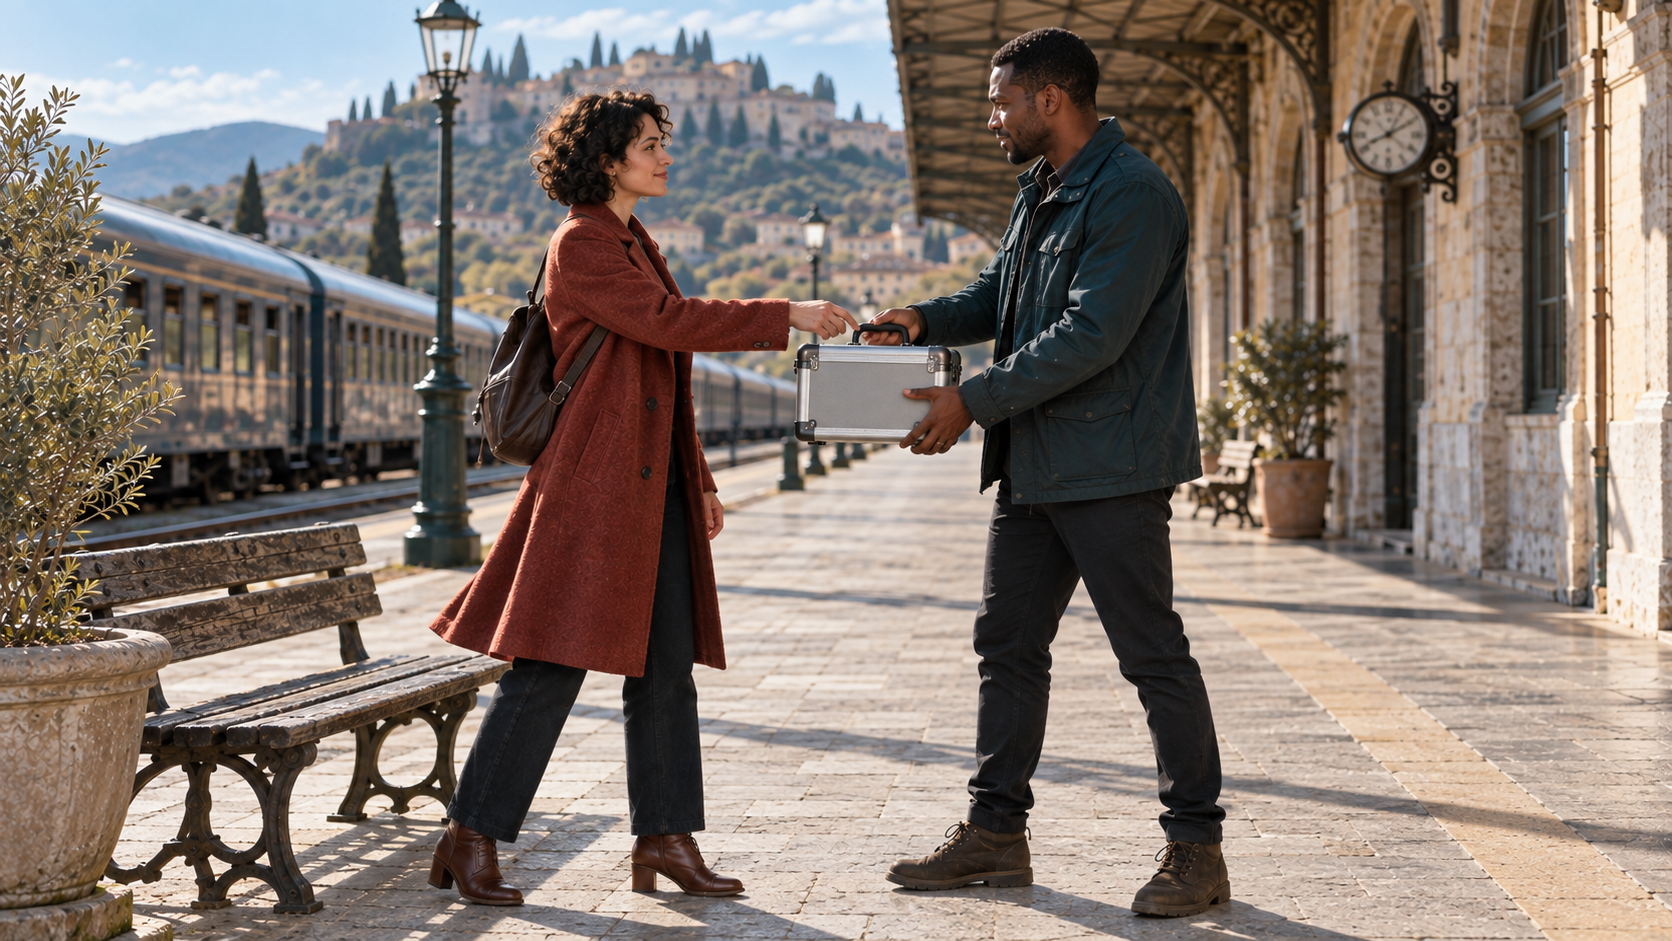
Illustrativer generierter Aktionsframe: Prüfen Sie den Abstand der Hände, die Geometrie des Requisits, die Kontinuität der Mäntel sowie das Fehlen eines zusätzlichen Arms während des gemeinsamen Kontakts.
Steuern Sie Dialog und Ton zwischen zwei Sprechern
Weisen Sie jeder gesprochenen Zeile und jedem Zuhör-Moment eine Rolle zu
Die offizielle Basisanleitung von MiniMax verwendet stabile Sprecher-IDs wie S1 und S2. Platzieren Sie die identifizierende Beschreibung, die Sprecher-ID, die Sprechweise und die Aktion außerhalb des Dialog-Tags; innerhalb des Tags belassen Sie ausschließlich den Sprach-Tag und den exakten gesprochenen Text. Wenn beide Personen gleichzeitig sprechen, wird eine zusammengesetzte ID wie S1,S2 unterstützt; überlappende Dialoge stellen jedoch eine schwierigere erste Herausforderung dar als abwechselnde Zeilen.
Die Frau im rostrot gefärbten Mantel (S1) blickt auf den Koffer und sagt leise: <d>[English] Keep this with you until the next stop.</d> Subject 2 hört zu, und ihre Lippen bleiben geschlossen.
Der Mann in der türkisfarbenen Jacke (S2) nimmt den Koffer entgegen, trifft ihren Blick und antwortet: <d>[English] I understand.</d> Subject 1 hört zu, und ihre Lippen bleiben geschlossen.
Verwenden Sie kurze Zeilen, die zum sichtbaren Bildausschnitt passen. Geben Sie an, wann die Sprache endet, wann der Kiefer sich schließt und wann die Zuhörerin reagiert. Halten Sie Umgebungsgeräusche der Plattform, Schritte, Klicks der Kofferverriegelung und Stoffbewegungen in der Gesamtklanglandschaft fest, statt sie als Teil des Dialogs zu wiederholen. Platzieren Sie Musik, die ausschließlich für das Publikum bestimmt ist, im Feld für nicht-diegetische Musik. Falls ein Voiceover außerhalb des Bildes gehört wird, kennzeichnen Sie es explizit als „Off-Screen-Voiceover“ und halten Sie die Lippen der im Bild sichtbaren Person geschlossen.
Tatsächliche Seedance-Ausgabe, kein MiniMax H3-Ergebnis: Verwenden Sie einen kontrollierten Einzelsprecher-Clip als Referenz für Mundbewegung, Timing und Raumton, bevor Sie einen komplexeren Dialog zwischen zwei Personen bewerten.
Für wiederkehrende Stimmen über mehrere Clips hinweg bietet der Seedance-Stimmkonsistenz-Leitfaden eine systematische Hörprüfung hinsichtlich Klangfarbe, Sprechtempo, Lautstärke, Raumton und Trennschärfe zwischen den Sprechern.
Entwickeln Sie einen Drei-Aufnahmen-Kontinuitätsplan
Stellen Sie sicher, dass jeder Schnitt einen festgelegten Zustand übernimmt
Drei kurze Aufnahmen genügen für viele Szenen mit zwei Personen. Aufnahme 1 stellt beide Protagonisten, die Plattform und den anfänglichen Besitz des Koffers dar. Aufnahme 2 nähert sich für die Übergabe und enthält je eine Zeile pro Sprecher. Aufnahme 3 bestätigt den neuen Eigentümer des Requisits und zeigt beiden Charakteren eine ruhige Reaktion. Geben Sie jeder Aufnahme einen Startzustand, eine Aktion, ein Kameraverhalten, einen Ton und einen festgelegten Endzustand vor.
Das Ende von Aufnahme 1 muss dem Beginn von Aufnahme 2 entsprechen. Falls der Koffer beim Schnitt auf der Bank liegt, darf er im ersten Frame der nächsten Aufnahme nicht plötzlich in Subject 2s Händen erscheinen, ohne dass ein sichtbarer Griffvorgang gezeigt wird. Falls Subject 1 seitlich der Gleise steht, drehen Sie sie nicht einfach zur Stationswand um, es sei denn, der Schnitt und die Kameraorientierung erklären diese Änderung eindeutig. Der MiniMax H3-Multi-Keyframe-Workflow zeigt, wie man geordnete Frames einer Master-Zeitleiste zuweist, ohne sie als vertikale Storyboard-Collage zu behandeln.
Die Basisanleitung von H3 erlaubt präzise Schnittzeitpunkte nach Aufnahme 1. Verwenden Sie sie nur dann, wenn sie hilfreich sind, und halten Sie die Zeitintervalle kontinuierlich. Ein praktikabler 12-Sekunden-Plan sieht vor: 0–4 Sekunden für die Einführung, 4–9 Sekunden für den Austausch und 9–12 Sekunden für die abschließende Haltephase. Die letzten beiden Sekunden sollten keine neue Aktion einführen.
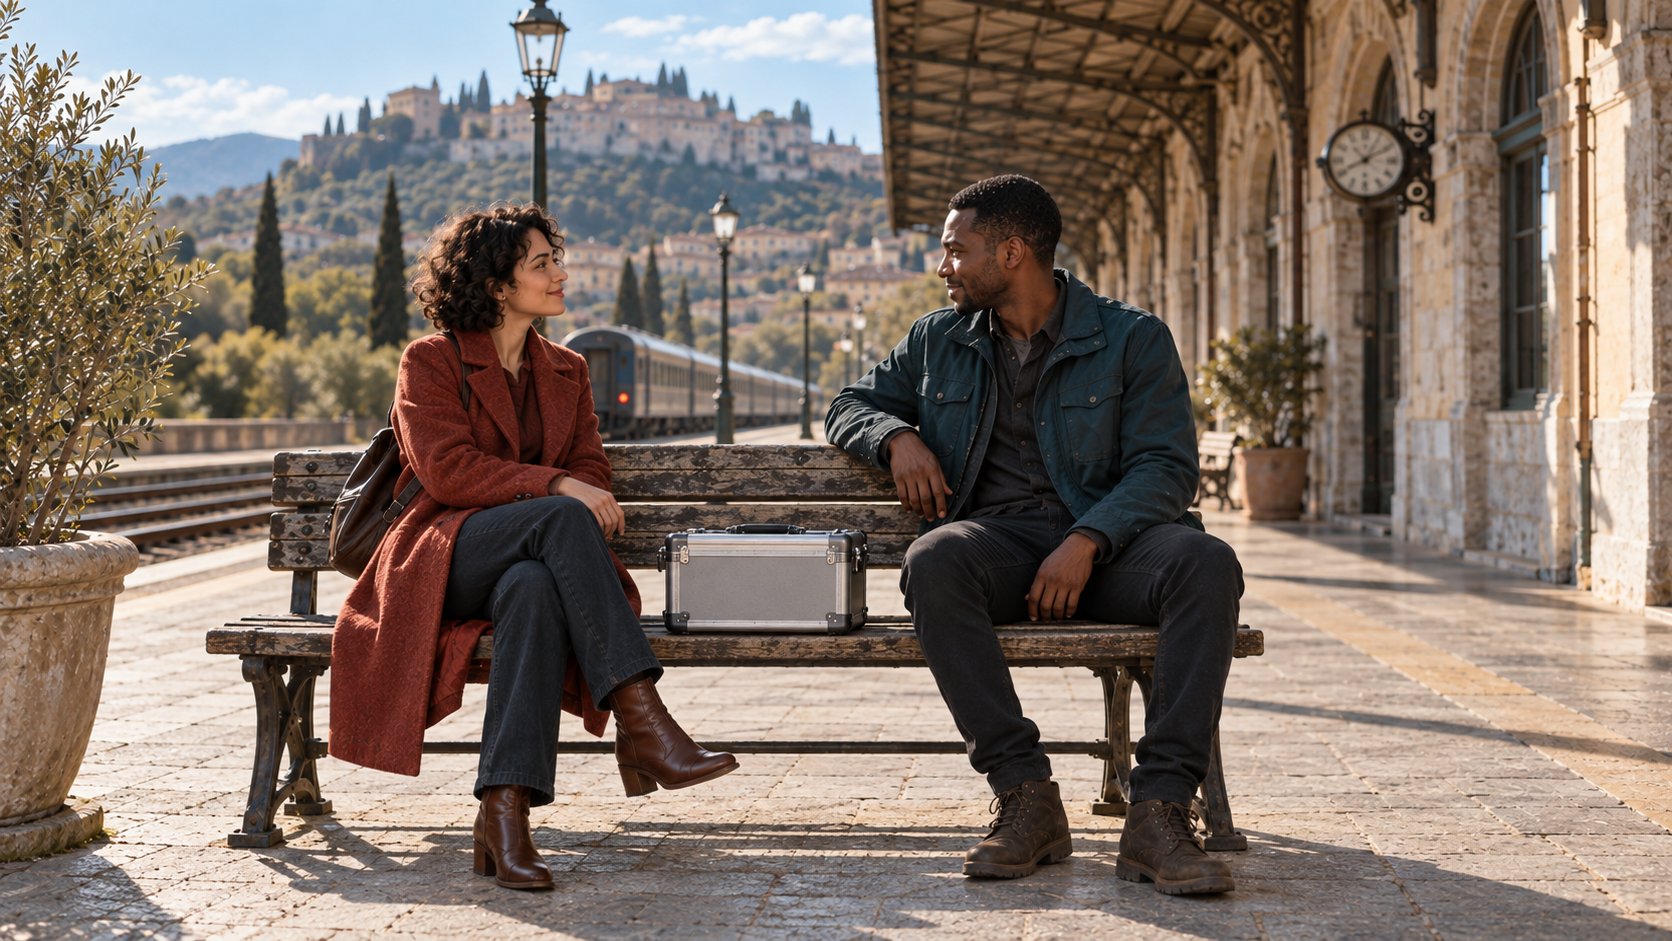
Illustrativer generierter End-Frame: Dasselbe Gesicht, dieselben Mäntel, dieselbe Bank, derselbe Bahnhof, derselbe Koffer und dasselbe Licht machen Kontinuitätsabweichungen leicht erkennbar.
Analysieren Sie Fehler und führen Sie den kleinstmöglichen Teil neu aus
Ordnen Sie jeden sichtbaren Fehler einer einzigen Prompt-Änderung zu
Sehen Sie sich das vollständige Video zunächst in normaler Geschwindigkeit an, anschließend prüfen Sie die Übergabe und den Dialog in halber Geschwindigkeit. Falls Identitäten vertauscht werden, stärken Sie die Zuordnung zwischen Subjekt und Referenz und vereinfachen Sie den Schnitt. Falls Gesichter in einer Weitaufnahme verschmelzen, erhöhen Sie den Abstand zwischen den Subjekten oder verlegen Sie den Dialog in eine mittlere Zwei-Personen-Aufnahme; der Leitfaden zur Korrektur entfernter Gesichter behandelt Rahmenführung und Referenzwahl für dieses Problem.| Fehler | Wahrscheinliche Ursache | Kleinste sinnvolle Änderung | | --- | --- | --- | | Zeichen tauschen ihre Rollen | Ähnliche Garderobe oder mehrdeutige Beschriftungen | Wiederherstellung klar unterscheidbarer Beschriftungen, Kleidung, Positionen und Sprecher-IDs | | Beide Münder bewegen sich | Verhalten des Zuhörers nicht spezifiziert | Hinzufügen von „hört zu, Lippen bleiben geschlossen“ nach jeder Zeile | | Ein zusätzlicher Arm erscheint | Der Übergabeprozess überspringt einen Kontaktzustand | Ausweitung der Phasen „gemeinsame Stützung“ und „Freigabe“ | | Requisit ändert seine Form | Zu viele Aktionen oder schwach definiertes Requisit | Festlegung von Abmessungen, Griff, Oberfläche und endgültigem Besitzer | | Blickrichtungen brechen nach dem Schnitt | Positionen werden nicht erneut etabliert | Wiederholung beider Positionen sowie des Blicks unter dem neuen Winkel | | Umgebung wird zurückgesetzt | Szeneanker waren implizit | Wiederholung von Plattform, Bank, Zug, Lichtrichtung und Zeitpunkt |
Generieren Sie keine neue, korrekte Etablierung, nur weil ein einzelner Übergabeframe fehlschlägt. Speichern Sie die akzeptierten Charakterreferenzen, die Prompt-Version, den Seed oder den Aufgabenverlauf (sofern verfügbar), die Ausgabe sowie die Fehlerbemerkung. Führen Sie dann die kleinste Variante mit genau einer korrigierenden Änderung erneut aus. Seedance Agent kann diese Referenzen organisieren, Kandidaten vergleichen, den Genehmigungsstatus verwalten und ausschließlich das fehlgeschlagene Segment durch einen Referenz-zu-Video-Workflow leiten.
Fazit
Ein zuverlässiger MiniMax H3-Zwei-Personen-Video-Workflow nutzt den richtigen Eingabemodus, zwei unmissverständliche Subjektreferenzen, stabile S1- und S2-Sprecher-IDs, eine kausale Interaktion, explizite Zustandsänderungen des Requisits sowie einen Schnittplan, dessen Endzustände mit den jeweiligen Anfangszuständen der folgenden Sequenzen übereinstimmen. Überprüfen Sie Identität, Mundzuordnung, Hände, Blickrichtungen, Requisitgeometrie, Umgebung und Ton separat – und führen Sie anschließend ausschließlich den fehlgeschlagenen Abschnitt erneut aus. Um Referenzen, Shots, Genehmigungen und gezielte Revisionen zusammenzuhalten, erstellen Sie die Zwei-Charakter-Sequenz mit Seedance Agent.
Bereit, es selbst auszuprobieren?
Setzen Sie die Schritte aus diesem Leitfaden direkt in Seedance um und verwandeln Sie Prompts oder Bilder in wenigen Minuten in fertige Videos.
Kostenlose Credits bei der Anmeldung. Tarife ab $20/Monat.
Verwandte Artikel
Weitere Beiträge in derselben Sprache, die Sie als Nächstes lesen könnten.
Socialive Catalyst Early Access Guide: Bereiten Sie einen nützlichen ersten Pilotversuch vor
Erfahren Sie, wer Zugang zu Socialive Catalyst hat, was die frühe Beta umfasst, was Sie für eine Demo vorbereiten müssen und wie Sie einen markenbasierten Enterprise-Video-Workflow testen.
Artikel lesen
FramePack Torch CUDA nicht aktiviert: Diagnose und Behebung der richtigen Umgebung
Beheben Sie FramePack, wenn Torch keine CUDA-Unterstützung bietet, indem Sie die genaue Python-Laufzeitumgebung überprüfen, ein CPU-only-Paket ersetzen, Treiber- oder RTX-Kompatibilitätsprobleme behandeln und die Reparatur nachweisen.
Artikel lesen
Google Vids – Tutorial zum persönlichen Avatar: Aufnehmen, Prompt erstellen und Probleme beheben
Erstellen Sie einen persönlichen Avatar in Google Vids, absolvieren Sie die Gesichts- und Sprachaufnahme, formulieren Sie einen nützlichen Gemini-Omni-Prompt, beheben Sie fehlenden Zugriff und verwalten Sie Ihre Aufnahme.
Artikel lesen