
MiniMax H3 Continuous Talking Avatar Workflow: Keep One Face and Voice Across Clips

AI Overview
Kann MiniMax H3 ein einziges, kontinuierliches Talking-Avatar-Video erzeugen?
Ja, allerdings sollte ein langes Ergebnis als mehrere genehmigte Clips geplant werden – nicht als eine einzige, unbegrenzte Generierung. H3 erzeugt Videos mit einer Dauer von 4–15 Sekunden; teilen Sie daher das Drehbuch an natürlichen Pausen auf und verbinden Sie Segmente, die dasselbe Gesicht, dieselbe Stimme, denselben Bildausschnitt und denselben Raumklang („room tone“) aufweisen.
Wie behält man in jedem Segment dieselbe Avatar-Identität bei?
Verwenden Sie einen sauberen Identitäts-Referenzrahmen, wiederholen Sie dieselben sichtbaren Merkmale, weisen Sie eine stabile Sprecher-ID wie S1 zu und beginnen Sie jede Fortsetzung stets von einem genehmigten neutralen Übergangsrahmen aus. Ändern Sie ausschließlich den Dialog sowie die kleinste notwendige Geste.
Was macht Schnitte zwischen Talking-Avatar-Segmenten nahtlos?
Beenden Sie jedes Segment nach einem vollständigen Satz mit geschlossenem Mund, ruhigem Augenkontakt, entspannten Händen und einer kurzen Raumklang-Nachlaufphase („room-tone tail“). Beginnen Sie das nächste Segment aus genau diesem identischen Zustand heraus und verbergen Sie die Schnittstelle unter einer natürlichen Pause oder einem zurückhaltenden Ausschnitt („cutaway“).
Wie verhindert man, dass die Lippen-Synchronisation abdriftet?
Halten Sie jeden gesprochenen Abschnitt kurz genug für einen einzigen Atemzug, formulieren Sie den exakten Dialog innerhalb des <d>-Tags und vermeiden Sie konkurrierende Gesichts- oder Kamerabewegungen. Überprüfen Sie den Mund vor der Genehmigung des Segments sowohl in Echtzeitgeschwindigkeit als auch framegenau.
Planen Sie einen kontinuierlichen Avatar als kurze, genehmigte Segmente
Erstellen Sie das Master-Video aus atemgroßen Clips
Ein MiniMax H3-Workflow für kontinuierliche Talking-Avatar-Videos ist ein Produktionsplan – kein Aufruf zur unbegrenzten Dauer. Die offiziellen H3-Werkzeuge akzeptieren ganzzahlige Dauern von 4 bis 15 Sekunden. Behandeln Sie diese Obergrenze als kreative Einschränkung: Jeder Clip sollte eine vollständige Idee, eine dezente Geste und einen sauberen Endzustand enthalten. Eine 45-sekündige Erklärung könnte beispielsweise aus vier Segmenten zu je 10–13 Sekunden bestehen – statt aus drei Clips, die künstlich an die maximale Dauer herangeführt werden.
Markieren Sie das Drehbuch bereits vor der Generierung. Gute Schnittstellen folgen Interpunktion, einem Atemzug oder einem Themenwechsel. Schlechte Schnittstellen zerlegen Namen, Zahlen oder emotional verbundene Phrasen. Sprechen Sie jedes Segment laut und mit Stoppuhr durch, reservieren Sie dann jeweils etwa eine Sekunde für die Anfangsruhephase („opening settle“) und die abschließende Haltephase („final hold“). Falls die gesprochene Passage bereits die gesamte Zeit beansprucht, kürzen Sie stattdessen den Text – statt das Modell zum Beschleunigen zu zwingen.
| Segment | Gesprochene Aufgabe | Zielgeste | Erforderlicher Endzustand |
|---|---|---|---|
| A | Einführung des Themas | Kleine, offene Handgeste | Mund geschlossen, Hände senken sich |
| B | Erläuterung des Kernpunkts | Eine zurückhaltende Zeigegeste mit dem Zeigefinger | Derselbe Augenkontakt, Hände auf dem Tisch |
| C | Nennen des Beispiels | Kurzes Nicken, keine Kamerabewegung | Neutrale Mimik und Raumklang |
| D | Aussprechen des Calls-to-Action (CTA) | Leichte Vorwärtsneigung, dann Entspannung | Zweibeatige Haltephase für den Schnitt |
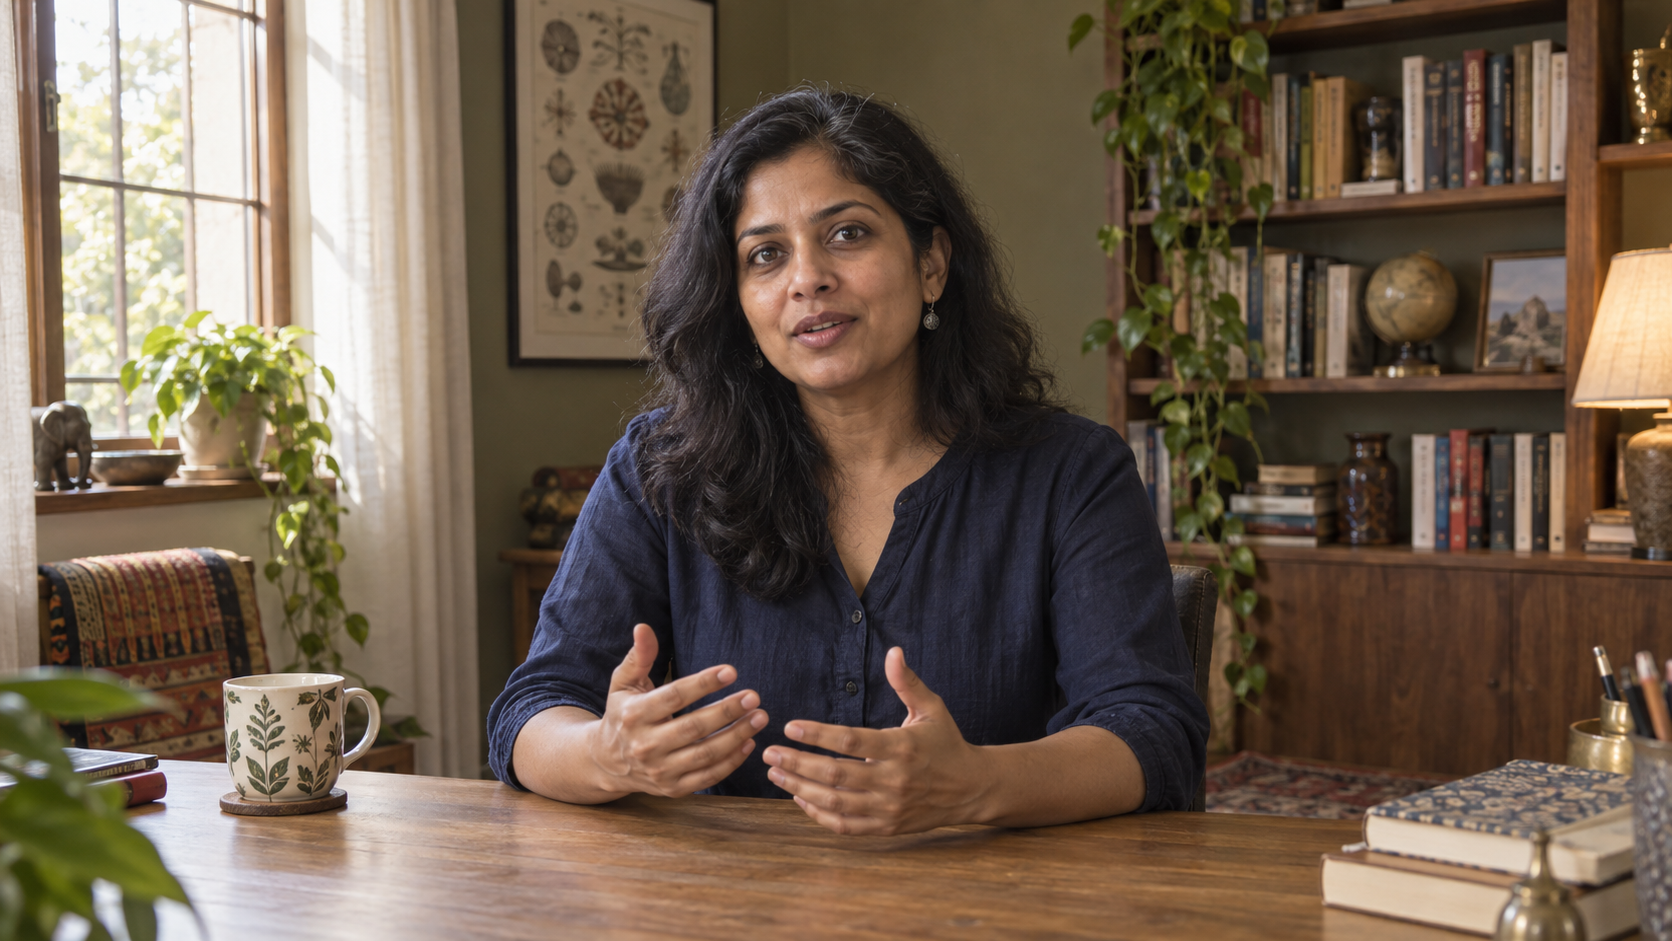
Illustratives generiertes Standbild, kein MiniMax H3-Ergebnis: Die mittlere Bildkomposition, sichtbare Hände, schlichte Kleidung und stabiler Hintergrund liefern stärkere Kontinuitätsindizien für eine Sprechsequenz als ein enger Schönheitsporträt-Ausschnitt.
Diese Segmentierung erleichtert zudem kostengünstige Korrekturen. Falls Segment C eine unzureichende Mundform aufweist, generieren Sie lediglich C neu – ohne die anderen bereits genehmigten Segmente zu gefährden. Dieselbe Checkpoint-Logik gilt hier wie im wiederaufnehmbaren Multishot-Workflow: Speichern Sie für jedes Segment die jeweilige Skriptversion, den Referenzsatz, den Prompt, das generierte Output-Material sowie den genehmigten Übergangsrahmen.
Bereiten Sie Gesicht, Stimme, Drehbuch und Bildausschnitt vor
Erstellen Sie ein kompaktes Kontinuitätspaket
Wählen Sie ein Referenzbild mit einem gut erkennbaren Gesicht, entspannten Lippen, einem unaufdringlichen Hintergrund und demselben Kamerawinkel, der für das fertige Video erforderlich ist. Ein mittlerer oder mittelnaher Bildausschnitt ist in der Regel sicherer als eine Weitwinkelaufnahme, da der Mund groß genug bleibt, um ihn prüfen zu können. Halten Sie Haare vom Mund fern, vermeiden Sie, dass Hände den unteren Gesichtsbereich verdecken, und verwenden Sie sanftes, gerichtetes Licht statt harter, bewegter Schatten.
Formulieren Sie einen festen Identitätsblock und verwenden Sie ihn wortwörtlich wieder. Fügen Sie Alterseinschätzung, Haarfarbe und -stil, Kleidung, ein charakteristisches, aber alltägliches Merkmal, Stimmqualität, Sprechtempo, Akzent (nur bei Bedeutung), Kamerahöhe, Bildgröße, Lichtrichtung sowie verankerte Hintergrundelemente ein. Fügen Sie in späteren Segmenten keine neuen Adjektive hinzu; scheinbar harmlose Ergänzungen können Stil, Alter oder Gesichtsproportionen verändern.
Bei referenzbasierten Generierungen kann H3 Bilddateien, Videodateien und Audiodateien nutzen. Die offizielle Vollreferenz-Anleitung unterscheidet sichtbare Subjekte, konkrete Bildanker, Quellvideos und Audio-Referenzen. Wenn eine Audio-Referenz die Stimmcharakteristik – nicht jedoch ein kopiertes Signal – bereitstellt, beschreiben Sie sie als Timbre- und Vortragsreferenz. Verknüpfen Sie stets dieselbe Sprecher-ID mit dem Avatar, wo immer sie tatsächlich spricht.
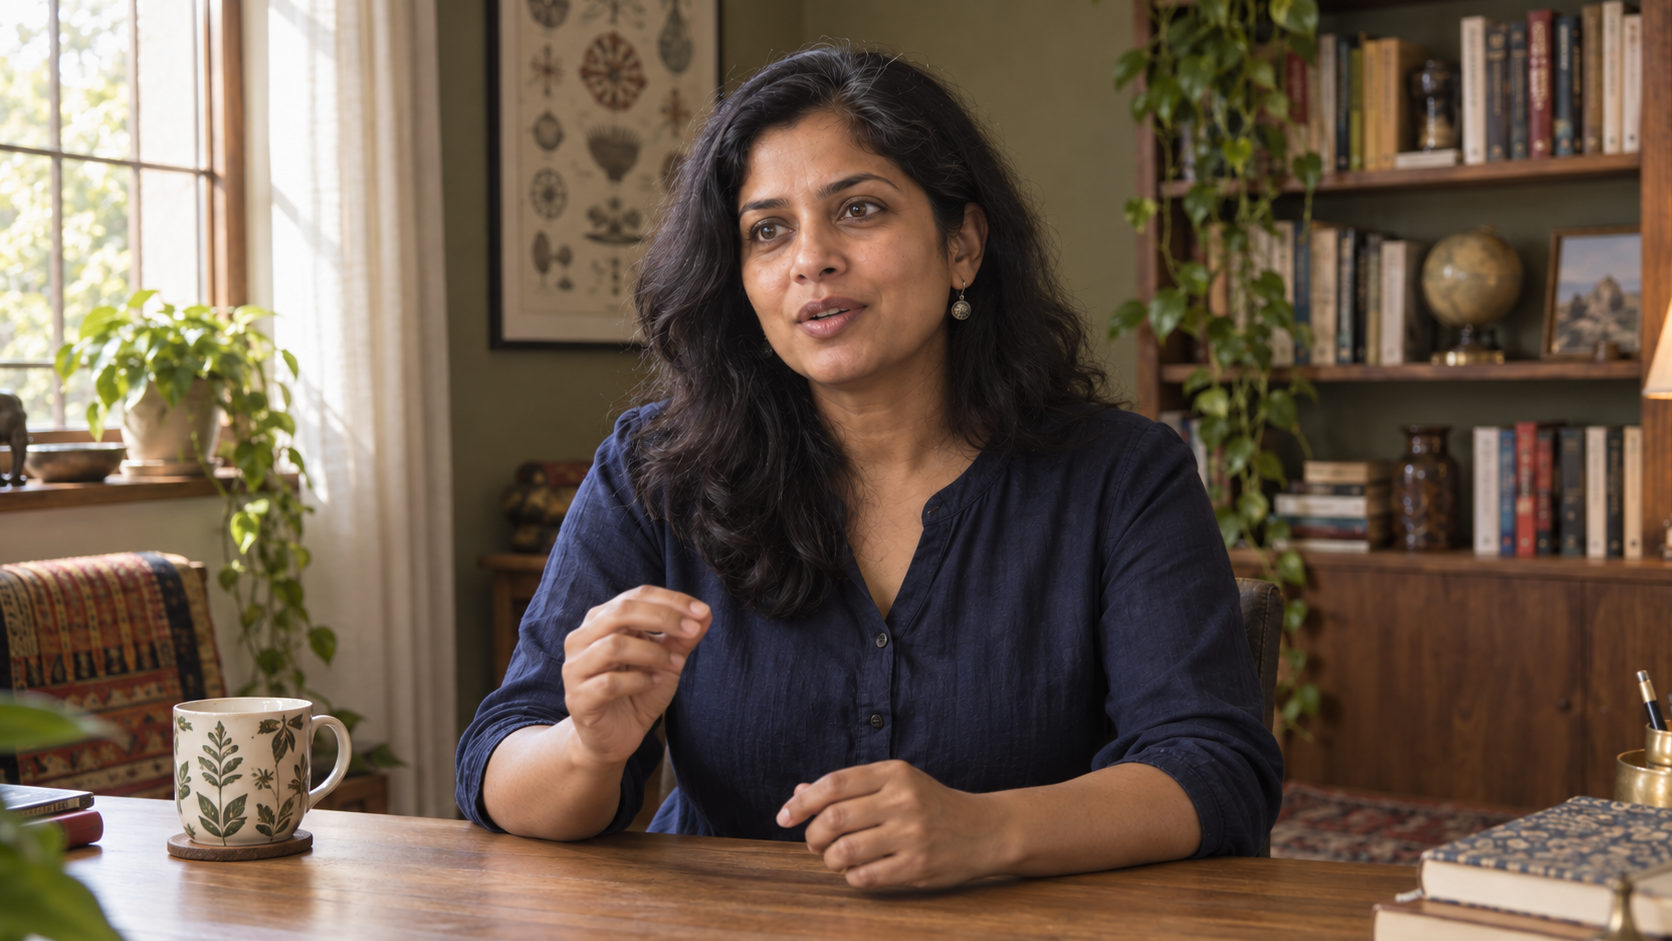
Ziel für Kontinuität in einem Sprechsegment: Identität, Objektiv, Augenlinie, Kleidung und Licht bleiben konstant, während sich ausschließlich die Mundform und eine kleine Geste ändern.
Nehmen Sie sauberen Dialog auf, falls Sie eine bestimmte Stimme benötigen. Nutzen Sie einen ruhigen Raum, konstanten Mikroabstand, keine Hintergrundmusik und separate Dateien für jedes Segment. Passen Sie Lautstärke und Raumklang vor der Generierung an. Falls es lediglich um eine glaubwürdige Muttersprachler-Stimme geht, geben Sie einen stabilen Timbre und ein konstantes Tempo an – halten Sie aber dennoch die exakten Wörter im Prompt fest. Die Anleitung zur Stimmkonsistenz enthält eine nützliche Hör-Checkliste, die sich ebenfalls beim Review von H3-Ausgaben bewährt.
Formulieren Sie den H3-Dialog, ohne die Sprecheridentität zu verlieren
Halten Sie die visuelle Ausrichtung außerhalb des Dialogtags
Der offizielle H3-Basisleitfaden verwendet stabile Sprecher-IDs wie (S1) und platziert ausschließlich die zu sprechenden Wörter innerhalb von <d>. Die identifizierende Formulierung, die Handlung, die Sprechweise und die Sprecher-ID verbleiben außerhalb des Tags. Diese Trennung verhindert, dass Aufführungsanweisungen versehentlich als Dialog interpretiert werden.
[Aufnahme 1] Eine realistische Mittelaufnahme derselben Wissenschaftsvermittlerin, die am Eichenschreibtisch sitzt. Kamera, Objektiv, Lichtrichtung, Garderobe, Bücher, Pflanzen und Tasse bleiben unverändert. Die ruhige erwachsene Frau (S1), mit warmer Stimmlage im mittleren bis tiefen Frequenzbereich, gemessenem Sprechtempo und klarer Aussprache, blickt knapp neben die Linse. Sie macht eine kleine, offene Handgeste und sagt: <d>[Englisch] Ein stabiler Avatar beginnt mit einer stabilen Übergabe zwischen jedem genehmigten Clip.</d> Nach dem Satz schließen sich ihre Lippen, ihre Hände kehren auf den Schreibtisch zurück, und sie behält für eine Sekunde denselben Augenkontakt bei. Der ruhige Raumton setzt fort. Keine Musik, keine Kamerabewegung, kein Textoverlay.
Wiederholen Sie die identifizierende Formulierung, wenn bei einer neuen Generierung andernfalls die Erinnerung daran verloren gehen könnte, wer S1 ist. Erstellen Sie nicht eine neue Sprecher-Nummer für denselben Avatar im nächsten Clip. Falls eine weitere Stimme hinzukommt, weisen Sie diese einmalig S2 zu und halten Sie die Rollen stets explizit fest. Bei einem Einzelpersonen-Erklärvideo eliminiert das Ausschließen anderer hörbarer Stimmen eine unnötige Quelle für Drift.
Formulieren Sie jeweils nur eine gesprochene Klausel pro sichtbarer Aktion. Schnelle Kopfdrehungen, große Armgesten, Kameravorstöße und lange Sätze konkurrieren alle um dasselbe kurze Zeitintervall. Wenn die Genauigkeit der Mundbewegung entscheidend ist, halten Sie die Kamera statisch und lassen Sie den Oberkörper ruhig. Nutzen Sie die praktischen Ausdruckssteuerungen im H3-Mikroausdrucks-Prompt-Leitfaden, um beispielsweise eine zurückhaltende Augenbrauenhebung oder ein Nicken anzufordern, ohne das gesamte Gesicht zu verändern.
Übertragen Sie einen Ankerzustand über jeden Schnitt hinweg
Beenden Sie sauber, bevor Sie den nächsten Beginn anfordern
Die letzte Sekunde eines Clips bildet die visuelle Vereinbarung für den nächsten. Fordern Sie einen festgelegten Endzustand an: Lippen geschlossen, Kiefer entspannt, Augen auf derselben Markierung, Hände in einer benannten Position, Schultern auf gleicher Höhe sowie unveränderte Hintergrundobjekte. Exportieren Sie diesen genehmigten Endzustand als nächstes Bildanker, falls die Generierungsmethode dies zulässt. Eine neutrale Halteposition ist vielseitiger verwendbar als ein Frame, der mitten im Wort eingefangen wird.
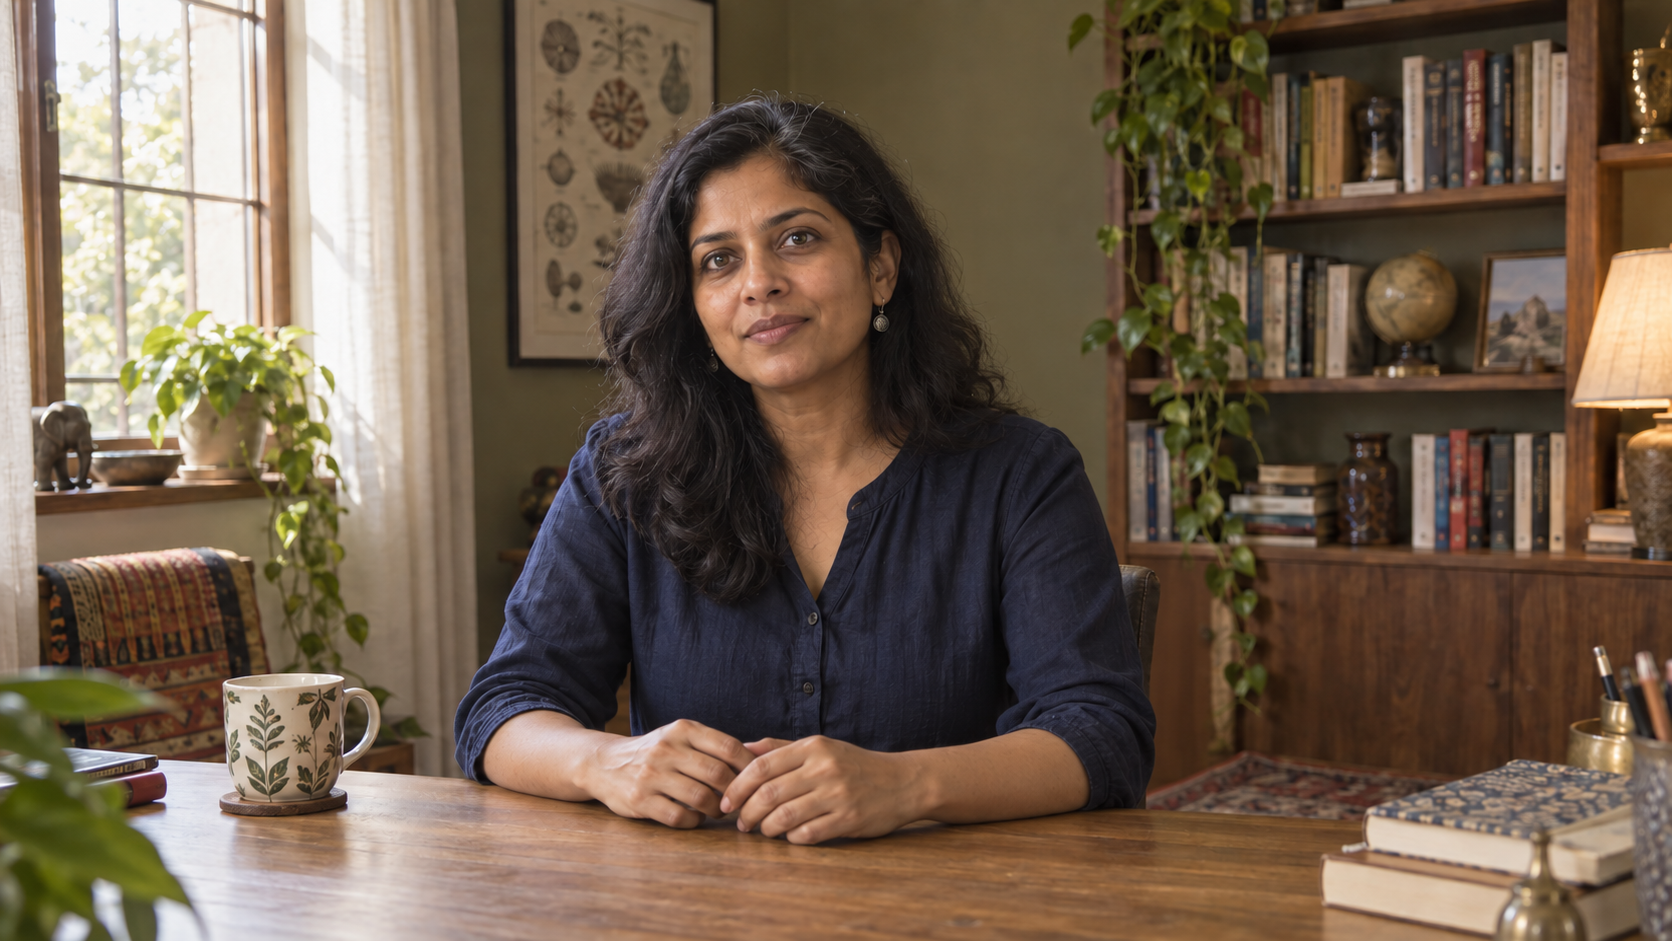
Ein nützlicher Grenzframe ist absichtlich ereignislos: Der Mund ist geschlossen, Blickrichtung und Körperhaltung sind stabilisiert, und es muss keine Geste magisch über den Schnitt hinweg fortgesetzt werden.
Zu Beginn des Segments B wiederholen Sie den festgelegten Zustand, bevor die neue Aktion startet. Bewahren Sie Größe des Kopfes, Kamerahöhe, Augenlinie, Lichtrichtung, Ärmelposition sowie Lage hochkontrastiger Hintergrundobjekte. Die erste Bewegung sollte erst nach einer kurzen Stabilisierungsphase beginnen – nicht bereits im ersten Frame. Falls das nächste Clip mit einer anderen Pose beginnt, bemerkt das Publikum den Sprung bereits vor dem Hören der Worte.
H3 unterstützt First-/Last-Frame- und Referenzmodi; verwenden Sie jedoch stets nur den Modus, der zur jeweiligen Aufgabe passt. Ein konkretes Grenzbild ist ein Frameanker; eine Audio-Sample kann die Klangfarbe leiten; ein vorheriges Video kann Bewegungs- oder Fortsetzungskontext liefern. Mehr Referenzen sind nicht automatisch besser. Entfernen Sie jedes Asset, das mit der genehmigten Bildkomposition, Garderobe oder Stimme widerspricht.
Die Übergabemethode steht in engem Zusammenhang mit der Multi-Keyframe-Planung; ein sprechender Avatar benötigt jedoch weniger visuelle Ambitionen. Ein stabiler Anker pro Grenze übertrifft in der Regel ein detailliertes Storyboard, das gleichzeitig Veränderungen im Gesicht, an den Händen, an der Kamera und im Raum verlangt.
Setzen Sie die Segmente ohne hörbare oder sichtbare Sprünge zusammen
Schneiden Sie an einer Pause und bewahren Sie den Raumton
Platzieren Sie jeden genehmigten Clip in Skriptreihenfolge auf einer Timeline. Entfernen Sie doppelte Stabilisierungsframes, behalten Sie aber genügend neutrales Material, um den Schnitt vom geöffneten Mund wegzubewegen. Passen Sie Skalierung und Position an, bevor Sie Übergänge hinzufügen. Ein gerader Schnitt während einer natürlichen Pause ist meist sauberer als ein Überblenden, das kurzzeitig zwei Münder zeigen und das Gesicht instabil erscheinen lässt.
Echtes Seedance-Ergebnis, kein MiniMax H3-Ergebnis: Verwenden Sie diese native-Audio-Stichprobe als Bewertungsgrundlage für Sprechzeit, Gesichtsbewegung und durchgängige Raumambiente.
Hören Sie die Schnittstellen mit ausgeblendeter Bildspur ab. Passen Sie Lautstärke des Dialogs, Rauschuntergrund, Nachhall und Dauer jedes Atems an. Legen Sie unter die gesamte Sequenz ein kurzes, kontinuierliches Raumton-Bett, damit winzige Lücken nicht wie ein plötzliches Abschalten des Raums klingen. Vermeiden Sie Musik, bis der Sprachschnitt funktioniert; ein Soundtrack kann beim Editieren einen schlechten Schnitt verbergen, ihn aber nicht korrigieren.
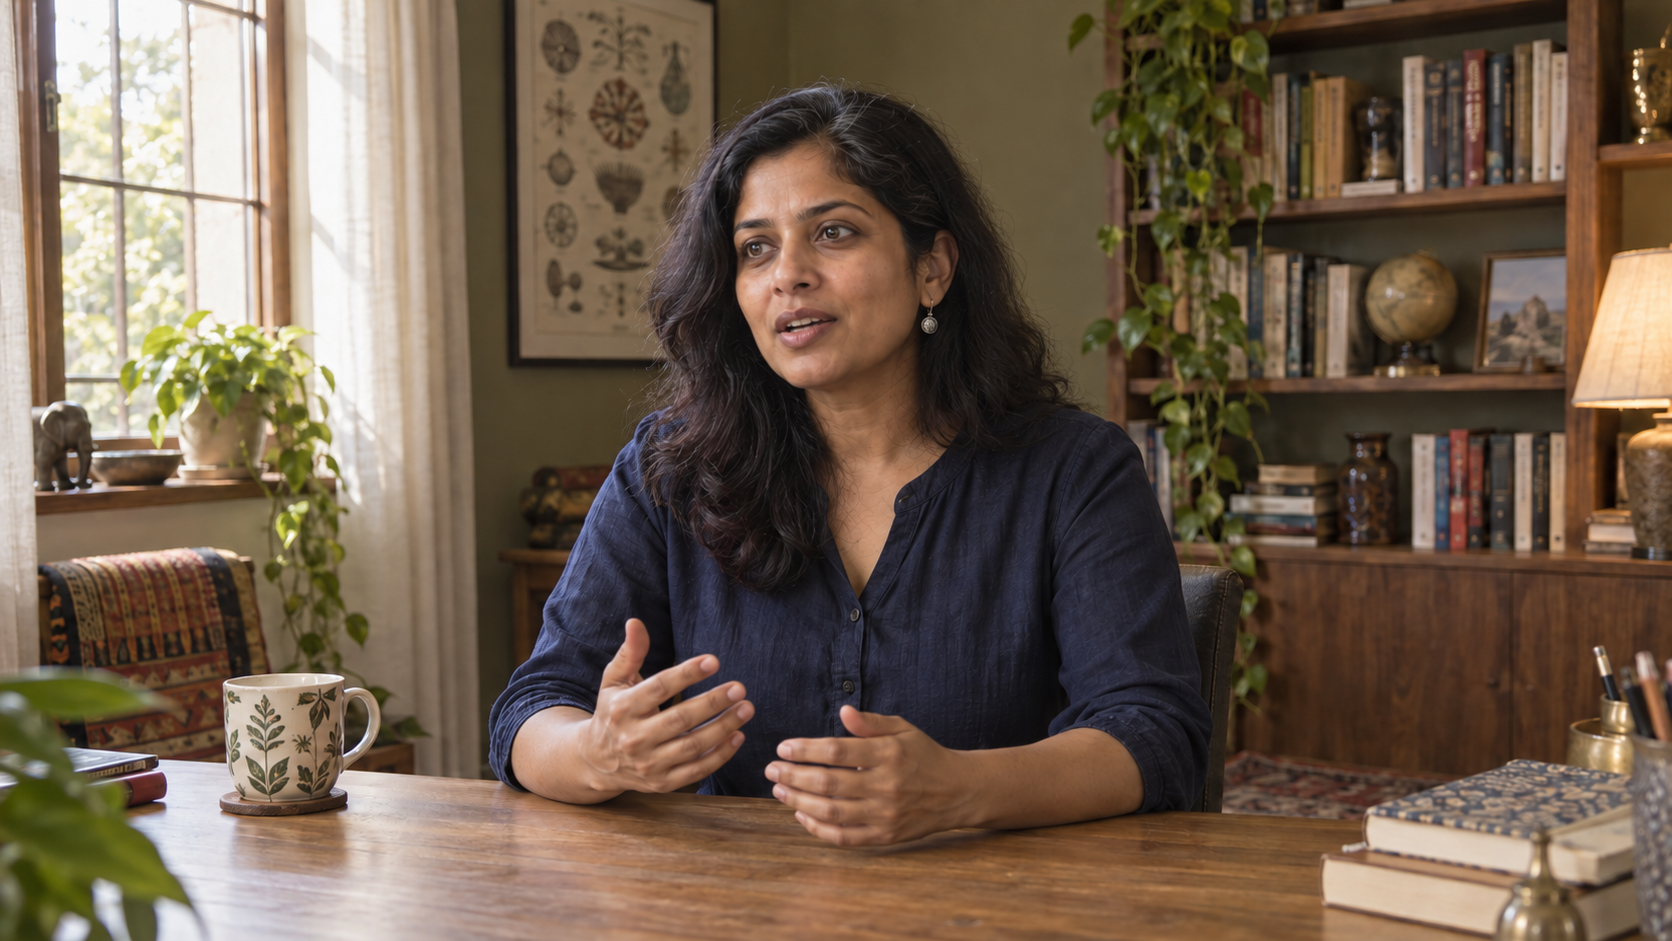
Fortsetzungsziel: Identität und visuelle Anker bleiben stabil, während der neue Satz mit einer leicht anderen, aber immer noch glaubwürdigen Handgeste beginnt.
Falls ein Sprung bestehen bleibt, nutzen Sie für ein bis zwei Sekunden einen relevanten Cutaway: das Notizbuch der Sprecherin, ein von ihr erwähntes Objekt oder eine weiter gefasste Ansicht aus demselben Raum. Fügen Sie keine zufälligen Stock-Footage-Materialien ein. Der Cutaway sollte die gesprochene Aussage beantworten oder veranschaulichen und danach zum identischen Avatar-Zustand zurückkehren.
Überprüfen Sie Fehler bei Lippen-Synchronisation, Stimme und Kontinuität
Genehmigen Sie jeden Clip in fünf separaten Durchgängen
Zuerst das Video in normaler Geschwindigkeit ansehen, um Sinn und natürlichen Rhythmus zu erfassen. Zweitens den Ton stummschalten und Identität, Zähne, Lippen, Kiefer, Augen und Hände genau prüfen. Drittens nur zuhören – ohne das Video anzusehen – auf Stimmklangfarbe, Sprechtempo, Raumton und Klicks. Viertens die ersten und letzten zwölf Bilder jedes Segments einzeln durchgehen. Fünftens die zusammengesetzte Sequenz auf einem Player mit Handy-Größe betrachten, wo feinste Gesichtsveränderungen deutlicher hervortreten können.
Ein Clip ist abzulehnen, wenn der Mund sich weiter bewegt, nachdem die Stimme verstummt ist; wenn sich die Zahnform von Bild zu Bild verändert; wenn der Kiefer seitlich verrutscht; wenn sich die Augenfarbe ändert; wenn eine Hand durch das Gesicht hindurchfährt; oder wenn sich Stimme plötzlich im Alter oder der räumlichen Distanz verändert. Eine beschädigte Identität darf nicht durch Schärfung „repariert“ werden. Stattdessen ist das kleinste gescheiterte Segment erneut vom zuletzt genehmigten Ankerpunkt aus zu generieren.
Wenn mehrere Fehler dieselbe Ursache haben, ist vor der Neugenerierung zu vereinfachen: Die Zeile kürzen, eine Geste entfernen, die Kamera fixieren, das Gesicht im Bild vergrößern oder einen mehrdeutigen Referenzpunkt ersetzen. Seedance Agent ist in dieser Phase besonders nützlich, da es das Referenzpaket, Segment-Prompts, tatsächliche Ausgaben, Notizen und genehmigte Wiederholungspunkte zusammenhält. Sie können die Ergebnisse von H3 mit einem kontrollierten Referenz-zu-Video-Workflow vergleichen, anstatt das Projekt aus verstreuten Dateien neu aufzubauen.
Fazit
Ein zuverlässiger MiniMax H3-Avatar mit kontinuierlichem Sprechen wird aus kurzen, überprüfbaren Sprachsegmenten zusammengesetzt: Das Skript zeitlich abstimmen, eine einheitliche Identität und S1-Stimmdarstellung beibehalten, exakte Wortfolgen innerhalb von <d> platzieren, jedes Clip auf einem neutralen Ankerpunkt enden lassen und die genehmigten Takes über einen kontinuierlichen Raumton nahtlos verbinden. Diese Methode verspricht keine unbegrenzte Generierung; sie bietet stattdessen einen wiederherstellbaren Weg, längere Erklärungen zu erstellen, ohne Gesicht, Stimme oder Lippen-Synchronisation einzubüßen. Um Referenzen, Prompts, Ausgaben, Genehmigungen und gezielte Neugenerierungen in einer Produktion zu planen, starten Sie ein Talking-Avatar-Projekt mit Seedance Agent.
Bereit, es selbst auszuprobieren?
Setzen Sie die Schritte aus diesem Leitfaden direkt in Seedance um und verwandeln Sie Prompts oder Bilder in wenigen Minuten in fertige Videos.
Kostenlose Credits bei der Anmeldung. Tarife ab $20/Monat.
Verwandte Artikel
Weitere Beiträge in derselben Sprache, die Sie als Nächstes lesen könnten.
MiniMax H3-Kamera: Steuerung der Brennweite – Weitwinkel-, Normal- und Teleobjektiv-Looks
Steuern Sie den optischen Eindruck des Objektivs bei der MiniMax H3 mithilfe der Aufnahmegröße, der Kameradistanz, der Zoom-Sprache, von Referenzbildern sowie eines wiederholbaren Prompt-Tests von 24 mm bis 85 mm.
Artikel lesen
MiniMax H3-Zwei-Personen-Video-Workflow: Rollen, Dialog und Bewegung klar halten
Erstellen Sie eine MiniMax H3-Szene mit zwei Personen mit stabilen Subjektkennzeichnungen, gut lesbarem Blocking, zugewiesenem Dialog, sauberen Requisitenübergaben und einem praktischen Workflow zur Fehlerprüfung.
Artikel lesen
Socialive Catalyst Early Access Guide: Bereiten Sie einen nützlichen ersten Pilotversuch vor
Erfahren Sie, wer Zugang zu Socialive Catalyst hat, was die frühe Beta umfasst, was Sie für eine Demo vorbereiten müssen und wie Sie einen markenbasierten Enterprise-Video-Workflow testen.
Artikel lesen