
MiniMax H3 – Flux de travail pour un avatar parlant continu : conserver un même visage et une même voix entre les extraits

AI Overview
MiniMax H3 peut-il générer une seule vidéo continue d’un avatar parlant ?
Oui, mais un résultat long doit être planifié comme plusieurs séquences approuvées plutôt que comme une génération indéfinie. H3 produit des extraits de 4 à 15 secondes ; divisez donc le script aux endroits naturels de pause, puis assemblez les segments partageant le même visage, la même voix, le même cadrage et le même ton ambiant (room tone).
Comment conserver l’identité de l’avatar dans chaque segment ?
Utilisez une seule référence d’identité propre, répétez systématiquement les mêmes traits visibles, attribuez un identifiant de locuteur stable (par exemple S1), et démarrez chaque suite à partir d’une image frontière neutre déjà approuvée. Ne modifiez que le dialogue et le geste minimal strictement nécessaire.
Qu’est-ce qui rend les raccords entre séquences d’avatar parlant imperceptibles ?
Terminez chaque segment après une phrase complète, avec la bouche fermée, le regard fixe, les mains immobiles et une courte queue de ton ambiant (room-tone tail). Démarrez le segment suivant depuis ce même état, puis masquez le raccord sous une pause naturelle ou un plan coupé sobre.
Comment éviter la dérive de la synchronisation labiale ?
Gardez chaque bloc parlé suffisamment court pour tenir sur une seule respiration, écrivez le dialogue exact à l’intérieur de la balise <d>, et évitez tout mouvement concurrent du visage ou de la caméra. Revoyez attentivement la bouche à vitesse normale, puis image par image, avant d’approuver le segment.
Planifier un avatar continu sous forme de courts segments approuvés
Construire le montage final à partir de séquences d’une durée équivalente à une respiration
Le flux de travail pour un avatar parlant continu MiniMax H3 est un plan de production, non une demande de durée illimitée. Les outils officiels H3 acceptent des durées entières comprises entre 4 et 15 secondes. Considérez cette limite comme une contrainte créative : chaque séquence doit contenir une idée complète, un geste modéré et un état final net. Une explication de 45 secondes pourrait ainsi se décomposer en quatre segments de 10 à 13 secondes, plutôt que trois séquences poussées à la limite maximale.
Marquez les points de rupture du script avant toute génération. De bons points de rupture suivent une ponctuation, une respiration ou un changement de sujet. De mauvais points de rupture scindent un nom, un chiffre ou une expression émotionnellement liée. Lisez à voix haute chaque segment en chronométrant, puis réservez environ une seconde pour le temps initial de stabilisation et le maintien final. Si la ligne parlée occupe déjà toute la durée allouée, raccourcissez le texte plutôt que de demander au modèle d’accélérer.
| Segment | Tâche parlée | Action ciblée | État final requis |
|---|---|---|---|
| A | Présenter le sujet | Petit geste de la main ouverte | Bouche fermée, mains en train de descendre |
| B | Expliquer le point clé | Un seul geste modéré de l’index | Même regard, mains posées sur le bureau |
| C | Donner l’exemple | Léger hochement de tête, sans mouvement de caméra | Expression neutre et ton ambiant stable |
| D | Formuler l’appel à l’action (CTA) | Légère inclinaison suivie d’un retour au calme | Maintien de deux battements pour le montage |
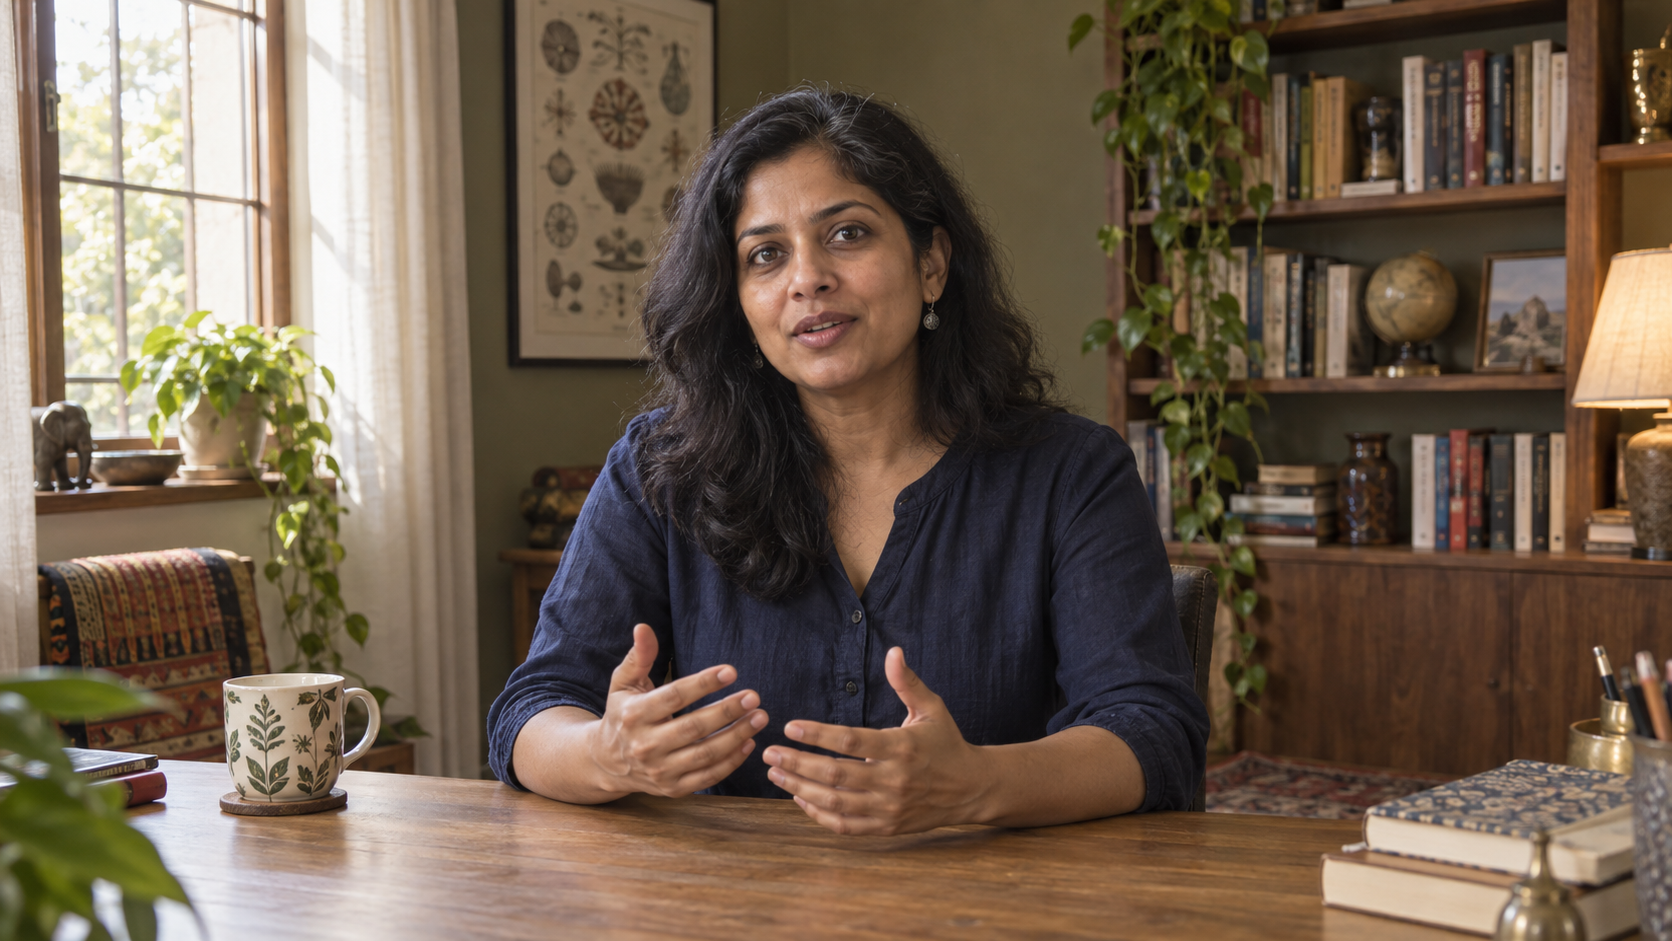
Image générée à titre illustratif, non issue de MiniMax H3 : le cadrage moyen, la visibilité des mains, la tenue simple et l’arrière-plan stable apportent davantage de continuité à une séquence parlante qu’un portrait serré « beauté ».
Cette segmentation rend également la reprise économique. Si le segment C présente une forme labiale insatisfaisante, relancez uniquement C, plutôt que de risquer de compromettre les autres segments déjà approuvés. La même logique de points de contrôle s’applique ici que dans le flux de travail multishot reprendre : sauvegardez, pour chaque segment, la version du script, l’ensemble de références, la requête (prompt), la sortie générée et l’image frontière approuvée.
Préparer le visage, la voix, le script et le cadre
Créer un « paquet de continuité » compact
Choisissez une image de référence présentant un visage lisible, des lèvres détendues, un arrière-plan dégagé et le même angle de caméra requis pour la vidéo finale. Un cadrage moyen ou moyen-rapproché est généralement plus sûr qu’un plan large, car la bouche reste suffisamment grande pour être inspectée. Écartez les cheveux des lèvres, évitez que les mains ne traversent la partie inférieure du visage, et utilisez une lumière directionnelle douce plutôt qu’ombres dures et mobiles.
Rédigez un bloc d’identité fixe et réutilisez-le mot pour mot. Incluez la fourchette d’âge, la coiffure, la tenue vestimentaire, une caractéristique distinctive mais ordinaire, la qualité vocale, le rythme de parole, l’accent uniquement si pertinent, la hauteur de la caméra, la taille du plan, la direction de la lumière et les repères d’arrière-plan. N’ajoutez pas d’adjectifs nouveaux dans les segments ultérieurs : des ajouts apparemment anodins peuvent modifier le style, l’âge ou les proportions du visage.
Pour la génération guidée par référence, H3 peut exploiter des actifs image, vidéo et audio. Son guide officiel complet sur les références distingue les sujets visibles, les ancres picturales concrètes, les vidéos sources et les références audio. Lorsqu’une référence audio fournit le caractère vocal plutôt qu’un signal copié, décrivez-la comme une référence de timbre et de débit. Attachez systématiquement le même identifiant de locuteur à l’avatar partout où elle parle effectivement.
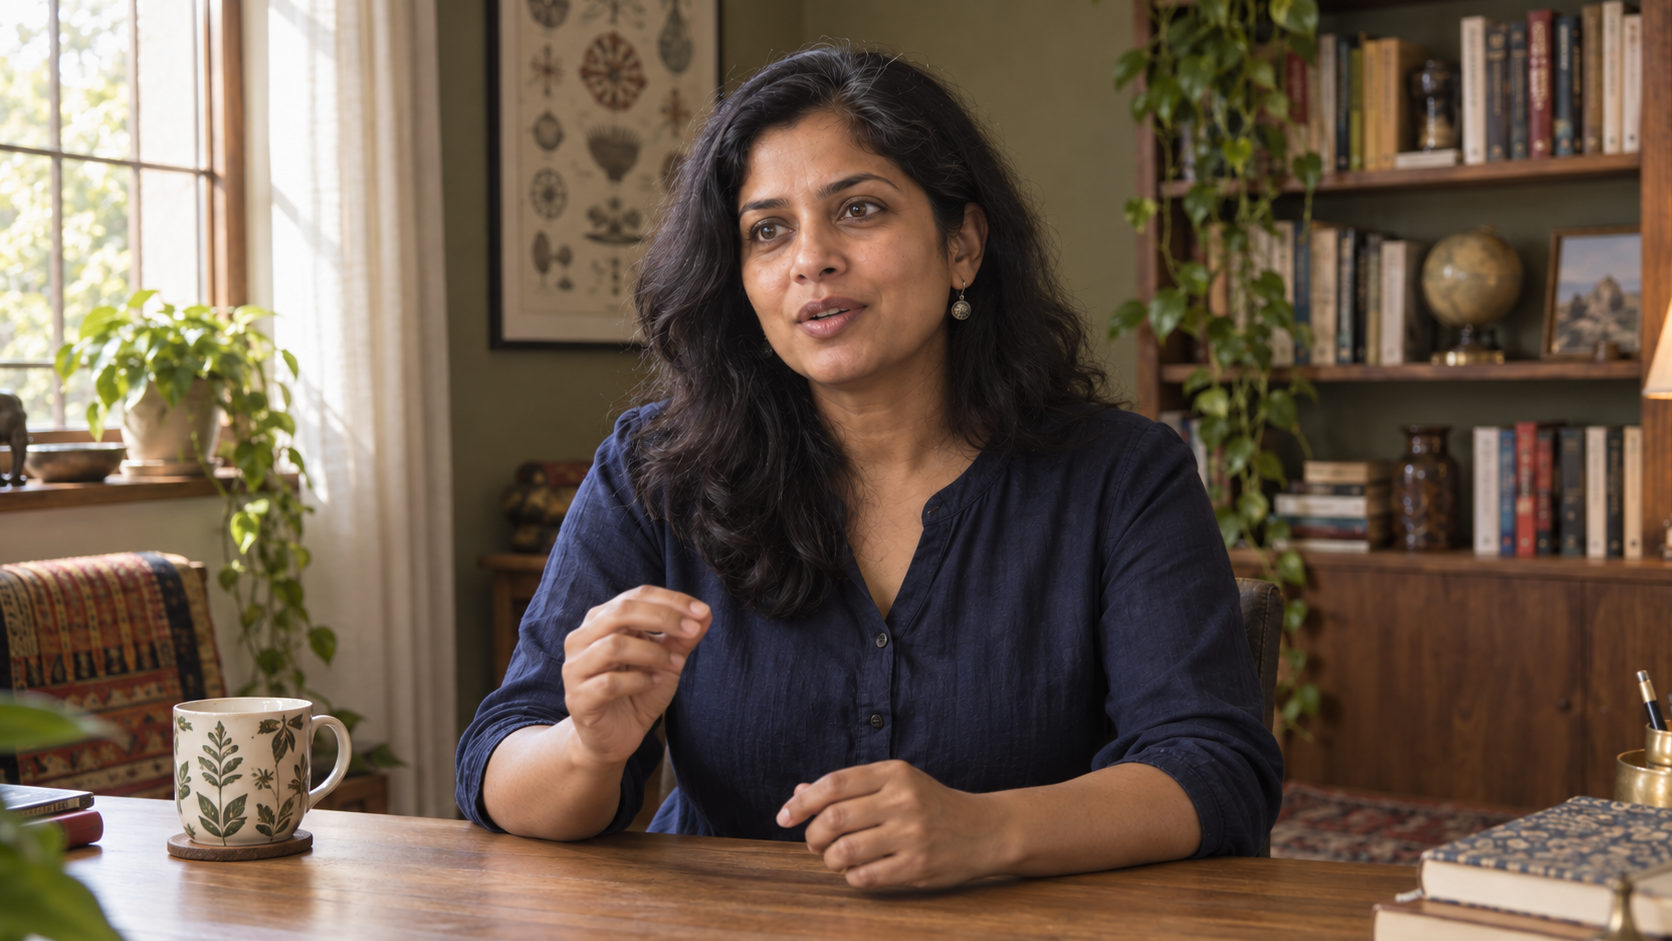
Objectif de continuité pour un segment parlé : identité, objectif, regard, tenue et lumière restent fixes, tandis que seule la forme de la bouche et un seul petit geste varient.
Enregistrez un dialogue propre si vous avez besoin d’une voix particulière. Utilisez une pièce silencieuse, une distance constante entre la bouche et le microphone, aucune musique de fond, et des fichiers séparés pour chaque segment. Ajustez le niveau sonore et le ton ambiant (room tone) avant génération. Si l’objectif est simplement d’obtenir une voix native crédible, précisez un timbre et un rythme stables, mais conservez néanmoins les mots exacts dans la requête (prompt). Le guide sur la cohérence vocale propose une liste de vérification utile à l’écoute, également applicable lors de l’analyse des sorties H3.
Rédiger le dialogue H3 sans perdre l’identité du locuteur
Conserver la direction visuelle à l’extérieur de la balise de dialogue
Le guide officiel de base H3 utilise des identifiants stables de locuteur tels que (S1) et place uniquement les mots à prononcer à l’intérieur de <d>. La phrase d’identification, l’action, la manière de livrer la réplique et l’identifiant du locuteur restent à l’extérieur de la balise. Cette séparation empêche les indications de performance de devenir accidentellement du dialogue.
[Plan 1] Un plan moyen réaliste du même éducateur scientifique assis à un bureau en chêne. La caméra, l’objectif, la direction de la lumière, la tenue vestimentaire, les livres, les plantes et la tasse restent inchangés. La femme adulte calme (S1), dotée d’une voix chaude aux fréquences moyennes-basses, d’un débit mesuré et d’une diction claire, regarde juste à côté de l’objectif. Elle effectue un petit geste de la main ouverte et dit : <d>[Anglais] Un avatar stable commence par une transmission stable entre chaque extrait approuvé.</d> Après la phrase, ses lèvres se ferment, ses mains retournent sur le bureau et elle maintient le même regard pendant une seconde. Le bruit ambiant de la pièce persiste. Aucune musique, aucun mouvement de caméra, aucune surimpression de texte.
Répétez la phrase d’identification lorsque la génération suivante risquerait autrement d’oublier qui est S1. Ne créez pas un nouvel identifiant de locuteur pour le même avatar dans le plan suivant. Si une autre voix intervient, attribuez-lui S2 une seule fois et conservez les rôles explicites. Pour un présentateur unique, exclure toute autre voix audible supprime une source inutile de dérive.
Rédigez une seule proposition parlée par action visible. Les rotations rapides de la tête, les grands mouvements des bras, les poussées de caméra et les phrases longues entrent tous en concurrence pour le même court intervalle. Lorsque la précision labiale est essentielle, maintenez la caméra fixe et gardez le torse immobile. Utilisez les commandes d’expression pratiques décrites dans le guide des microexpressions H3 pour demander une légère contraction des sourcils ou un hochement de tête modéré, sans modifier l’ensemble du visage.
Maintenir un état d’ancrage constant à chaque raccord
Terminer proprement avant de demander le début suivant
La dernière seconde d’un extrait constitue le contrat visuel pour le suivant. Demandez un état final verrouillé : lèvres jointes, mâchoire détendue, regard fixé sur la même repère, mains placées à une position nommée, épaules à niveau, objets d’arrière-plan inchangés. Exportez cette fin approuvée comme image d’ancrage pour le prochain extrait, dès que le mode de génération le permet. Une pause neutre est plus réutilisable qu’une image saisie en pleine parole.
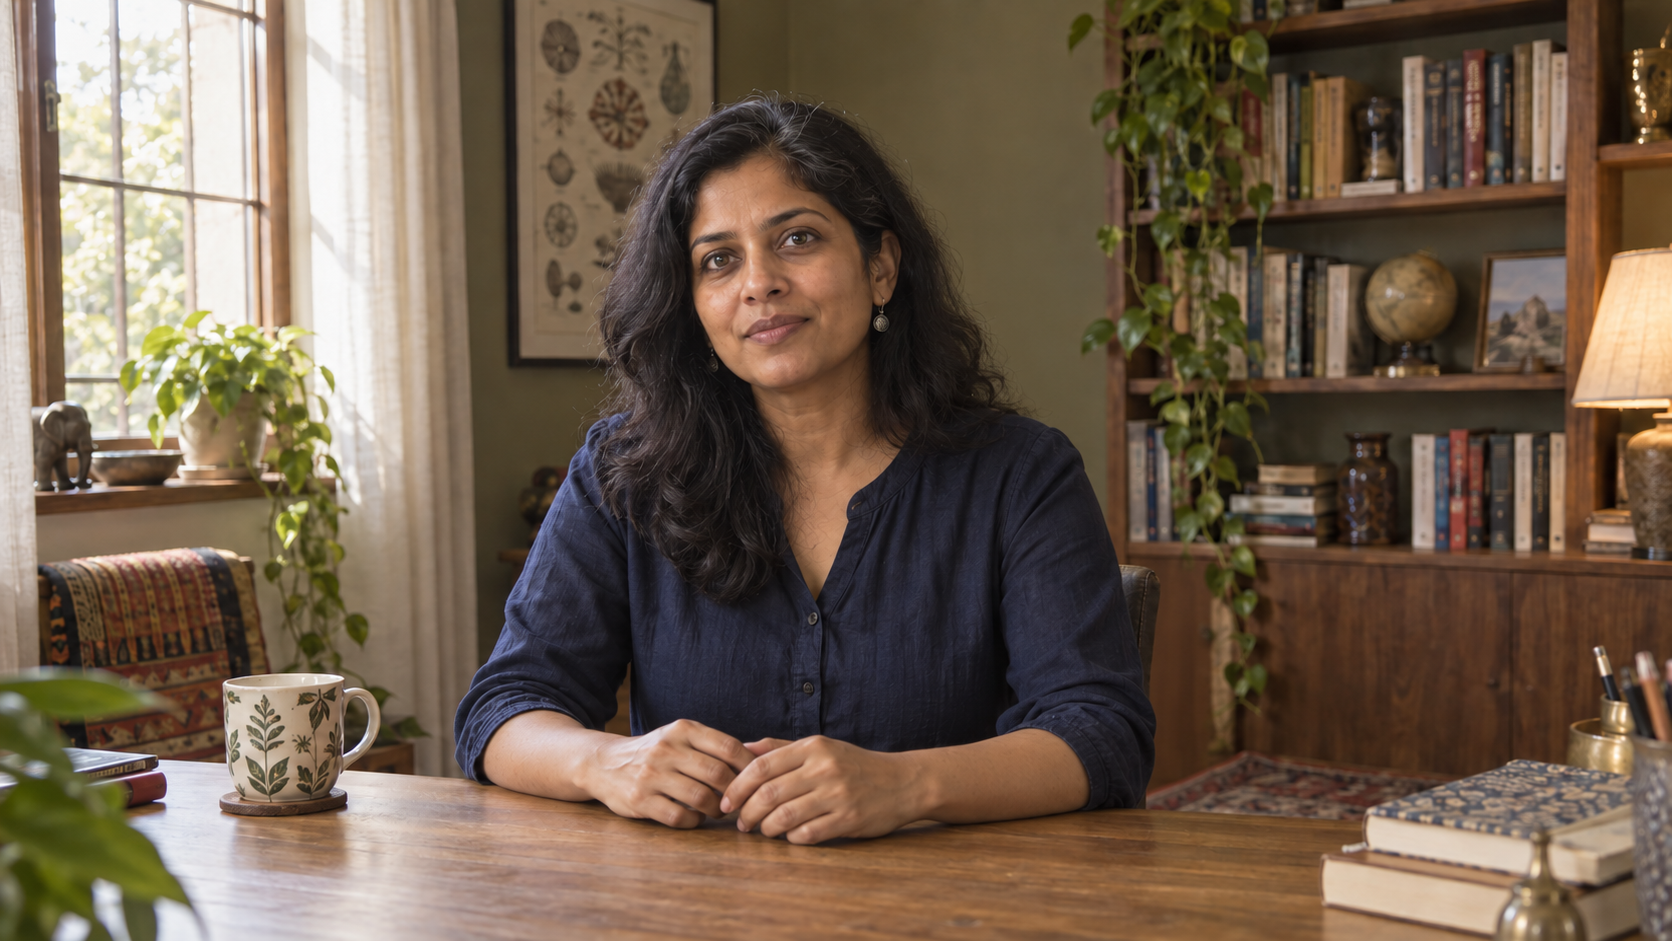
Une image limite utile est intentionnellement sans événement particulier : la bouche est fermée, le regard et la posture sont stabilisés, et aucun geste ne doit « magiquement » se poursuivre au-delà du montage.
Au début du segment B, reformulez l’état verrouillé avant la nouvelle action. Préservez la taille de la tête, la hauteur de la caméra, le regard, la direction de la lumière, la position des manches et l’emplacement des objets d’arrière-plan à fort contraste. Le premier mouvement doit commencer après une courte stabilisation, et non dès la première image. Si le plan suivant s’ouvre sur une pose différente, le spectateur perçoit le saut avant même d’entendre les mots.
H3 prend en charge les modes « image première/dernière » et « référence », mais n’utilisez que celui qui correspond précisément à la tâche. Une image limite concrète constitue un ancrage temporel ; un échantillon audio peut guider la teinte vocale ; une vidéo précédente peut fournir un contexte de mouvement ou de continuité. Plus de références ne signifie pas automatiquement meilleur résultat. Supprimez tout élément qui contredit le cadrage, la tenue ou la voix approuvés.
La méthode de transmission est étroitement liée à la planification multi-images-clés, mais un avatar parlant exige moins d’ambitions visuelles. Un ancrage stable par limite suffit généralement mieux qu’un storyboard dense demandant simultanément au visage, aux mains, à la caméra et à la pièce de changer.
Assembler les segments sans sauts auditifs ni visuels
Raccorder sur une pause et préserver le bruit ambiant
Placez chaque extrait approuvé sur une seule ligne temporelle, dans l’ordre du scénario. Supprimez les images redondantes de stabilisation, mais conservez suffisamment de matériel neutre pour décaler le raccord loin d’une bouche ouverte. Ajustez l’échelle et la position avant d’ajouter des transitions. Un raccord franc durant une pause naturelle est généralement plus net qu’un fondu, qui peut brièvement montrer deux bouches et donner l’impression d’un visage instable.
Sortie réelle Seedance, et non résultat MiniMax H3 : utilisez cet échantillon natif audio comme référence pour évaluer le timing vocal, le mouvement facial et l’ambiance continue.
Écoutez les jonctions à l’aveugle (image masquée). Ajustez le niveau sonore du dialogue, le bruit de fond, la réverbération et la durée de chaque respiration. Ajoutez un lit continu de bruit ambiant sous la séquence afin que les minuscules lacunes ne donnent pas l’impression que la pièce « s’éteint ». Évitez la musique tant que le raccord vocal n’est pas parfait : une bande-son peut masquer un mauvais raccord pendant le montage, mais ne le corrigera pas.
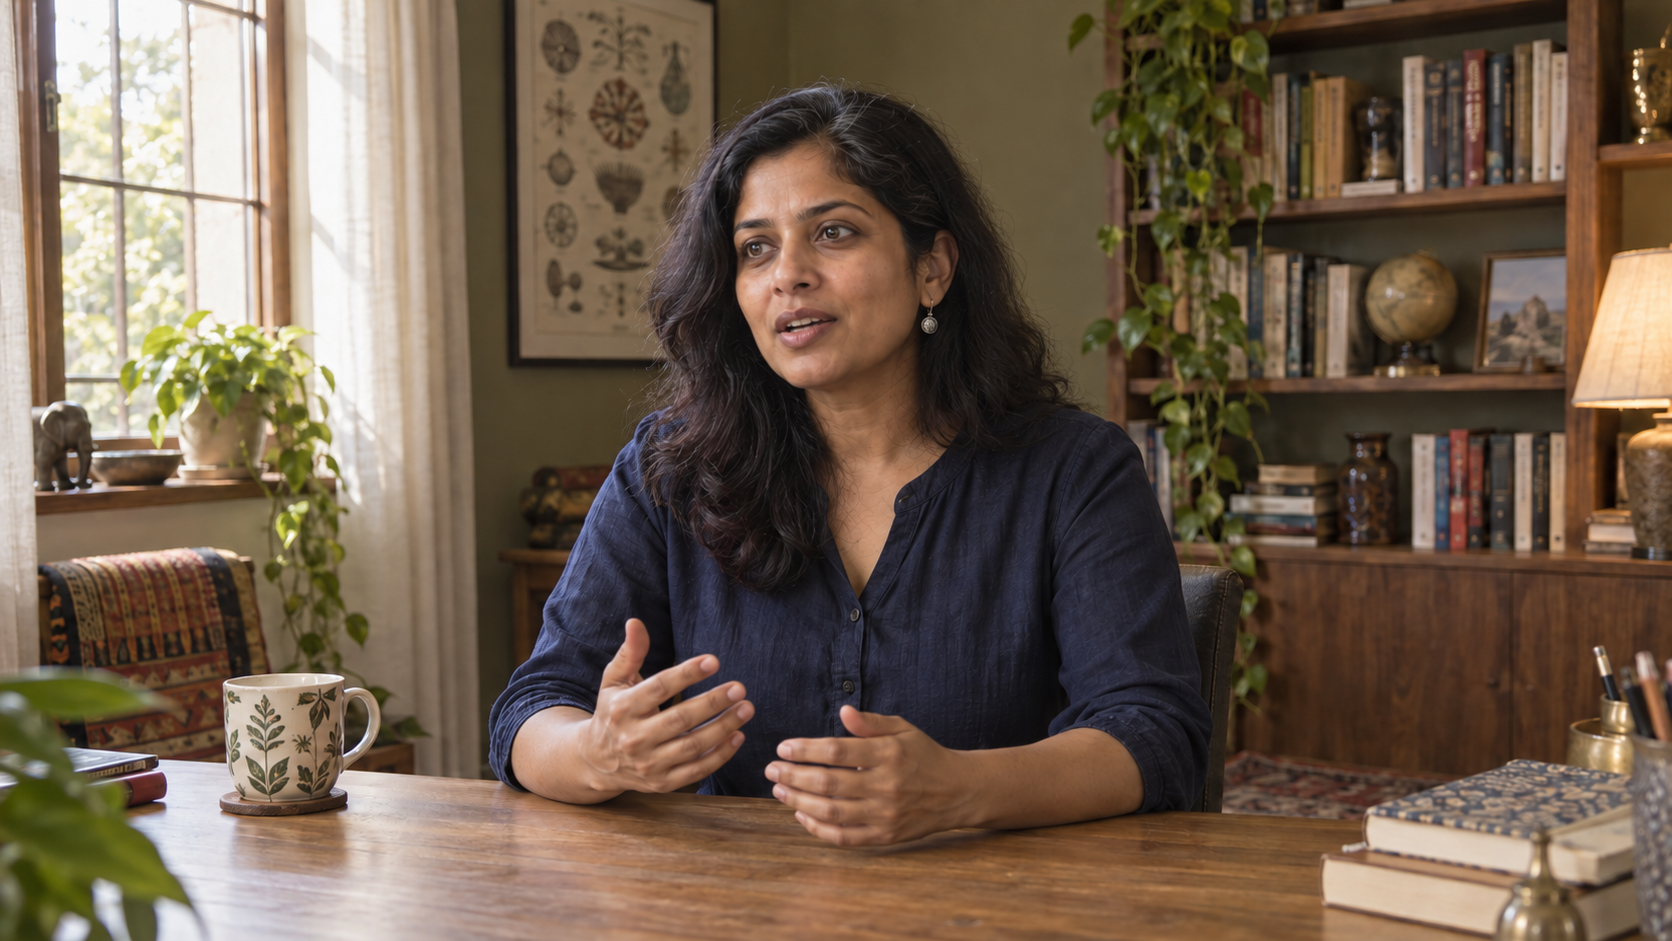
Objectif de continuité : l’identité et les ancres visuelles demeurent stables tandis que la nouvelle phrase commence avec un geste de la main légèrement différent, mais toujours crédible.
Si un saut persiste, insérez un plan secondaire pertinent pendant une ou deux secondes : le carnet du conférencier, un objet qu’elle mentionne ou une vue plus large depuis la même pièce. N’insérez pas de séquences stock aléatoires. Le plan secondaire doit illustrer ou répondre à la phrase prononcée, puis revenir à l’état identique de l’avatar.
Examiner les défaillances de synchronisation labiale, de voix et de continuité
Valider chaque extrait lors de cinq passes distinctes
Première étape : visionnez la vidéo à vitesse normale afin d’en saisir le sens et le rythme naturel. Deuxième étape : désactivez le son et examinez attentivement l’identité, les dents, les lèvres, la mâchoire, les yeux et les mains. Troisième étape : écoutez l’audio sans regarder la vidéo, en prêtant attention à la timbre de la voix, au débit, au bruit ambiant de la pièce et aux cliquetis. Quatrième étape : parcourez pas à pas les douze premières et les douze dernières images de chaque segment. Cinquième étape : visionnez la séquence assemblée sur un lecteur de taille équivalente à celle d’un smartphone, où les changements subtils du visage peuvent apparaître plus marqués.
Rejetez un extrait si la bouche continue de bouger après l’arrêt de la voix, si la forme des dents varie d’une image à l’autre, si la mâchoire glisse latéralement, si la couleur des yeux change, si une main traverse le visage ou si la voix change brusquement d’âge ou de distance. Ne tentez pas de réparer une identité altérée à l’aide d’un filtre de netteté. Relancez uniquement le plus petit segment ayant échoué, à partir du dernier point d’ancrage approuvé.
Lorsque plusieurs échecs partagent une même cause, simplifiez avant de régénérer. Raccourcissez la ligne, supprimez un geste, figez la caméra, agrandissez le visage dans le cadre ou remplacez une référence ambiguë. Seedance Agent s’avère particulièrement utile à ce stade, car il permet de conserver ensemble le paquet de référence, les invites par segment, les sorties réelles, les notes et les points de relance approuvés. Vous pouvez comparer les résultats de H3 avec un flux de travail contrôlé de référence-à-vidéo, plutôt que de reconstruire le projet à partir de fichiers épars.
Conclusion
Un avatar parlant continu fiable de type MiniMax H3 est assemblé à partir de courts segments vocaux facilement révisables : chronométrez le script, maintenez une seule identité et une définition vocale unique de type S1, placez les mots exacts entre balises <d>, terminez chaque extrait sur un point d’ancrage neutre, et assemblez les prises approuvées sur un fond sonore ambiant continu. Cette méthode ne garantit pas une génération infinie ; elle vous offre toutefois une approche reproductible pour construire des explications plus longues, sans compromettre la fidélité du visage, de la voix ou de la synchronisation labiale. Pour planifier les références, les invites, les sorties, les validations et les relances sélectives au sein d’une même production, démarrez un projet d’avatar parlant avec Seedance Agent.
Prêt à essayer par vous-même ?
Mettez en pratique les étapes de ce guide dans Seedance et transformez vos prompts ou images en vidéos abouties en quelques minutes.
Crédits offerts à l'inscription. Forfaits à partir de $20/mois.
Articles associés
D'autres articles dans la même langue à lire ensuite.
Contrôle de la longueur focale de la caméra MiniMax H3 : effets grand angle, normal et téléobjectif
Contrôlez l’aspect apparent de l’objectif sur la MiniMax H3 à l’aide de la taille du plan, de la distance caméra, du langage de zoom, de cadres de référence et d’un test reproductible de prompt allant de 24 mm à 85 mm.
Lire l'article
MiniMax H3 – Flux vidéo à deux personnes : conserver clairement les rôles, le dialogue et les mouvements
Créer une scène vidéo à deux personnes avec MiniMax H3 comportant des étiquettes stables des sujets, un cadrage lisible, un dialogue attribué, des transferts d’objets propres et un flux de travail pratique de vérification des échecs.
Lire l'article
Guide d’accès anticipé à Socialive Catalyst : Préparez un premier pilote utile
Découvrez qui peut accéder à Socialive Catalyst, ce que comprend la version bêta initiale, ce qu’il faut préparer pour une démonstration et comment tester un flux vidéo d’entreprise personnalisé.
Lire l'article