
MiniMax H3 – Flux vidéo à deux personnes : conserver clairement les rôles, le dialogue et les mouvements
AI Overview
MiniMax H3 peut-il générer deux personnes dans une seule vidéo ?
Oui. H3 peut mettre en scène plusieurs personnages, mais chaque personne doit posséder une identité, une position, une action et un rôle parlant distincts. Une courte scène comportant une seule interaction est plus fiable qu’un prompt surchargé impliquant plusieurs mouvements simultanés.
Comment éviter que deux personnages n’échangent leurs identités ?
Attribuez-leur des étiquettes stables telles que Subject 1 et Subject 2, dotez chacun d’une tenue vestimentaire unique et d’une position à l’écran spécifique, et répétez uniquement les caractéristiques devant persister. Utilisez des images de référence distinctes lorsque la précision identitaire est essentielle.
Comment rédiger un dialogue entre deux personnes dans MiniMax H3 ?
Attribuez aux intervenants des identifiants stables tels que S1 et S2, indiquez systématiquement qui parle avant chaque réplique, et placez exclusivement les mots exactement prononcés à l’intérieur de la balise dialogue. Précisez que la bouche de l’interlocuteur reste fermée.
Quel mode H3 convient le mieux à une scène à deux personnages ?
Utilisez le mode texte ou le mode « image initiale » pour une scène simple inventée, le mode « image initiale et image finale » pour une transition contrôlée unique, et le mode « référence complète » lorsque des images séparées, des mouvements ou des éléments vocaux doivent définir précisément les deux personnes.
Choisissez le bon mode H3 pour deux personnes
Laissez la contrainte la plus forte déterminer le mode d’entrée
Le flux de travail vidéo MiniMax H3 à deux personnes commence avant même la rédaction du prompt. Déterminez ce qui doit être strictement contrôlé. Le mode « texte vers audio + vidéo » suffit lorsque les deux personnages peuvent être entièrement inventés. Une seule image initiale est utile lorsque la composition d’ouverture, la tenue vestimentaire et les positions relatives ont déjà une importance capitale. Le mode « image initiale et image finale » s’avère pertinent lorsqu’une interaction unique doit aboutir à une fin prédéfinie — par exemple, le transfert d’une mallette d’une personne à l’autre.
Le mode « référence complète » est plus adapté lorsque le Personnage A et le Personnage B proviennent d’images d’identité différentes, lorsqu’une vidéo distincte fournit les mouvements corporels, ou encore lorsque des références vocales sont nécessaires. MiniMax accepte jusqu’à neuf images de référence, trois vidéos et trois extraits audio, soit un total de douze fichiers de référence. Un fichier audio de référence ne peut pas constituer la seule entrée : il doit obligatoirement accompagner une image ou une vidéo. Ne mélangez pas les tâches de contrôle par images-cadres et celles utilisant le mode « référence complète » au sein d’une même demande.
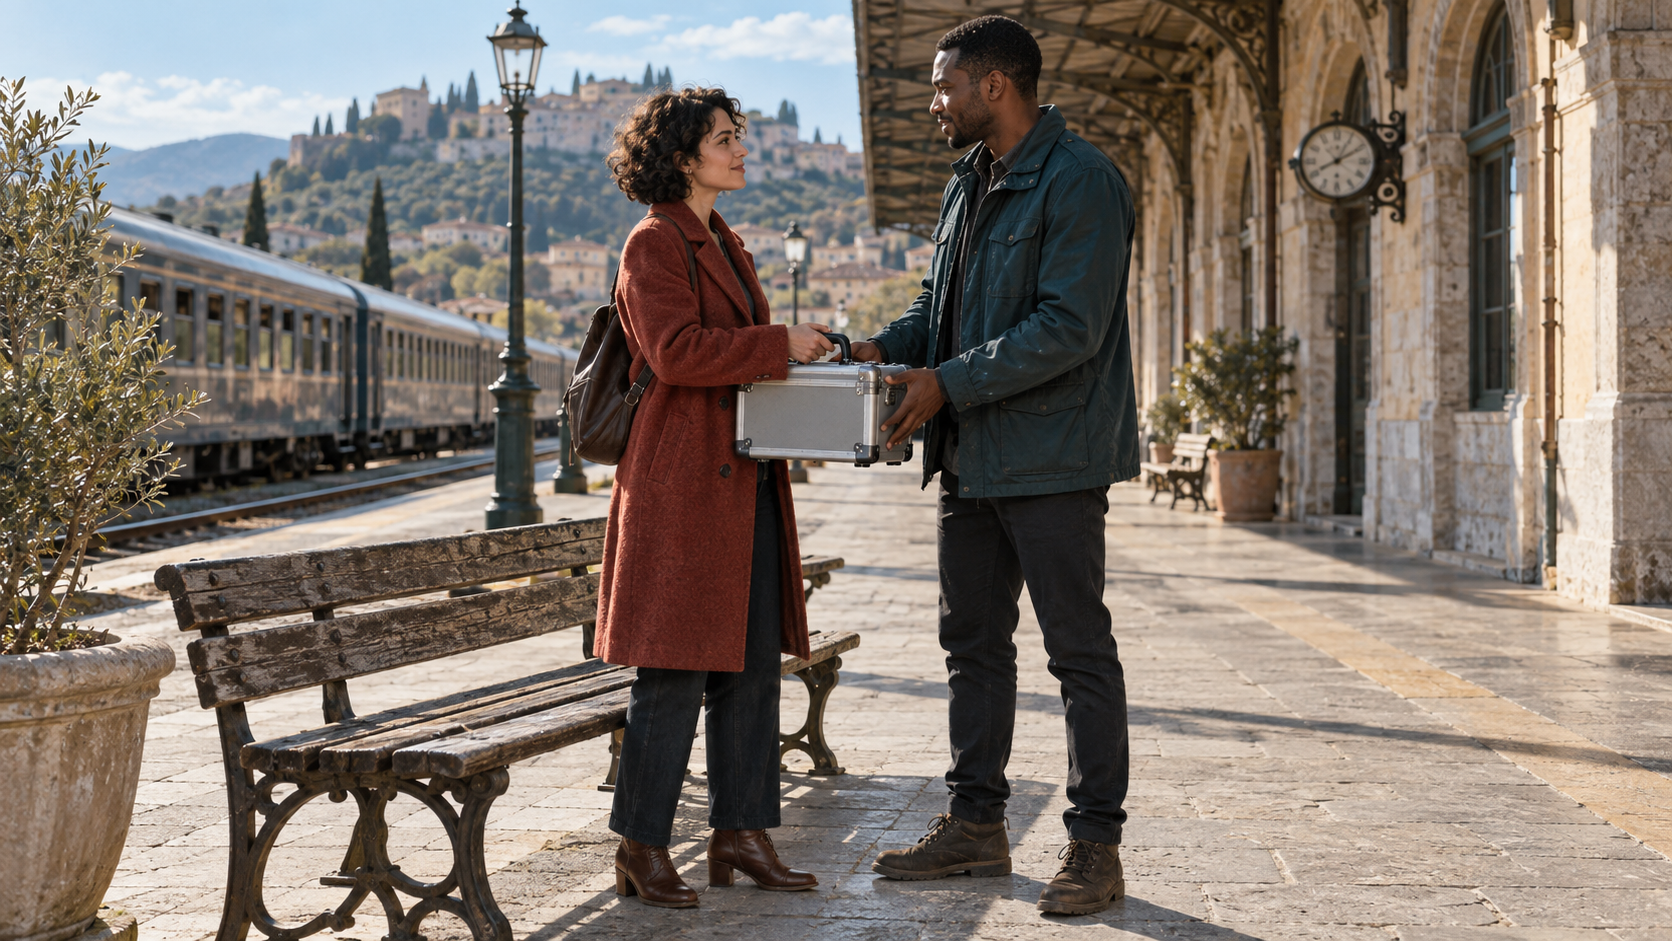
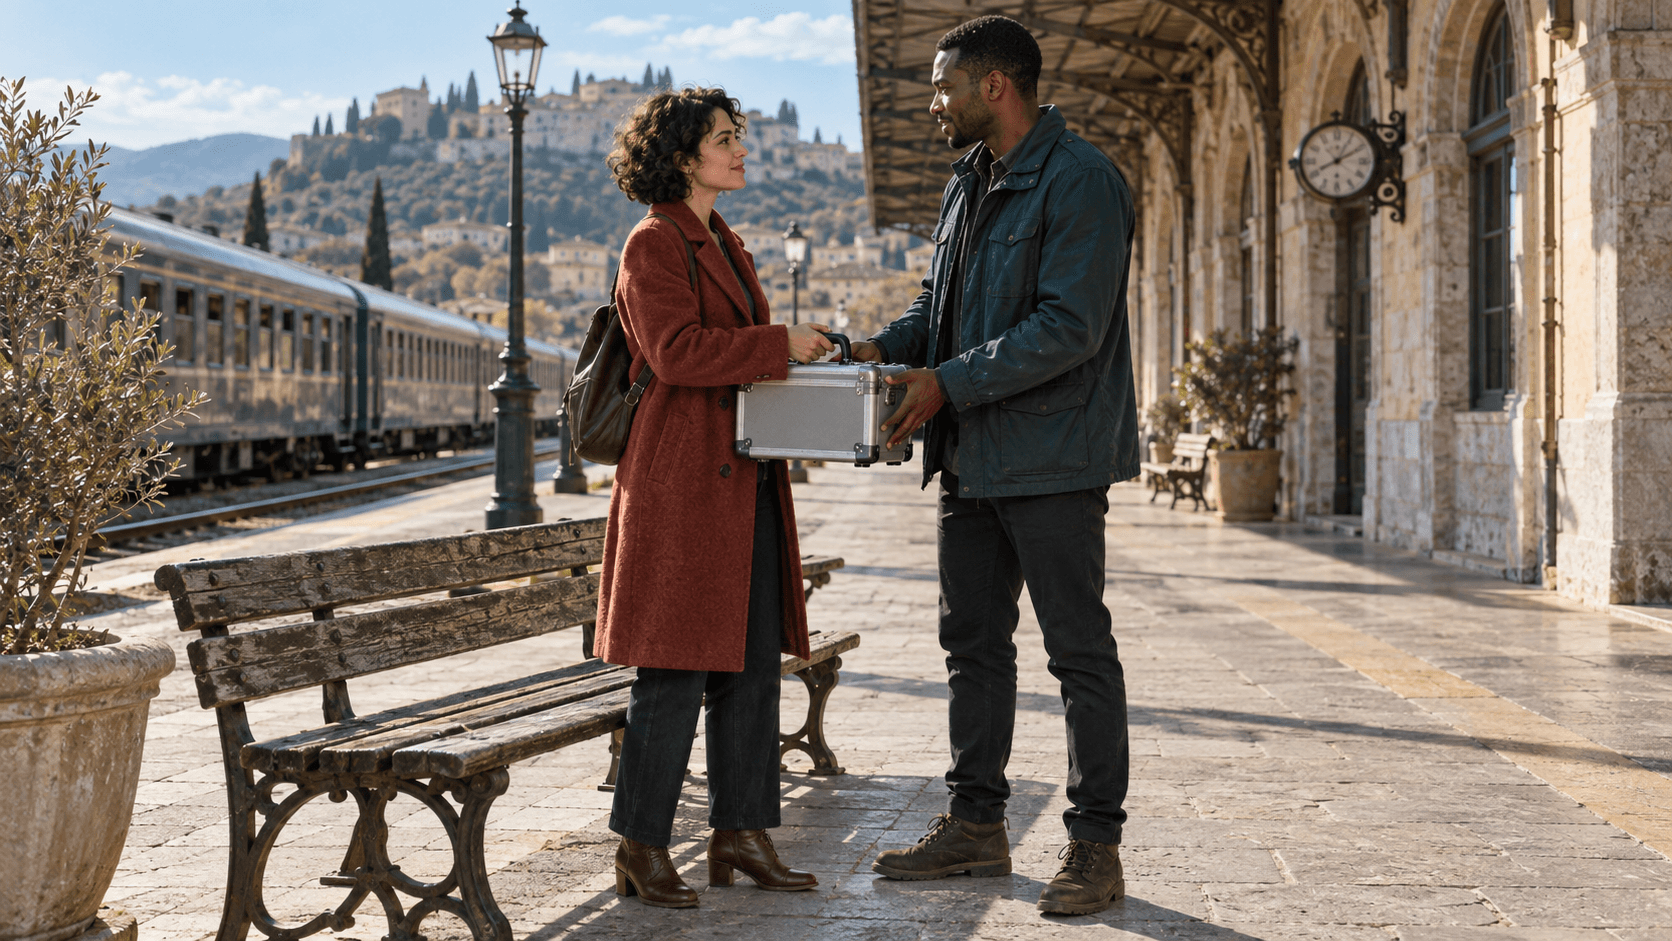
Image de référence générée à titre illustratif : deux manteaux distincts, deux silhouettes séparées, un quai fixe et un objet partagé créent des repères visuels clairs assurant la continuité.
Utilisez la durée comme un « budget d’action ». H3 prend en charge des vidéos de 4 à 15 secondes, mais une durée de 15 secondes ne signifie pas qu’il faut y comprimer davantage d’intrigue. Accordez aux deux personnes un seul « battement causal » : approche, échange et stabilisation ; question, réponse et réaction ; ou entrée, observation et départ. Si la scène exige un second lieu ou une autre action majeure, créez un nouveau clip et reliez-le à l’aide d’un flux de travail multishot reprise.
Définissez Subject 1 et Subject 2
Créez une fiche d’identité et de placement compacte
Décrivez les deux personnages comme des fiches de production distinctes avant de rédiger la chronologie. Chaque fiche doit inclure une identité visible, une tenue vestimentaire, une position initiale, une attribution d’objet, une limite de mouvement, un identifiant de locuteur et une source de référence. Les différences doivent être immédiatement perceptibles d’un coup d’œil ; par exemple, « deux personnes portant des vestes sombres » introduit une ambiguïté inutile.
| Contrôle | Subject 1 | Subject 2 |
|---|---|---|
| Identité | Femme, début trentaine, cheveux bouclés courts et foncés | Homme, milieu trentaine, cheveux très courts |
| Tenue | Manteau en laine rouge rouille, bottes marron | Veste de terrain vert profond, bottes sombres |
| Position initiale | À gauche de l’écran, à côté du banc | À droite de l’écran, près du mur de la gare |
| État de l’objet | Tient la poignée de la mallette | Soutient le corps de la mallette |
| Identifiant de locuteur | S1 | S2 |
| Limite de mouvement | Un pas en avant, relâche la poignée | Reçoit la mallette, fait un pas en arrière |
En mode « référence complète », précisez la contribution de chaque ressource. Une étiquette « sujet » désigne un contenu visuel réutilisable, tandis que les étiquettes « Image », « Vidéo » et « Audio » identifient les supports sources ou les références structurelles. N’attribuez pas l’étiquette Subject 1 à l’ensemble de la première image si celle-ci contient deux personnes et un lieu. Indiquez plutôt que Subject 1 est la femme issue de l’« Image 1 » et que Subject 2 est l’homme issu de l’« Image 2 » ; ne définissez le quai séparément que s’il doit être activement réutilisé.
subject_definitions:
<Subject 1> est la femme de <Picture 1>, conservant ses boucles courtes et foncées, son manteau rouge rouille, son visage et ses bottes marron.
<Subject 2> est l’homme de <Picture 2>, conservant ses cheveux très courts, sa veste vert profond, son visage et ses bottes sombres.
<Subject 3> est la petite mallette d’équipement argentée présentée sur <Picture 3>, conservant sa taille, sa poignée, ses fermoirs et sa finition brossée métallique.
Évitez de redécrire différemment l’un ou l’autre visage dans les plans ultérieurs. Des étiquettes stables réduisent la concurrence entre adjectifs et références. Pour les repères scéniques devant résister aux changements de point de vue, le guide de cohérence environnementale de MiniMax H3 explique comment nommer architecture, direction de la lumière, mobilier et objets du fond sans transformer le prompt en catalogue.
Planifiez l’interaction et la transmission de l’objet
Décrivez les changements d’état, pas seulement les intentions
« Ils échangent naturellement la mallette » masque les images les plus complexes. Décrivez l’état de l’objet dans l’ordre de lecture : Subject 1 tient la poignée ; Subject 2 place ses deux mains sous la mallette ; tous deux la soutiennent brièvement ; Subject 1 ouvre les doigts et retire sa main ; Subject 2 recule avec la mallette ; tous deux se stabilisent. Le modèle dispose ainsi d’un parcours observable, plutôt que d’une action sociale vague.
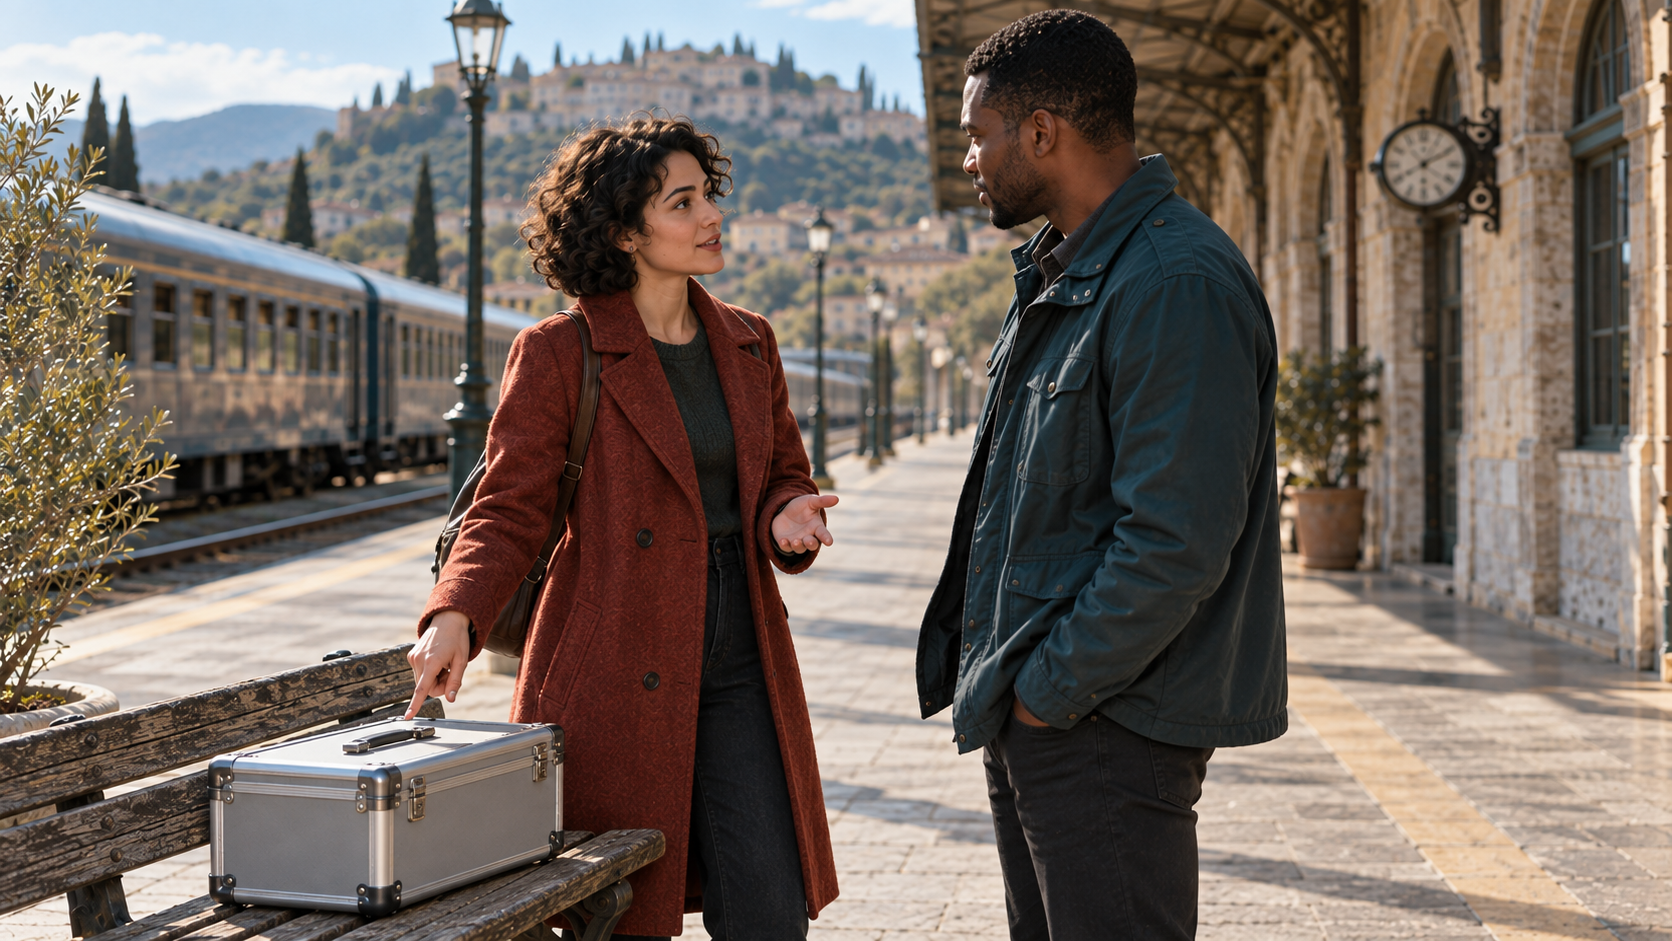
Image générée à titre illustratif : l’orateur effectue le geste, l’auditeur maintient une ligne de regard claire, et la mallette repose à un emplacement stable avant le transfert.
Conservez une terminologie spatiale cohérente. « À gauche de l’écran » et « à droite de l’écran » sont relatifs à la caméra ; « près des voies » et « près du mur de la gare » résistent mieux à un changement d’angle inverse. Lorsqu’un raccord modifie l’orientation, rétablissez la position des deux personnages avant la prochaine action. N’appliquez qu’un seul mouvement de caméra à la fois — par exemple une lente avancée vers le duo — plutôt que de combiner une rotation circulaire, un zoom, un panoramique et une secousse « main levée ».
Les mains échouent lorsque les deux personnages tentent de se croiser physiquement ou lorsque la consigne omet une phase de contact. Accordez à la mallette une taille suffisante pour permettre deux prises lisibles, évitez que l’un ou l’autre corps ne traverse l’espace occupé par l’autre, et laissez l’échange durer plusieurs secondes. Une fin propre est essentielle : identifiez qui détient la mallette, où se tient chaque personne, vers où elles regardent, et si l’une ou l’autre bouche est en mouvement.
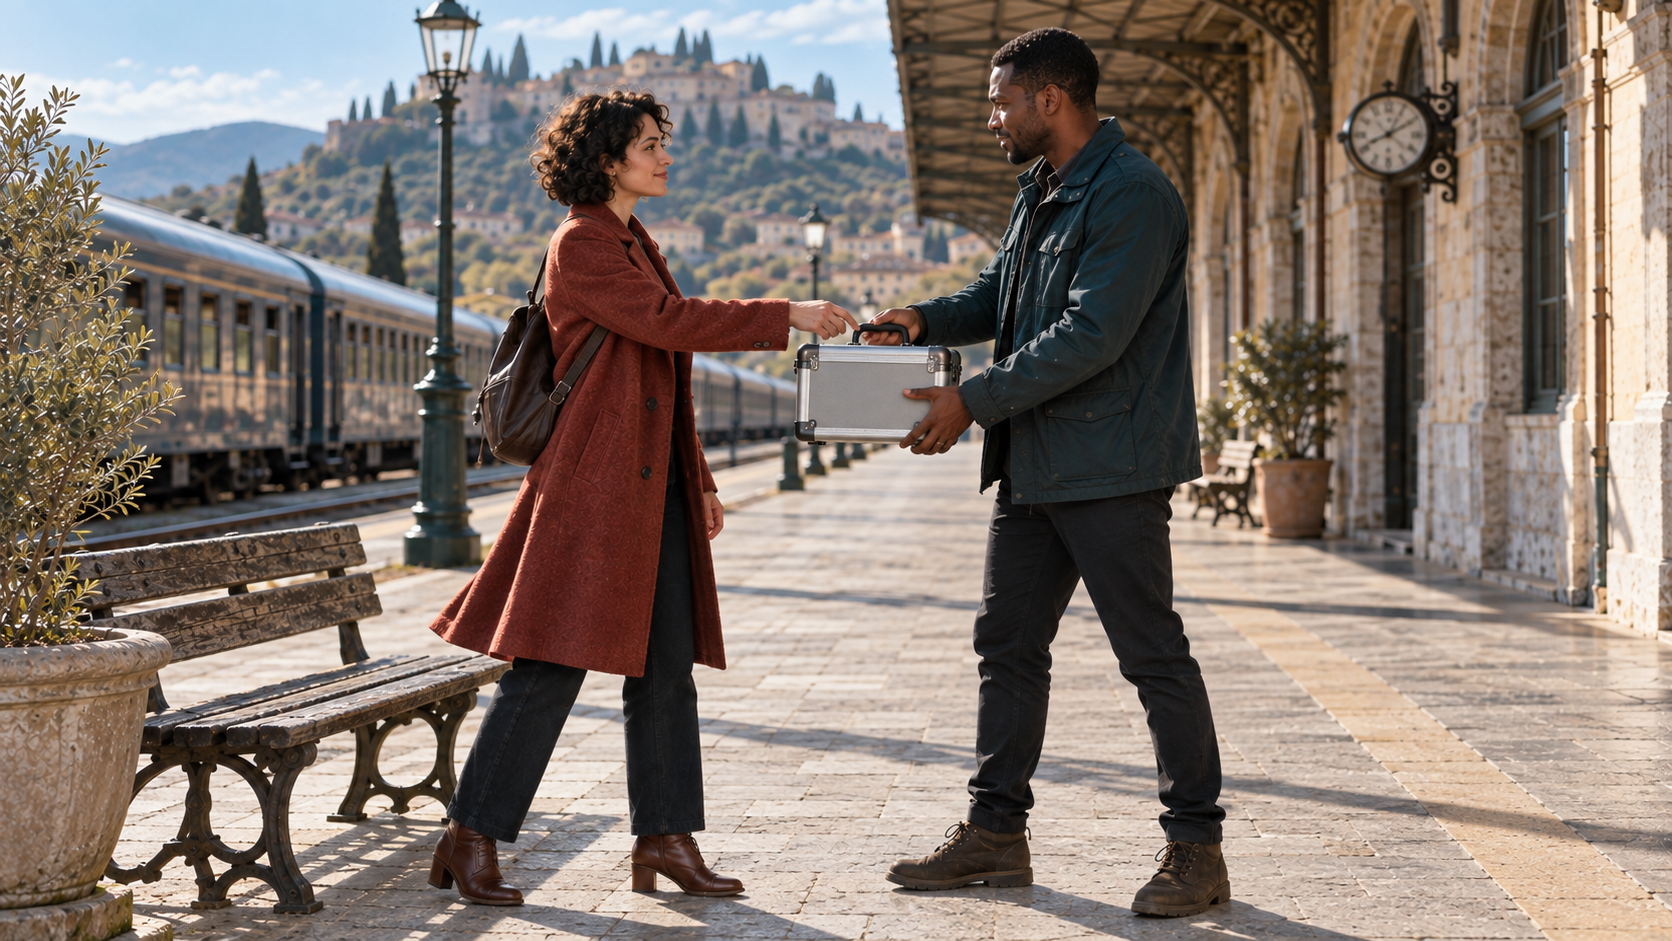
Image générée à titre illustratif : vérifiez la séparation des mains, la géométrie du accessoire, la continuité des manteaux et l’absence d’un bras supplémentaire pendant le contact partagé.
Contrôler le dialogue entre deux interlocuteurs et le son
Attribuer chaque réplique et chaque battement d’écoute
Le guide de base officiel de MiniMax utilise des identifiants stables pour les orateurs, tels que S1 et S2. Placez la phrase d’identification, l’identifiant de l’orateur, la livraison et l’action en dehors de la balise de dialogue ; conservez uniquement la balise linguistique et le contenu exact prononcé à l’intérieur de celle-ci. Lorsque les deux personnages parlent simultanément, un identifiant composé tel que S1,S2 est pris en charge, mais le dialogue superposé constitue un test plus difficile qu’un échange alterné de répliques.
La femme vêtue d’un manteau rouille-rouge (S1) regarde la mallette et dit doucement : <d>[Anglais] Gardez ceci avec vous jusqu’au prochain arrêt.</d> Subject 2 écoute et ses lèvres restent closes.
L’homme vêtu d’une veste turquoise (S2) reçoit la mallette, croise son regard et répond : <d>[Anglais] Je comprends.</d> Subject 1 écoute et ses lèvres restent closes.
Utilisez des répliques courtes adaptées au plan visible. Précisez quand la parole cesse, quand la mâchoire se referme et quand l’auditeur réagit. Intégrez l’ambiance du lieu, les pas, les cliquetis des fermoirs de la mallette et les froissements des vêtements dans la bande sonore globale, sans les répéter comme éléments de dialogue. Placez la musique destinée exclusivement au public dans le champ « musique non diégétique ». Si un commentaire vocal provient hors-champ, indiquez-le explicitement comme « commentaire vocal hors-champ » et maintenez les lèvres du personnage à l’écran fermées.
Sortie réelle de Seedance, et non résultat de MiniMax H3 : utilisez un extrait contrôlé mono-orateur comme référence pour les mouvements labiaux, le rythme et le bruit ambiant de la pièce avant d’évaluer un échange plus complexe entre deux personnes.
Pour les voix récurrentes sur plusieurs extraits, le guide de cohérence vocale de Seedance propose un examen auditif portant sur le timbre, le débit, le niveau sonore, le bruit ambiant de la pièce et la séparation entre orateurs.
Élaborer un plan de continuité en trois plans
Faire en sorte que chaque raccord hérite d’un état verrouillé
Trois plans courts suffisent pour de nombreuses scènes à deux personnages. Le plan 1 établit les deux sujets, le quai et la propriété initiale de la mallette. Le plan 2 se rapproche pour le transfert et contient une réplique de chaque orateur. Le plan 3 confirme le nouveau propriétaire de la mallette et accorde aux deux personnages une réaction silencieuse. Attribuez à chaque plan un état initial, une action, un comportement de caméra, un son et un état final verrouillé.
La fin du plan 1 doit correspondre exactement au début du plan 2. Si la mallette repose sur le banc au moment du raccord, elle ne peut pas apparaître dans les mains de Subject 2 dès la première image suivante sans qu’un ramassage visible ne soit montré. Si Subject 1 se tient côté voies, ne la faites pas pivoter vers le mur de la gare sans que le raccord et l’orientation de la caméra ne l’expliquent. Le workflow multi-cadre-clés de MiniMax H3 montre comment affecter des cadres ordonnés à une chronologie maîtresse, sans les traiter comme un collage vertical de storyboards.
Le guide de base de H3 autorise des instants précis de raccord après le plan 1. N’utilisez-les que lorsqu’ils sont utiles, et maintenez les intervalles continus. Un plan pratique de 12 secondes serait ainsi réparti ainsi : 0–4 secondes pour l’établissement, 4–9 secondes pour l’échange, et 9–12 secondes pour la tenue finale. Les deux dernières secondes ne doivent pas introduire une nouvelle action.
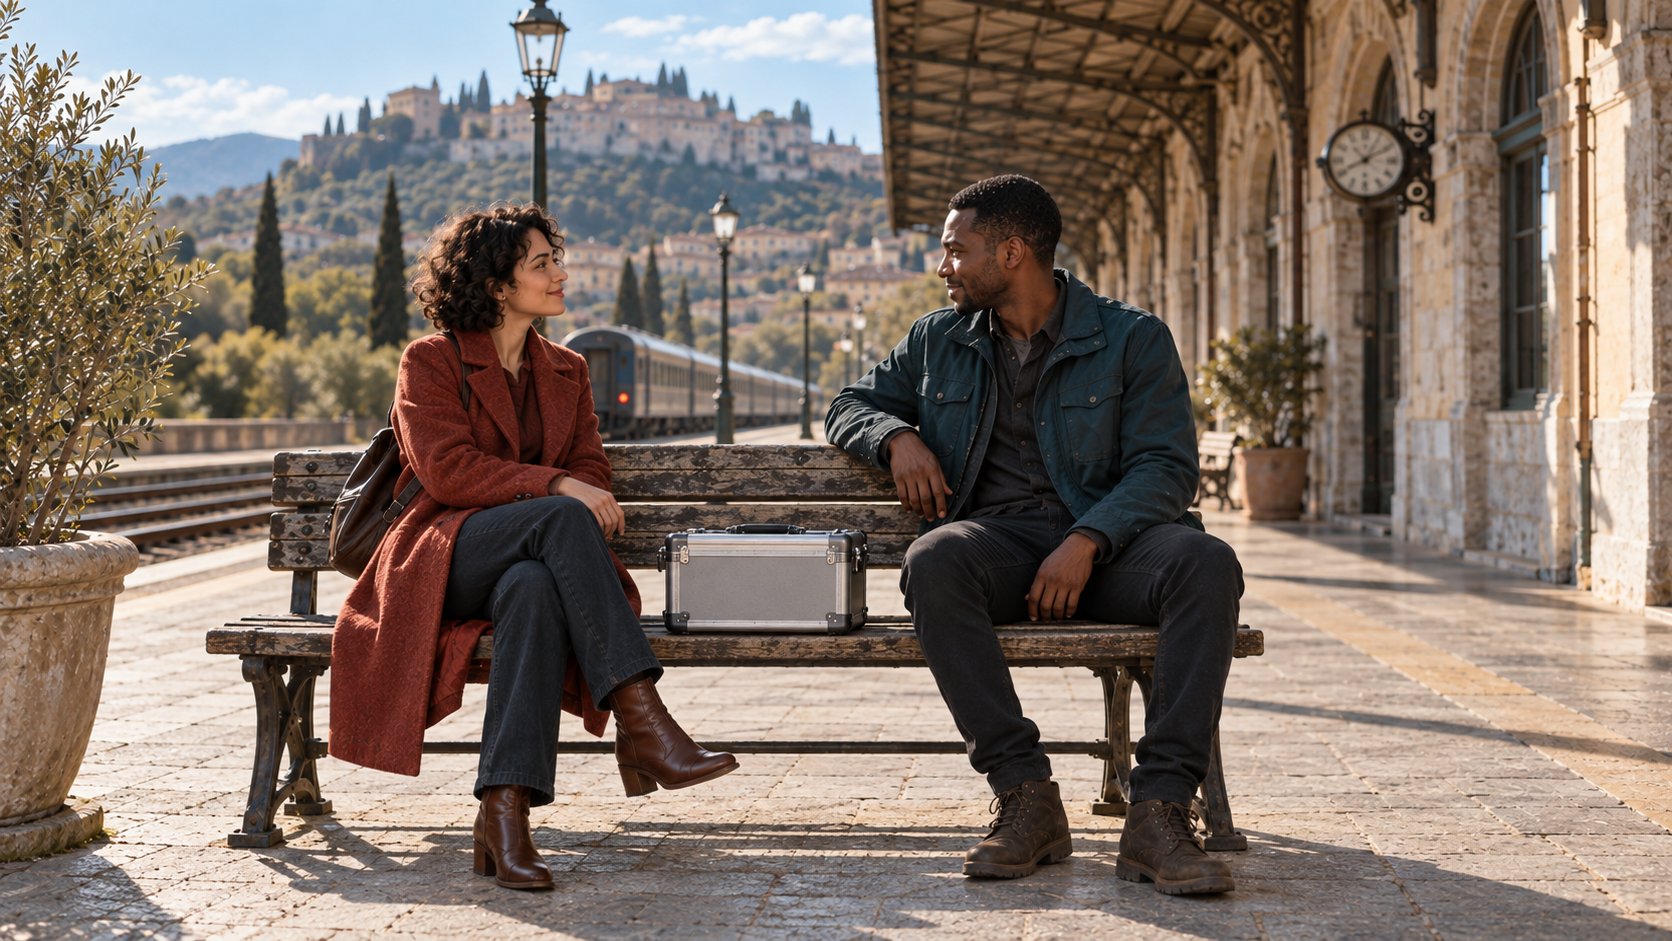
Image générée à titre illustratif : les mêmes visages, manteaux, banc, gare, mallette et éclairage rendent facile la détection d’une dérive de continuité.
Examiner les échecs et relancer la plus petite partie concernée
Associer chaque échec visible à une seule modification de la consigne
Examinez la vidéo complète à vitesse normale, puis inspectez le transfert et le dialogue à vitesse réduite (moitié). Si les identités s’inversent, renforcez la correspondance sujet-référence et simplifiez le raccord. Si les visages se confondent dans un plan large, augmentez la séparation entre les sujets ou déplacez le dialogue vers un plan moyen à deux personnages ; le guide de réparation des visages lointains couvre les choix de cadrage et de références adaptés à ce problème.
title: Workflow vidéo à deux personnes avec Minimax H3 description: Guide technique pour générer des vidéos cohérentes avec deux personnages interactifs, y compris le blocage spatial, le transfert d’accessoires, le dialogue synchronisé et la continuité en trois plans. tags: AI video generation Minimax H3 two-person workflow dialogue blocking prop handoff continuity planning| Échec | Cause probable | Plus petite modification utile | | --- | --- | --- | | Les personnages échangent leurs rôles | Tenues similaires ou étiquettes ambiguës | Rétablir des étiquettes, des vêtements, des positions et des identifiants de locuteur distincts | | Les deux bouches bougent | Le comportement de l’auditeur n’est pas spécifié | Ajouter « écoute, les lèvres restent fermées » après chaque ligne | | Un bras supplémentaire apparaît | La phase de transfert omet un état de contact | Étendre les phases de soutien partagé et de relâchement | | Le accessoire change de forme | Trop d’actions ou définition trop faible de l’accessoire | Verrouiller les dimensions, la poignée, la finition et le propriétaire final | | Les regards se déconnectent après le raccord | Les positions ne sont pas rétablies | Préciser à nouveau les deux positions ainsi que le regard sous le nouvel angle | | L’environnement est réinitialisé | Les ancres de scène étaient implicites | Répéter la plateforme, le banc, le train, la direction de la lumière et l’heure |
Ne recréez pas une bonne mise en place simplement parce qu’une image de transfert échoue. Enregistrez les références de personnages acceptées, la version de l’invite, la graine (seed) ou l’enregistrement de la tâche si disponibles, la sortie et la note d’échec. Puis relancez la prise la plus petite avec une seule modification corrective. Seedance Agent peut organiser ces références, comparer les candidats, conserver l’état d’approbation et acheminer uniquement le segment ayant échoué via un flux de travail référence-vers-vidéo.
Conclusion
Un flux de travail vidéo fiable pour deux personnes (MiniMax H3) repose sur le mode d’entrée approprié, deux fiches de sujets parfaitement distinctes, des identifiants de locuteur (S1 et S2) stables, une interaction causale unique, des changements d’état explicites de l’accessoire, et un plan de raccords dont les états finaux correspondent aux ouvertures suivantes. Examinez séparément l’identité, la propriété des mouvements buccaux, les mains, les regards, la géométrie de l’accessoire, l’environnement et le son, puis relancez uniquement le passage ayant échoué. Pour conserver ensemble les références, les prises, les approbations et les révisions ciblées, construisez la séquence à deux personnages avec Seedance Agent.
Prêt à essayer par vous-même ?
Mettez en pratique les étapes de ce guide dans Seedance et transformez vos prompts ou images en vidéos abouties en quelques minutes.
Crédits offerts à l'inscription. Forfaits à partir de $20/mois.
Articles associés
D'autres articles dans la même langue à lire ensuite.
Guide d’accès anticipé à Socialive Catalyst : Préparez un premier pilote utile
Découvrez qui peut accéder à Socialive Catalyst, ce que comprend la version bêta initiale, ce qu’il faut préparer pour une démonstration et comment tester un flux vidéo d’entreprise personnalisé.
Lire l'article
FramePack Torch CUDA non activé : diagnostiquer et corriger l’environnement approprié
Résoudre le problème de FramePack lorsque PyTorch ne prend pas en charge CUDA, en vérifiant précisément le runtime Python, en remplaçant un wheel compatible uniquement avec le CPU, en gérant la compatibilité avec les pilotes ou les cartes graphiques RTX, et en validant la correction.
Lire l'article
Tutoriel Google Vids sur l’avatar personnel : enregistrement, saisie de l’invite et résolution des problèmes
Créez un avatar personnel Google Vids, réussissez la capture du visage et de la voix, rédigez une invite utile pour Gemini Omni, résolvez les problèmes d’accès manquants et gérez votre enregistrement.
Lire l'article