
AI Overview
FramePack을 정말로 6GB VRAM에서 실행할 수 있나요?
예, 공식 프로젝트에서는 NVIDIA RTX 30-, 40-, 및 50-시리즈 GPU에 대해 6GB를 최소 요구 사양으로 명시하고 있습니다. 이는 빠른 생성을 보장하는 것이 아니라, 최소한의 작동을 위한 기준입니다.
Windows에서 FramePack을 가장 안전하게 설치하려면 어떻게 해야 하나요?
공식 원클릭 패키지를 사용하세요. 이를 간단한 로컬 경로에 압축 해제한 후 update.bat를 실행하고, 그 다음 run.bat를 실행합니다. 첫 번째 테스트 시에는 기본 attention 및 TeaCache 설정을 그대로 두세요.
FramePack에서 발생하는 CUDA 메모리 부족 오류를 어떻게 해결하나요?
다른 GPU 기반 애플리케이션을 닫고, 프로세스를 재시작한 후 기본 워크플로우를 테스트하세요. 또한 시스템 메모리에 가해지는 경쟁적 부담을 줄이세요. 효과를 측정 가능하게 하기 위해 최적화를 하나씩만 추가하세요.
6GB GPU에서는 TeaCache을 활성화해야 하나요?
기본 설정으로 깨끗한 렌더링이 성공한 후에만, 빠른 초안 생성을 위해 TeaCache을 사용하세요. 공식 안내에서는 이 기능이 품질 저하를 유발할 수 있다고 경고하고 있으므로, 중요한 최종 출력물은 전체 확산(full diffusion) 방식으로 생성하세요.
6GB 지원이 실제로 의미하는 바
FramePack은 비디오 길이 증가에 따라 작업 메모리가 함께 증가하지 않도록 설계되었습니다. 프레임 컨텍스트 패킹(frame-context packing)과 드리프트 방지 스케줄링(anti-drift scheduling)을 통해 모델이 순차적으로 스트리밍되면서도 활성 계산량을 제한합니다. 이러한 설계 덕분에 공식 프로젝트는 RTX 3060 노트북(6GB VRAM)에서도 13B 모델로 비디오를 생성하는 것을 시연할 수 있습니다. 그러나 이는 워크플로우의 모든 부분이 경량화된다는 의미는 아닙니다. 모델 파일 자체는 여전히 30GB 이상의 디스크 공간을 필요로 하며, 시스템 RAM 및 가상 메모리가 과부하될 수 있고, 긴 생성 시간이 소요될 수도 있습니다.
지원되는 기준 사양 역시 구체적입니다. 공식 README에서는 fp16 및 bf16을 지원하는 NVIDIA RTX 30-, 40-, 또는 50-시리즈 GPU를 탑재한 Windows 또는 Linux 환경을 명시합니다. GTX 10- 및 20-시리즈 카드는 명시적으로 ‘테스트되지 않음(untested)’으로 표기되어 있습니다. 6GB VRAM은 6GB 시스템 RAM과 동일하지 않으며, 최소 사양을 충족한다고 해서 실험적 양자화(quantization), 타사 노드(third-party nodes), 모든 attention 커널, 또는 공격적인 캐시 설정이 모두 호환된다고 보장하지 않습니다.
이 FramePack 6GB VRAM 설정 가이드는 하나의 검증된 렌더링 결과를 얻기 위한 통제된 경로로 간주하세요. 먼저 공식 애플리케이션, 모델, 그리고 기본 설정이 정상 작동함을 입증하세요. 그런 다음 한 번에 하나의 변경 사항만 적용하여 실패 시 원인을 GPU 용량, 환경, 또는 최적화 중 어느 하나로 명확히 추적할 수 있도록 하세요.
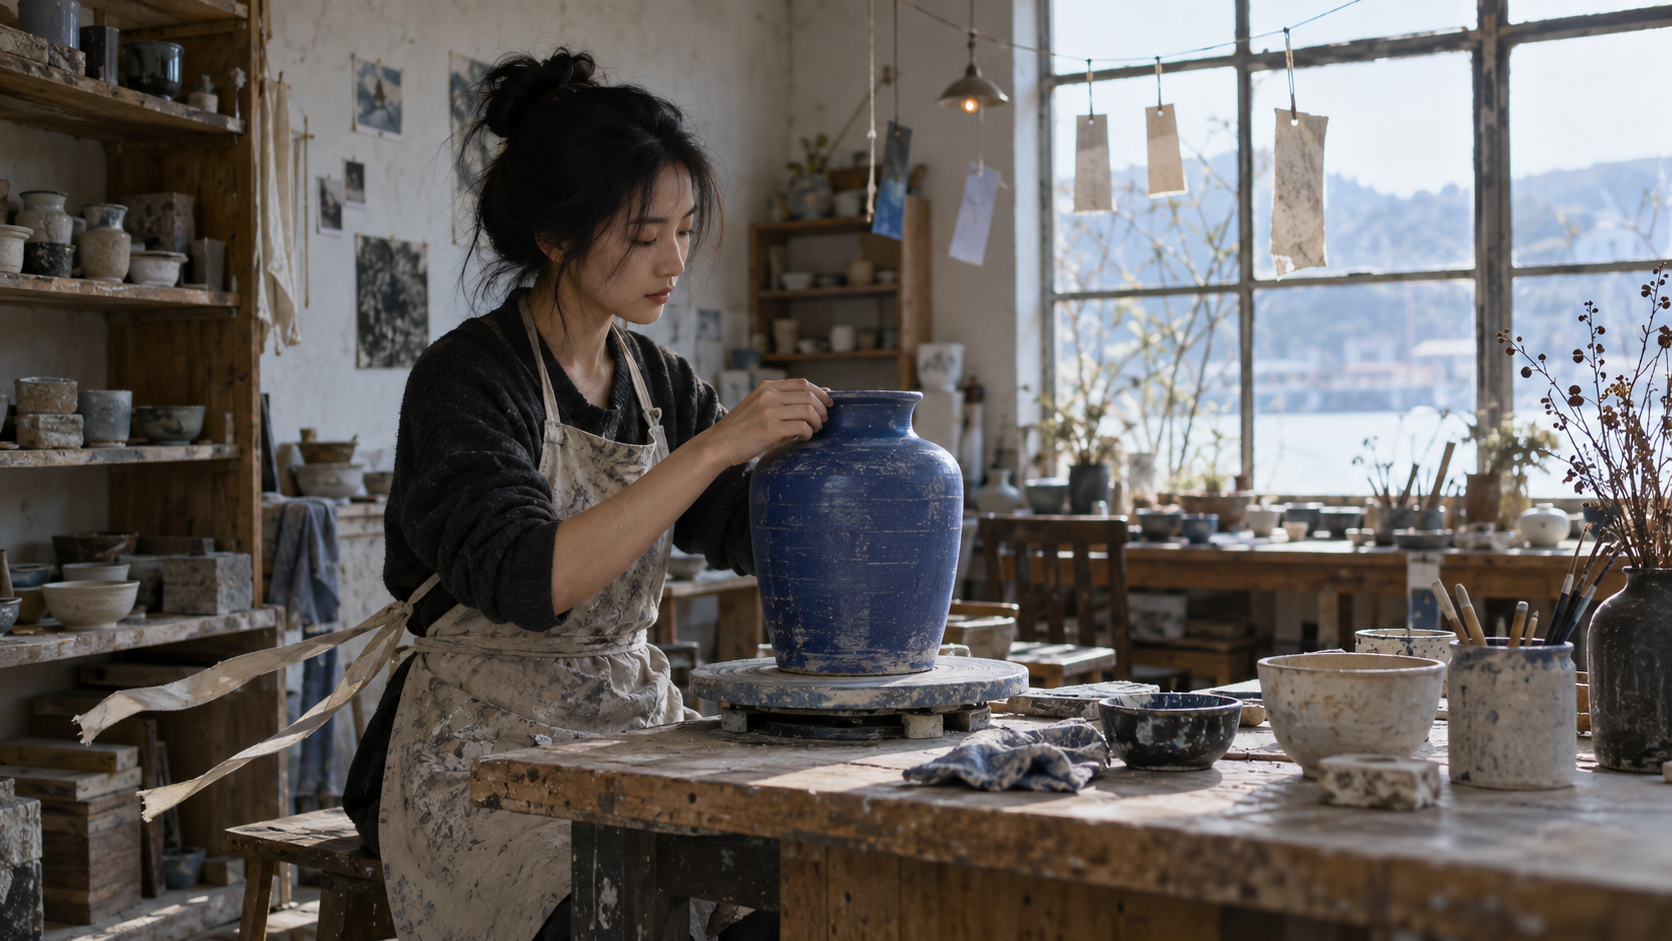
벤치마크용 FramePack 출력이 아닌 설명용 소스 프레임 개념 이미지입니다. 명확한 피사체, 읽기 쉬운 실루엣, 복잡하지 않은 배경은 혼란스러운 액션 장면보다 6GB 환경에서의 첫 번째 테스트에 더 적합합니다.
Windows 또는 Linux 준비
6가지 항목의 사전 점검 수행
다운로드 전에 다음 6가지를 확인하세요: 최소 6GB VRAM을 갖춘 지원되는 NVIDIA RTX GPU; 최신 드라이버; 패키지 및 종속성, 그리고 자동 다운로드되는 모델 파일(30GB 이상)을 저장할 충분한 여유 디스크 공간; 짧은 로컬 설치 경로; 안정적인 네트워크 접속; 해당 폴더 내 파일 생성 권한. 메모리가 최소 사양인 기기에서는 첫 실행 전에 게임, 3D 소프트웨어, GPU 가속을 사용하는 브라우저 탭, 기타 로컬 AI 서버를 모두 종료하세요.
입력은 절제된 수준으로 유지하세요. 하나의 주요 인물 또는 객체가 중심에 있는 깔끔한 정지 이미지, 단순한 배경, 그리고 한 문장으로 묘사 가능한 동작을 선택하세요. 첫 실행은 환경 점검이며, 최종 창의적 작업 지시사항이 아닙니다. 로컬 설정을 유지할 가치가 있는지 판단하려면, 단순히 광고된 VRAM 용량이 아니라 클라우드 GPU 벤치마크와 전체 작업량을 비교하세요.
Windows의 경우, 공식 원클릭 패키지는 이미 CUDA 12.6와 PyTorch 2.6를 함께 제공합니다. 기준선이 작동하기 전까지는 내부에 별도의 Python 환경을 추가하지 마세요. Linux의 경우, 기존 ComfyUI 또는 시스템 Python이 패키지를 무시하고 대체하지 않도록 독립적인 Python 3.10 환경을 사용하세요. 이와 동일한 격리 원칙은 로컬 AI 비디오 설정 가이드에도 적용됩니다. 드라이버 버전, 설치 폴더, 여유 디스크 공간을 기록하세요. 나중에 버그 보고 시 “멈췄다”는 모호한 표현보다 이 세 가지 정보가 훨씬 유용합니다.
공식 소스에서 FramePack 설치
Windows 원클릭 경로
개발자가 공식 FramePack 프로젝트로 지정한 저장소에서만 다운로드하세요. 프로젝트는 모조 사이트에 대해 경고하고 있으므로, 어떤 패키지도 실행하기 전에 저장소 소유자를 반드시 확인하세요. 압축 파일을 D:\\FramePack과 같은 짧은 경로에 완전히 압축 해제하세요. 압축 파일 내부에서 직접 실행하거나, 깊게 중첩된 클라우드 동기화 폴더에서 실행하면 피할 수 있는 파일 및 권한 문제를 유발할 수 있습니다.
update.bat를 한 번 실행하고 완료될 때까지 기다린 후, run.bat를 실행하세요. 첫 실행 시에는 큰 모델 파일 다운로드 및 초기화 과정에서 일시적으로 아무런 반응이 없는 것처럼 보일 수 있습니다. 브라우저를 반복해서 새로 고치기보다는 터미널 출력을 주의 깊게 관찰하세요. 워밍업 중 진행률 막대가 잠시 멈추었다고 해서 중단하지 마세요. 이후 업데이트로 인해 작동하던 설치가 손상된 경우, 새 복사본이 동일한 정상성 검사를 통과할 때까지 마지막으로 정상 작동했던 폴더를 보관하세요.
Linux 환경 경로
깨끗한 Python 3.10 환경을 생성하고 활성화한 후, 공식 PyTorch 인덱스에서 CUDA 12.6 PyTorch 패키지를 설치하세요. 그 다음 FramePack 요구 사항을 설치하고, python demo_gradio.py를 시작합니다. 이 환경은 FramePack 전용으로 유지하세요. 대규모 ComfyUI 환경과 혼합하면, pip가 성공적으로 설치했다고 보고하더라도 Torch, Triton 또는 attention 관련 패키지 간 상호 불호환 문제가 발생할 수 있습니다.기본 경로는 PyTorch 어텐션을 사용합니다. FramePack은 또한 xformers, FlashAttention 및 SageAttention을 지원하지만, 이는 모든 기능을 설치하라는 지시가 아닙니다. 가장 깔끔한 기준점인 기본 설정으로 시작하세요. INT8 및 INT4 인코더 선택 비교 시에도 유사한 원칙이 유용합니다: 최종 출력이 검토를 통과하는 한에서만, 더 작은 메모리 사용량이 유의미합니다.
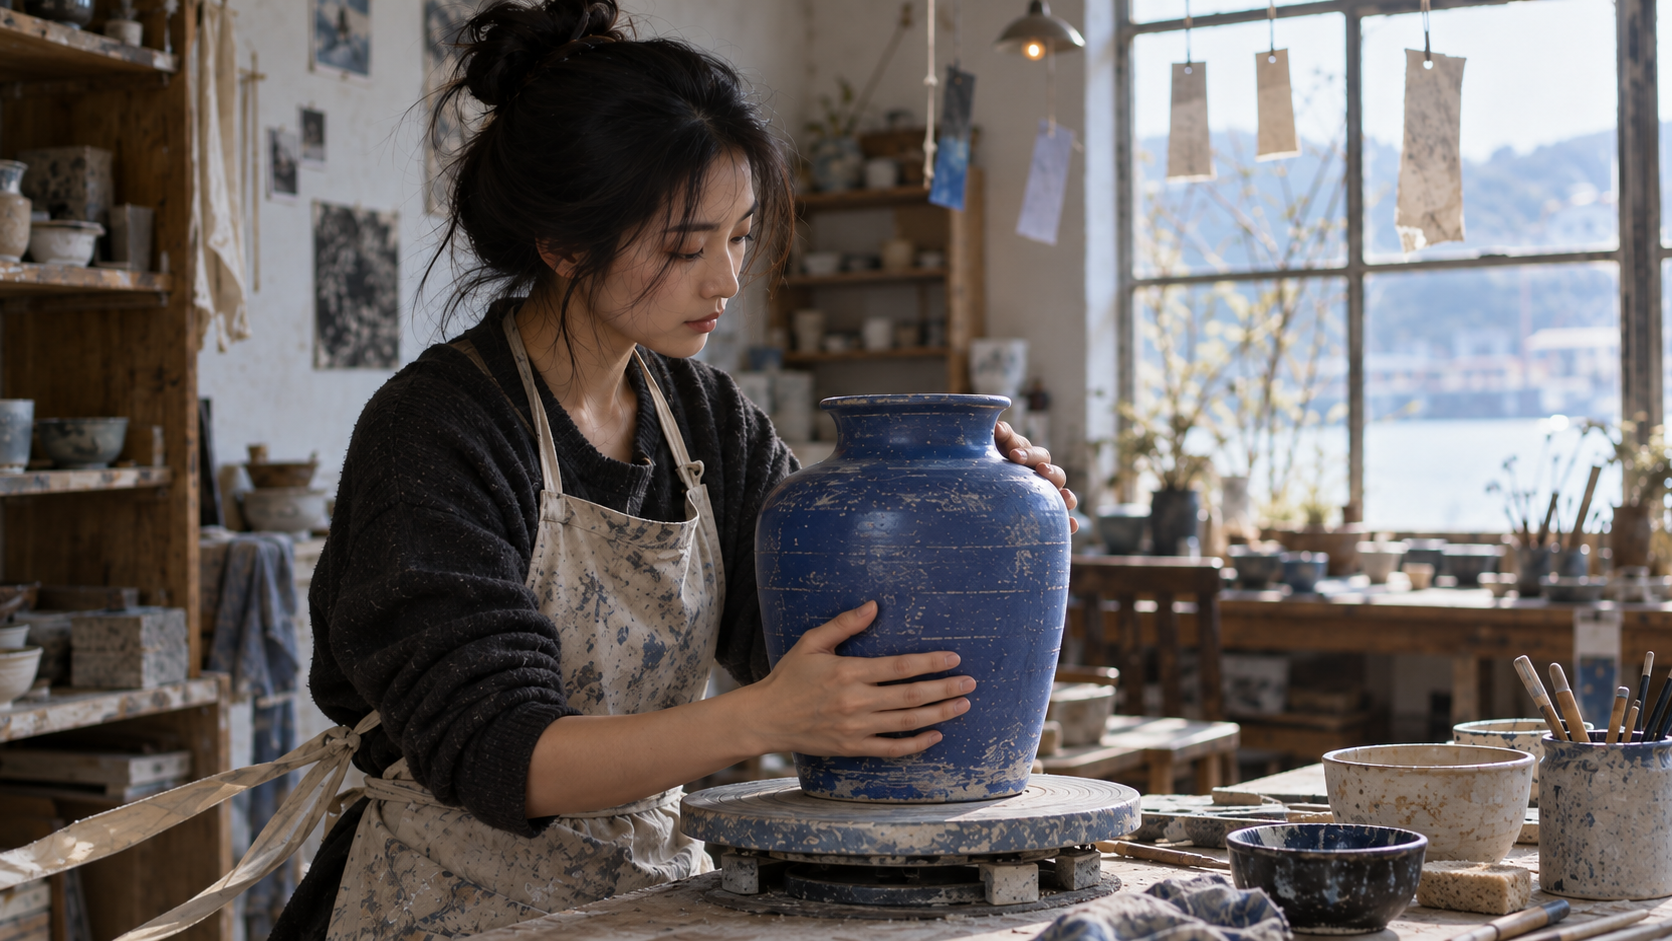
설명용 첫 프레임 후보입니다. 환경을 변경하기 전에 이 이미지, 프롬프트, 시드(seed), 설정을 반드시 저장해 두어 각 테스트가 안정적인 시각적 기준을 갖도록 하세요.
6GB 정상성 검사 실행
변수 고정
공식 기본값을 사용하고, TeaCache은 비활성화하며, 첫 렌더링 시 SageAttention, bits-and-bytes 양자화 또는 GGUF는 피하세요. 이 프로젝트에서는 이러한 기본 구성을 ‘정상성 검사(sanity check)’라 부릅니다. 준비된 이미지를 로드하고, 주체와 움직임을 우선시하는 간결한 모션 프롬프트를 작성하세요. 예: “도예가가 코발트 화병을 시계 방향으로 천천히 돌리고, 창문에서 들어오는 빛 속에서 유약 상태를 확인한 후, 양손을 고정시켜 멈춘다. 카메라는 고정되어 있다.”
다음 네 열을 가진 소규모 테스트 기록을 저장하세요: 빌드 및 환경, 입력 및 프롬프트, 변경된 설정, 결과. 첫 번째 행은 “공식 기본값; 변경 없음”이어야 합니다. 앱이 모델을 로드하고, 샘플링을 시작하며, 재생 가능한 파일을 완성하고, 기본 주체를 보존할 경우에만 테스트를 통과합니다. 속도는 차선입니다. 6GB GPU에서 성공적이지만 느린 실행은 환경이 작동함을 입증하는 근거이며, 즉각적인 충돌은 모델 자체가 불가능하다는 증거가 아닙니다.
워밍업(warmup)으로 인해 초반부가 이후 구간보다 느리게 보일 수 있습니다. 진단 전에 터미널이 명시적으로 완료되거나 오류를 출력할 때까지 기다리세요. 전체 출력을 다시 재생하여 주체 이탈(subject drift), 장면 교체(scene replacement), 움직임 정체(stuck motion), 마지막 초의 손상 등이 있는지 확인하세요. 약한 재생 가능 파일은 창의적인 결과일 수 있지만, CUDA 예외는 시스템 실패입니다.
이는 공식 프로젝트 페이지에서 실제로 생성된 FramePack 출력이며, Seedance 렌더링이나 속도 보장이 아닙니다. 목적은 발표된 6GB 경로가 연속적인 모션을 생성할 수 있음을 입증하는 것입니다.
실패를 은폐하지 않고 속도 조정
드래프트-최종 단계식 접근법 사용
기본 실행이 성공하면 세 단계의 계단식 접근법을 만드세요. 첫 번째 단계는 변경되지 않은 품질 기준입니다. 두 번째 단계는 아이디어 탐색을 위해 TeaCache 같은 하나의 속도 향상 기능을 활성화합니다. 세 번째 단계는 선택된 최종 테이크를 위해 전체 디퓨전을 복원합니다. 각 단계에서 동일한 입력, 프롬프트, 그리고 유사한 길이를 비교하세요. 벽시계 시간(wall time), 사용 가능한 경우 최대 VRAM 사용량, 시각적 결함, 그리고 결과가 수용 가능한지 여부(단순히 더 빠른지 여부가 아님)를 기록하세요.
공식 가이드라인에 따르면, TeaCache은 일부 사용자에게 결과 품질을 저하시킬 수 있으며, 최종 품질보다는 아이디어 탐색 용도로 권장됩니다. SageAttention, bits-and-bytes 양자화, GGUF에 대해서도 동일한 주의 사항을 제시합니다. 이러한 옵션은 유용할 수 있으나, 여러 개를 중첩하면 제어력을 상실하게 됩니다: 손이 왜곡되거나 질감이 파동치는 경우, 어느 단축 기능이 원인인지 알 수 없게 됩니다. 하나씩 추가하고, 한 번 렌더링한 후, 저장된 기준 결과가 더 나은 경우 바로 되돌리세요.
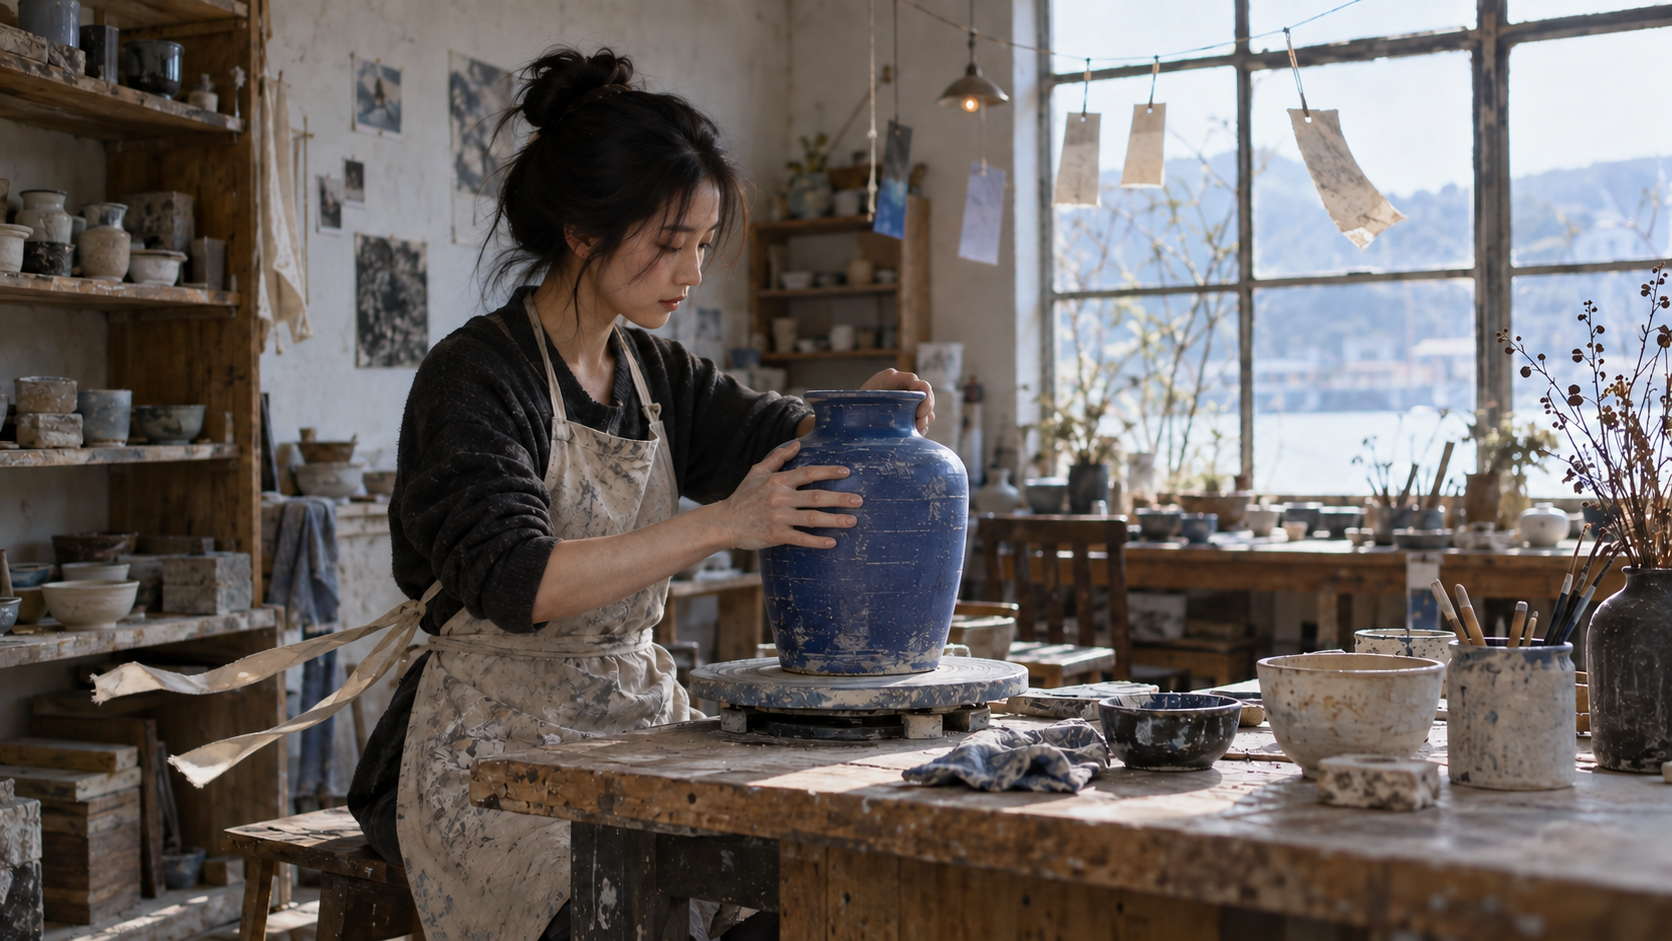
설명용 모션 목표입니다. 화병 형태, 얼굴, 손, 스튜디오 배경선을 저장된 첫 프레임과 비교하세요. 이 핵심 요소들이 이탈한다면, 속도 향상은 승리가 아닙니다.
프롬프트의 간결성도 중요합니다. FramePack 자체의 권고는 간결하고 모션 중심적인 언어 사용을 지지합니다. 주체, 주요 동작, 하나의 카메라 동작을 명시하세요. 충돌하는 렌즈 변경, 의상 변형, 장면 컷 등이 담긴 문단은 피하세요. 여러 개의 명확히 구분되는 샷이 필요하다면, 이미지-비디오 워크플로우를 통해 별도로 계획하고 승인한 후 결과물을 편집하세요. 하나의 생성은 하나의 시각적 비트(beat)만 해결해야 합니다.
낮은 VRAM 문제 해결
무작위 점검 목록이 아닌 오류 흐름을 따라가기
앱이 전혀 실행되지 않으면, 누락된 패키지, 지원되지 않는 GPU, 손상된 다운로드 등을 나타내는 터미널의 첫 번째 오류 메시지를 확인하세요. 여러 라이브러리를 맹목적으로 수정하기보다는 공식 업데이터를 다시 실행하거나 깨끗한 폴더에 재설치하세요. 모델 로딩이 시작되었다가 실패하는 경우, 남은 디스크 공간, 시스템 메모리 압박, 페이지 파일 또는 스왑 공간을 확인하세요. 경쟁 프로세스를 종료하고 머신을 재시작한 후 모델을 변경하세요. 샘플링이 시작되었다가 CUDA 메모리 부족 오류를 발생시키는 경우, 다른 GPU 프로세스가 메모리를 점유하고 있는지 확인하고 공식 기본 테스트를 반복하세요.
선택적 커널(kernal)만 실패하는 경우, 해당 커널을 제거하고 PyTorch 어텐션으로 돌아가세요. 현재 드라이버 및 GPU에서 실행되지 않는 최적화는 FramePack 자체에 필수 요건이 아닙니다. 생성 완료 후 인터페이스가 정지되는 경우, 이 증상을 CUDA 메모리 관련 문제와 구분하고, 생성 후 정지 진단 가이드를 따르세요. 마지막 줄만이 아니라 전체 터미널 메시지를 캡처하고, 재현 가능한 입력과 설정을 함께 보관하세요.느리지만 성공적인 실행의 경우, 시간이 실제로 배포를 방해하는지 여부를 판단하세요. 6GB 로컬 GPU는 밤새 진행하는 탐색 작업에 적합할 수 있지만, 마감 기한, 협업 또는 여러 변형을 다루는 경우에는 호스팅된 워크플로우가 더 낫습니다. Seedance Agent는 또 다른 프로덕션 경로를 제공합니다: 참조 자료를 정리하고, 촬영 계획을 수립하며, 실제 출력물을 검토한 후 실패한 부분만 다시 실행함으로써 로컬 종속성 스택을 유지하지 않아도 됩니다. 이는 한 모델이 FramePack을 대체한다는 주장을 의미하지 않으며, 환경을 직접 관리하는 것과 관리형 워크플로우를 구매하는 것 사이의 비교일 뿐입니다.
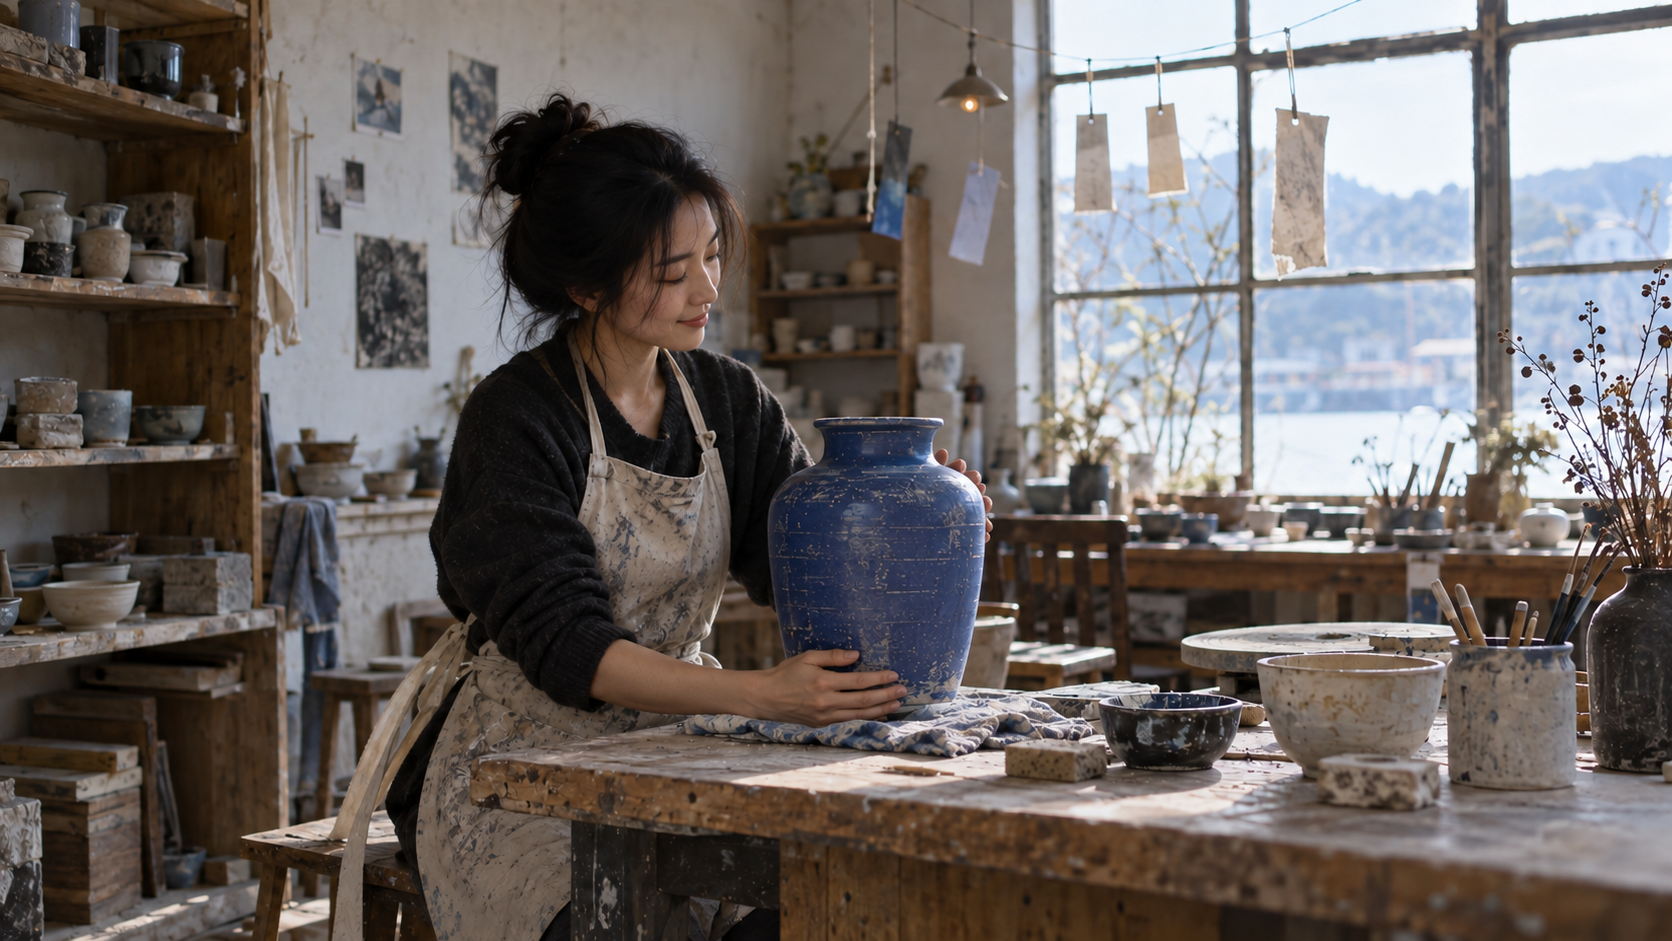
참고용 최종 승인 프레임. 실행을 완료한다고 판단하기 전에 정체성, 꽃병 기하학적 형태, 조명 및 배경의 연속성을 확인하기 위해 시작 프레임과 비교하세요.
결론
신뢰할 수 있는 FramePack 6GB VRAM 설정은 공식 패키지, 지원되는 RTX GPU, 충분한 디스크 공간 및 시스템 메모리, 하나의 간단한 소스 이미지, 기본 PyTorch 어텐션, 그리고 비활성화된 TeaCache으로 시작합니다. 캐시, 대체 어텐션 커널 또는 양자화를 추가하기 전에 먼저 이 기준선을 검증하세요. 각 변경 사항은 동일하게 저장된 입력과 전체 영상 검토를 기준으로 측정해야 합니다. 6GB는 실용적인 최소 용량이 될 수 있지만, 진정한 결정 포인트는 로컬 생성 시간과 종속성 관리가 해당 프로젝트에 부합하는지 여부입니다. 만약 촬영 계획 수립, 참조 자료 제어, 출력물 검토를 하나의 관리형 경로에서 수행하는 편이 더 낫다고 생각한다면, 다음 영상을 Seedance Agent로 시작하세요.
직접 해볼 준비가 되셨나요?
이 가이드의 단계를 Seedance에서 바로 적용해 프롬프트나 이미지를 몇 분 안에 완성도 높은 영상으로 바꿔보세요.
가입 시 무료 크레딧 제공. 요금제는 월 $20부터.
Google Vids 슬라이드를 동영상으로: 프레젠테이션을 게시 가능한 동영상으로 변환
Google Slides를 Google Vids 장면으로 변환하고, 발표자 메모 및 선택적 Gemini 음성 해설을 활용하며, 정적인 슬라이드를 애니메이션으로 대체한 후 게시 가능한 완성된 동영상을 내보내기.
글 읽기
MiniMax H3 비디오 광고용 플라스틱 피부 수정: 사실성 워크플로우
더 나은 참조 이미지, 자연스러운 조명, 제어된 프롬프트, 동작 검토 및 명확한 재생성 또는 완료 체크리스트를 활용하여 MiniMax H3 비디오 광고의 플라스틱처럼 보이는 피부를 수정합니다.
글 읽기
VEED 자동 자막 무료 사용법: 게시 가능한 자막을 위한 실용 가이드
무료 요금제에서 VEED 자동 자막 기능을 사용하고, 자막의 타이밍과 스타일을 수정하며, 워터마크 및 SRT 제한 사항을 이해하고, Seedance를 사용해 자막 준비가 완료된 동영상을 제작하세요.
글 읽기