
Fluxo de Trabalho de Vídeo para Duas Pessoas com MiniMax H3: Manter Papéis, Diálogos e Movimentos Claros
AI Overview
O MiniMax H3 consegue gerar duas pessoas em um único vídeo?
Sim. O H3 pode representar múltiplos personagens, mas cada pessoa precisa ter uma identidade distinta, posição, ação e papel falado específicos. Uma cena curta com uma única interação é mais confiável do que um prompt sobrecarregado com diversos movimentos simultâneos.
Como impedir que dois personagens troquem identidades?
Atribua rótulos estáveis, como Subject 1 e Subject 2, forneça a cada um uma vestimenta e posição na tela únicas, e repita apenas os traços que devem permanecer inalterados. Use imagens de referência separadas quando a precisão de identidade for essencial.
Como escrever o diálogo entre duas pessoas no MiniMax H3?
Atribua IDs estáveis aos falantes, como S1 e S2, indique sempre quem fala antes de cada linha e insira dentro da tag de diálogo apenas as palavras exatas pronunciadas. Especifique que a boca do ouvinte permanece fechada.
Qual modo do H3 é o mais adequado para uma cena com dois personagens?
Use o modo texto ou o modo de primeira imagem para uma cena simples inventada; o modo de primeira e última imagem para uma transição controlada única; e o modo de referência completa quando imagens separadas, movimentos corporais ou ativos de voz devem definir as duas pessoas.
Escolha o Modo Adequado do H3 para Duas Pessoas
Deixe a restrição mais difícil escolher o modo de entrada
O fluxo de trabalho para vídeos com duas pessoas no MiniMax H3 começa antes mesmo da redação do prompt. Decida o que deve ser controlado. A geração texto-para-áudio-vídeo é suficiente quando ambos os personagens podem ser inventados. Uma única imagem inicial ajuda quando a composição inicial, a vestimenta e as posições relativas já são relevantes. O modo de primeira e última imagem é útil quando uma única interação deve terminar em um estado conhecido — por exemplo, uma pessoa entregando uma mala à outra.
O modo de referência completa é mais adequado quando o Personagem A e o Personagem B provêm de imagens de identidade diferentes, quando um vídeo separado fornece o movimento corporal ou quando referências vocais são importantes. O MiniMax aceita até nove imagens de referência, três vídeos e três clipes de áudio, totalizando 12 arquivos de referência. Áudio de referência não pode ser a única entrada; ele deve acompanhar uma imagem ou um vídeo. Não misture tarefas de controle de quadros e tarefas de referência completa em uma única solicitação.
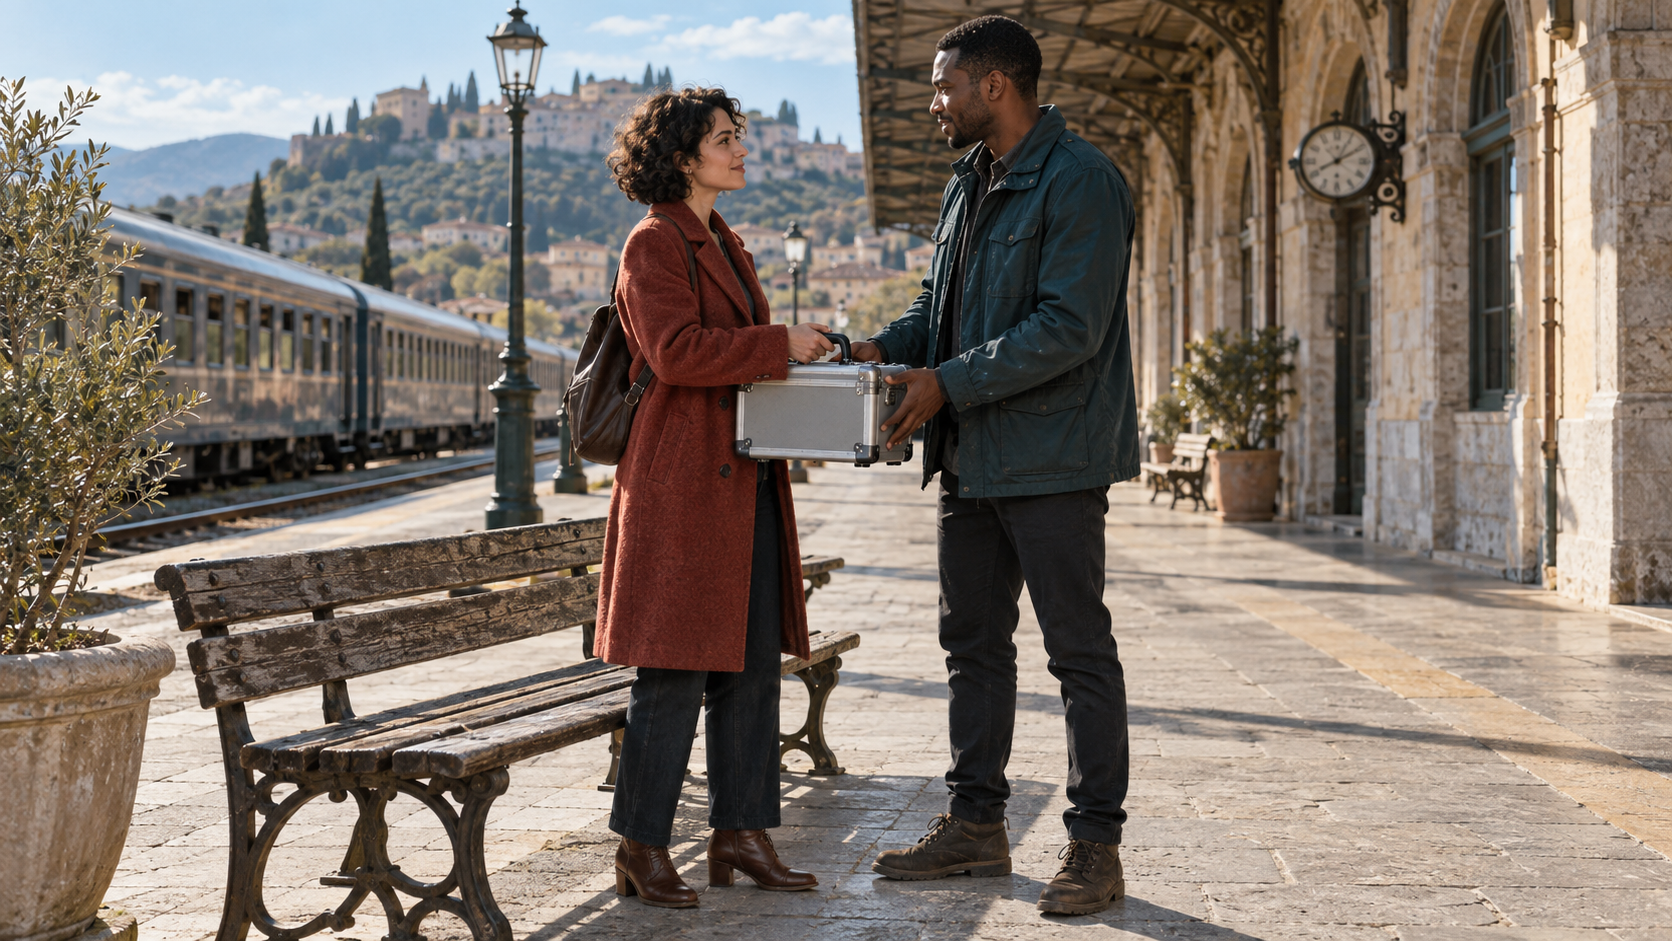
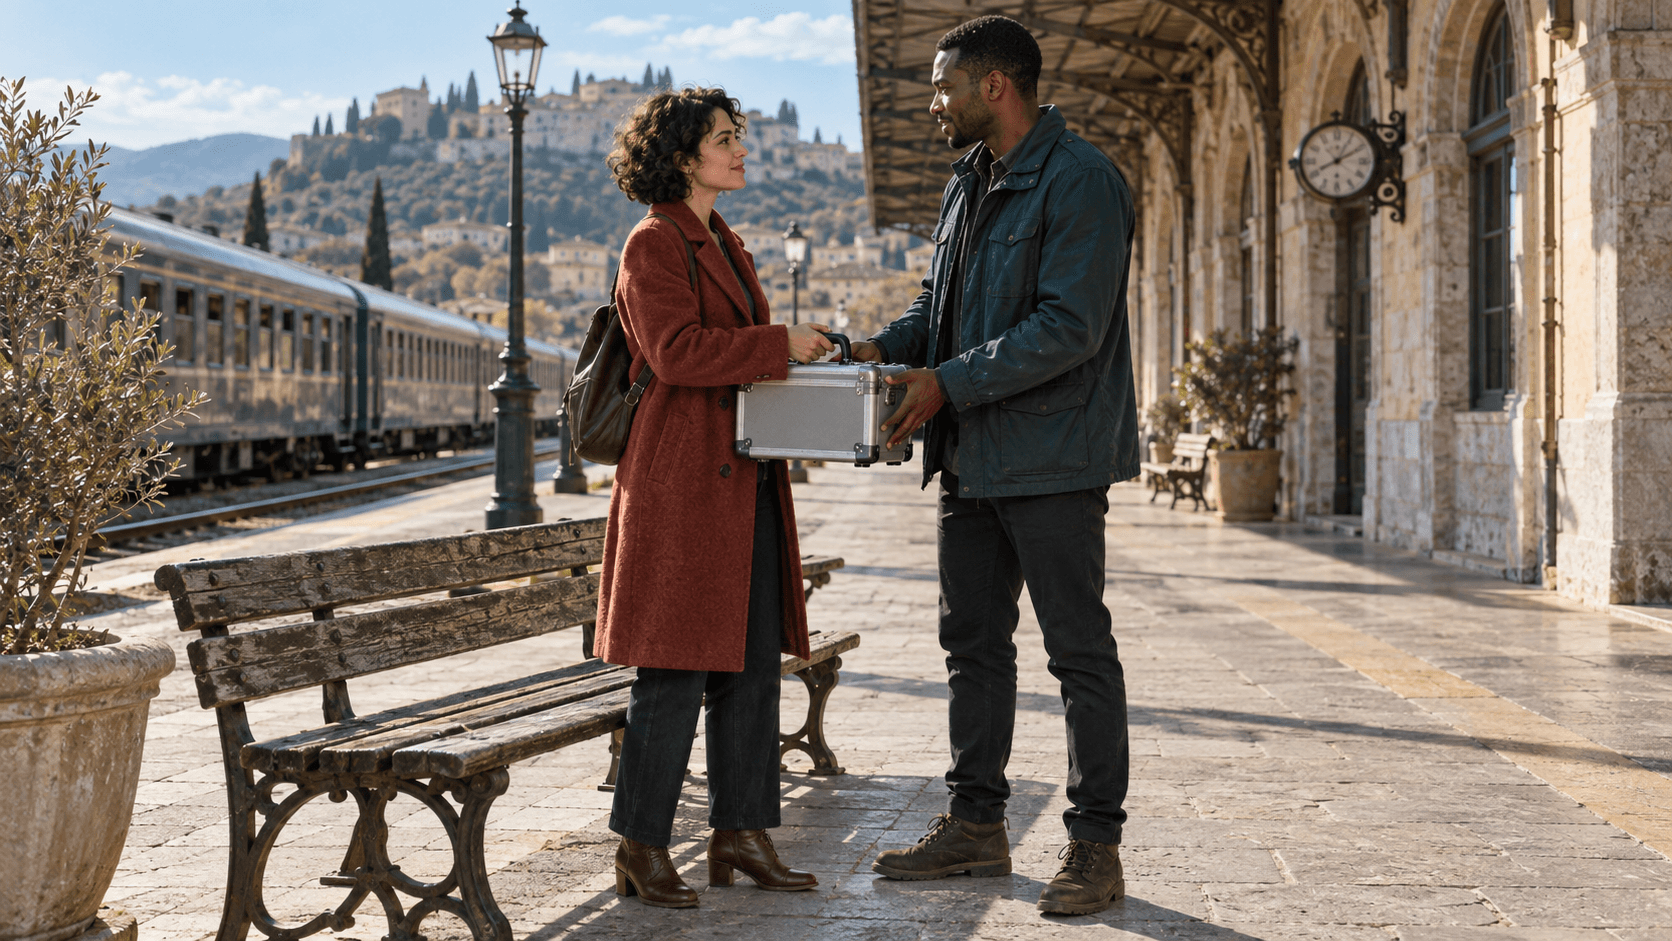
Quadro de referência gerado ilustrativamente: dois casacos distintos, silhuetas separadas, uma plataforma fixa e um único objeto compartilhado criam âncoras de continuidade facilmente legíveis.
Use a duração como um orçamento de ações. O H3 suporta vídeos de 4 a 15 segundos, mas 15 segundos não significa permissão para encaixar mais enredo. Dê às duas pessoas um único “golpe causal”: aproximação, troca e estabilização; pergunta, resposta e reação; ou entrada, observação e saída. Se a cena exigir um segundo local ou outra ação importante, crie um novo clipe e conecte-o com um fluxo de trabalho multiquadro retomável.
Defina Subject 1 e Subject 2
Crie um cartão compacto de identidade e posicionamento
Descreva os dois personagens como registros de produção separados antes de redigir a linha do tempo. Cada cartão deve incluir identidade visual, vestimenta, posição inicial, propriedade de objetos, limite de movimento, ID do falante e fonte de referência. As diferenças devem ser facilmente perceptíveis à primeira vista; frases como “duas pessoas com jaquetas escuras” geram ambiguidade.
| Controle | Subject 1 | Subject 2 |
|---|---|---|
| Identidade | Mulher, início dos 30 anos, cachos escuros curtos | Homem, meados dos 30 anos, cabelo muito curto |
| Vestimenta | Casaco de lã vermelho-ocre, botas marrons | Jaqueta cáqui-escura, botas escuras |
| Posição inicial | À esquerda da tela, ao lado do banco | À direita da tela, perto da parede da estação |
| Estado do objeto | Segura a alça da mala | Sustenta o corpo da mala |
| ID do falante | S1 | S2 |
| Limite de movimento | Um passo para frente, solta a alça | Recebe a mala, dá um passo para trás |
No modo de referência completa, defina a contribuição de cada ativo. Um rótulo de sujeito representa conteúdo visual reutilizável, enquanto os rótulos Imagem, Vídeo e Áudio identificam mídias-fonte ou referências estruturais. Não chame toda a primeira imagem de Subject 1 se ela contém duas pessoas e um local. Indique que Subject 1 é a mulher da Imagem 1 e Subject 2 é o homem da Imagem 2; defina a plataforma separadamente apenas se ela precisar ser reutilizada ativamente.
subject_definitions:
<Subject 1> é a mulher da <Picture 1>, preservando seus cachos escuros curtos, casaco vermelho-ocre, rosto e botas marrons.
<Subject 2> é o homem da <Picture 2>, preservando seu cabelo muito curto, jaqueta cáqui-escura, rosto e botas escuras.
<Subject 3> é a pequena mala de equipamentos prateada mostrada na <Picture 3>, preservando seu tamanho, alça, fechos e acabamento em metal escovado.
Evite descrever novamente qualquer rosto de forma diferente em tomadas posteriores. Rótulos estáveis reduzem a competição entre adjetivos e referências. Para âncoras de cena que devem resistir a mudanças de ponto de vista, o guia de consistência ambiental do MiniMax H3 mostra como nomear arquitetura, direção da luz, mobília e objetos de fundo sem transformar o prompt em um catálogo.
Posicione a Interação e a Entrega do Objeto
Descreva mudanças de estado, não apenas intenções
“Eles trocam a mala naturalmente” oculta os quadros mais difíceis. Descreva o estado do objeto na ordem de reprodução: Subject 1 segura a alça; Subject 2 coloca ambas as mãos sob a mala; ambos a sustentam brevemente; Subject 1 abre os dedos e recua; Subject 2 dá um passo para trás com a mala; ambos se estabilizam. Assim, o modelo recebe um caminho observável, em vez de uma ação social vaga.
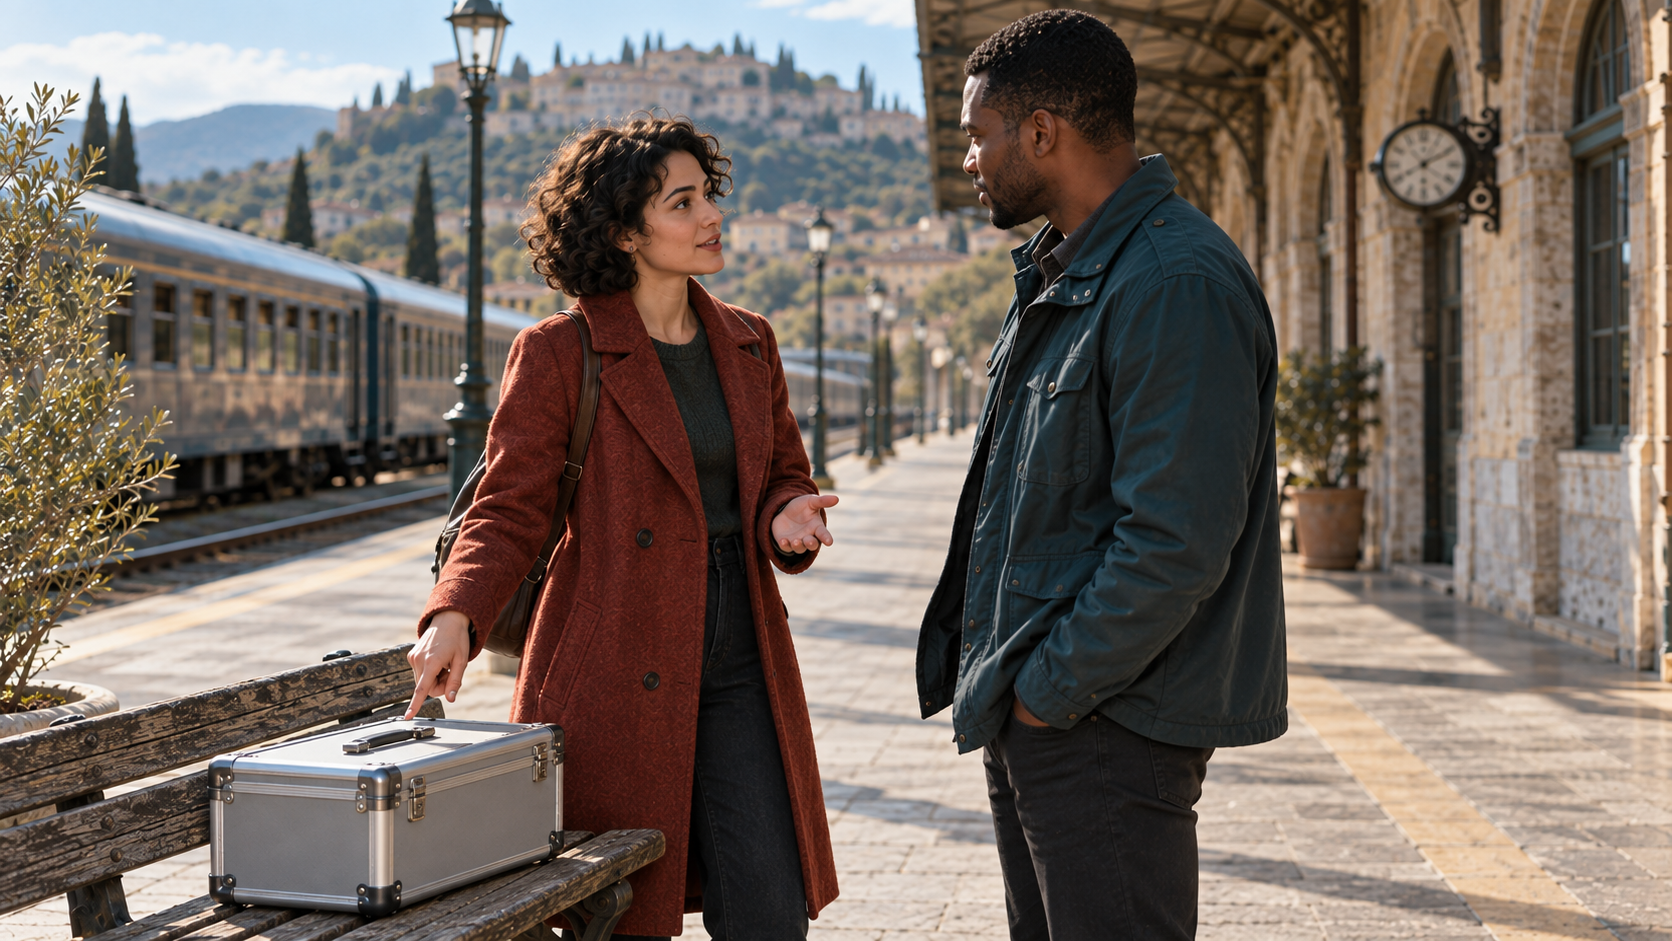
Quadro de bloqueio gerado ilustrativo: o falante possui o gesto, o ouvinte tem uma linha de visão clara e a maleta repousa em local estável antes da transferência.
Mantenha a linguagem espacial consistente. “Esquerda da tela” e “direita da tela” são relativas à câmera; “próximo aos trilhos” e “próximo à parede da estação” resistem melhor a um ângulo invertido. Quando um corte muda a orientação, reestabeleça a posição de ambas as pessoas antes da próxima ação. Use apenas um movimento de câmera por vez — por exemplo, um avanço lento em direção ao par — em vez de combinar arco, zoom, panorâmica e tremor manual.
As mãos falham quando ambas as pessoas se estendem uma através da outra ou quando o prompt ignora uma fase de contato. Dê à maleta tamanho suficiente para duas empunhaduras legíveis, evite que qualquer corpo atravesse o outro e permita que a troca ocupe vários segundos. Um final limpo é essencial: identifique quem possui a maleta, onde cada pessoa está posicionada, para onde olha e se algum dos lábios está em movimento.
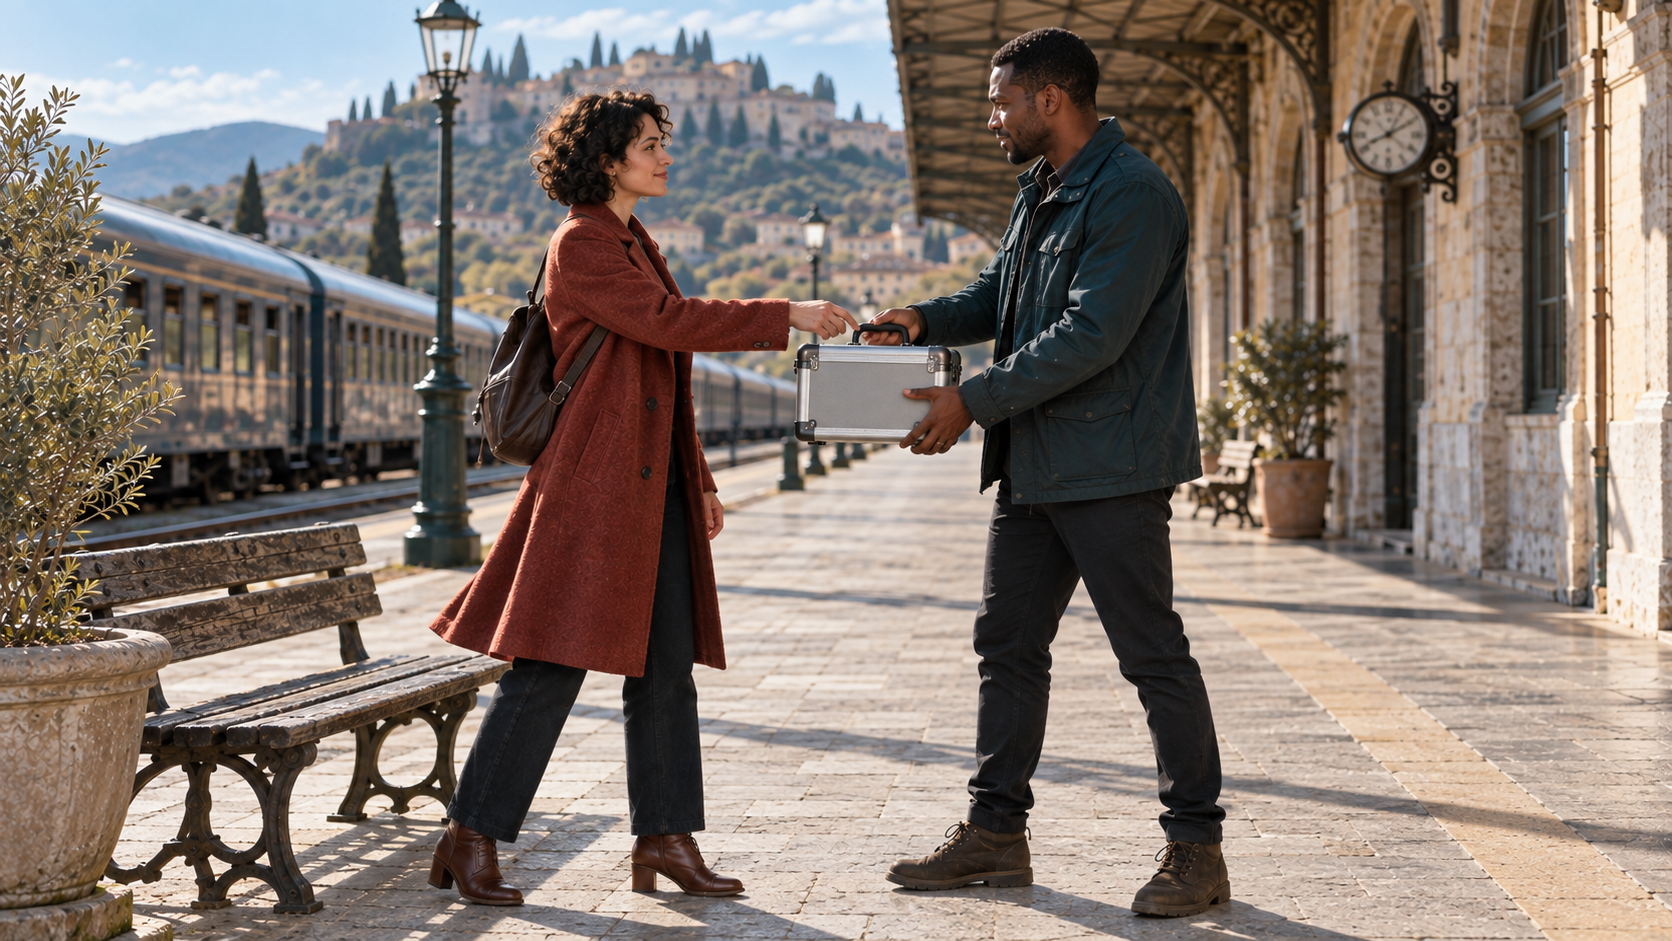
Quadro de ação gerado ilustrativo: verifique a separação das mãos, a geometria do adereço, a continuidade do casaco e a ausência de um braço extra durante o contato compartilhado.
Controle diálogo e som entre dois falantes
Atribua cada fala e cada batida de escuta
O guia base oficial do MiniMax usa IDs estáveis de falantes, como S1 e S2. Coloque a frase identificadora, o ID do falante, a entonação e a ação fora da tag de diálogo; mantenha dentro dela apenas a tag de idioma e o conteúdo exato falado. Quando os dois falam simultaneamente, um ID composto como S1,S2 é suportado, mas diálogos sobrepostos constituem um teste mais difícil do que linhas alternadas.
A mulher com o casaco vermelho-oxidado (S1) olha para a maleta e diz calmamente: <d>[English] Keep this with you until the next stop.</d> Subject 2 escuta e seus lábios permanecem fechados.
O homem com o jaqueta verde-azulada (S2) recebe a maleta, encontra seu olhar e responde: <d>[English] I understand.</d> Subject 1 escuta e seus lábios permanecem fechados.
Use frases curtas que caibam na tomada visível. Indique quando a fala termina, quando a mandíbula fecha e quando o ouvinte reage. Mantenha a ambientação da plataforma, passos, cliques do fecho da maleta e movimentos de tecido na paisagem sonora geral, em vez de repeti-los como diálogo. Insira música destinada exclusivamente ao público no campo de música não-diegética. Se uma narração em off pertence a uma fonte fora da tela, identifique-a explicitamente como narração em off e mantenha os lábios do personagem na tela fechados.
Saída real do Seedance, não um resultado do MiniMax H3: use um clipe controlado de um único falante como referência para movimento labial, sincronização e tom ambiente antes de avaliar uma troca mais complexa entre duas pessoas.
Para vozes recorrentes em vários clipes, o guia de consistência vocal do Seedance fornece uma análise auditiva de timbre, ritmo, intensidade sonora, tom ambiente e separação entre falantes.
Elabore um plano de continuidade em três tomadas
Faça cada corte herdar um estado travado
Três tomadas curtas são suficientes para muitas cenas com duas pessoas. A Tomada 1 estabelece ambos os sujeitos, a plataforma e a posse inicial da maleta. A Tomada 2 aproxima-se para a transferência e registra uma fala de cada falante. A Tomada 3 confirma o novo proprietário do adereço e oferece a ambos os personagens uma reação silenciosa. Atribua a cada tomada um estado inicial, uma ação, um comportamento da câmera, um tratamento sonoro e um estado final travado.
O final da Tomada 1 deve corresponder exatamente ao início da Tomada 2. Se a maleta estiver sobre o banco no momento do corte, ela não pode aparecer nas mãos de Subject 2 no primeiro quadro seguinte sem uma captação visual explícita. Se Subject 1 estiver em pé ao lado dos trilhos, não inverta sua posição até a parede da estação, a menos que o corte e a orientação da câmera o justifiquem. O fluxo de trabalho multi-keyframe do MiniMax H3 mostra como atribuir quadros ordenados a uma linha do tempo mestre, sem tratá-los como uma colagem vertical de storyboard.
O guia base do H3 permite definir tempos precisos de corte após a Tomada 1. Use-os apenas quando forem úteis e mantenha os intervalos contínuos. Um plano prático de 12 segundos é: 0–4 segundos para estabelecimento, 4–9 segundos para a troca e 9–12 segundos para a pausa final. Os últimos dois segundos não devem introduzir uma nova ação.
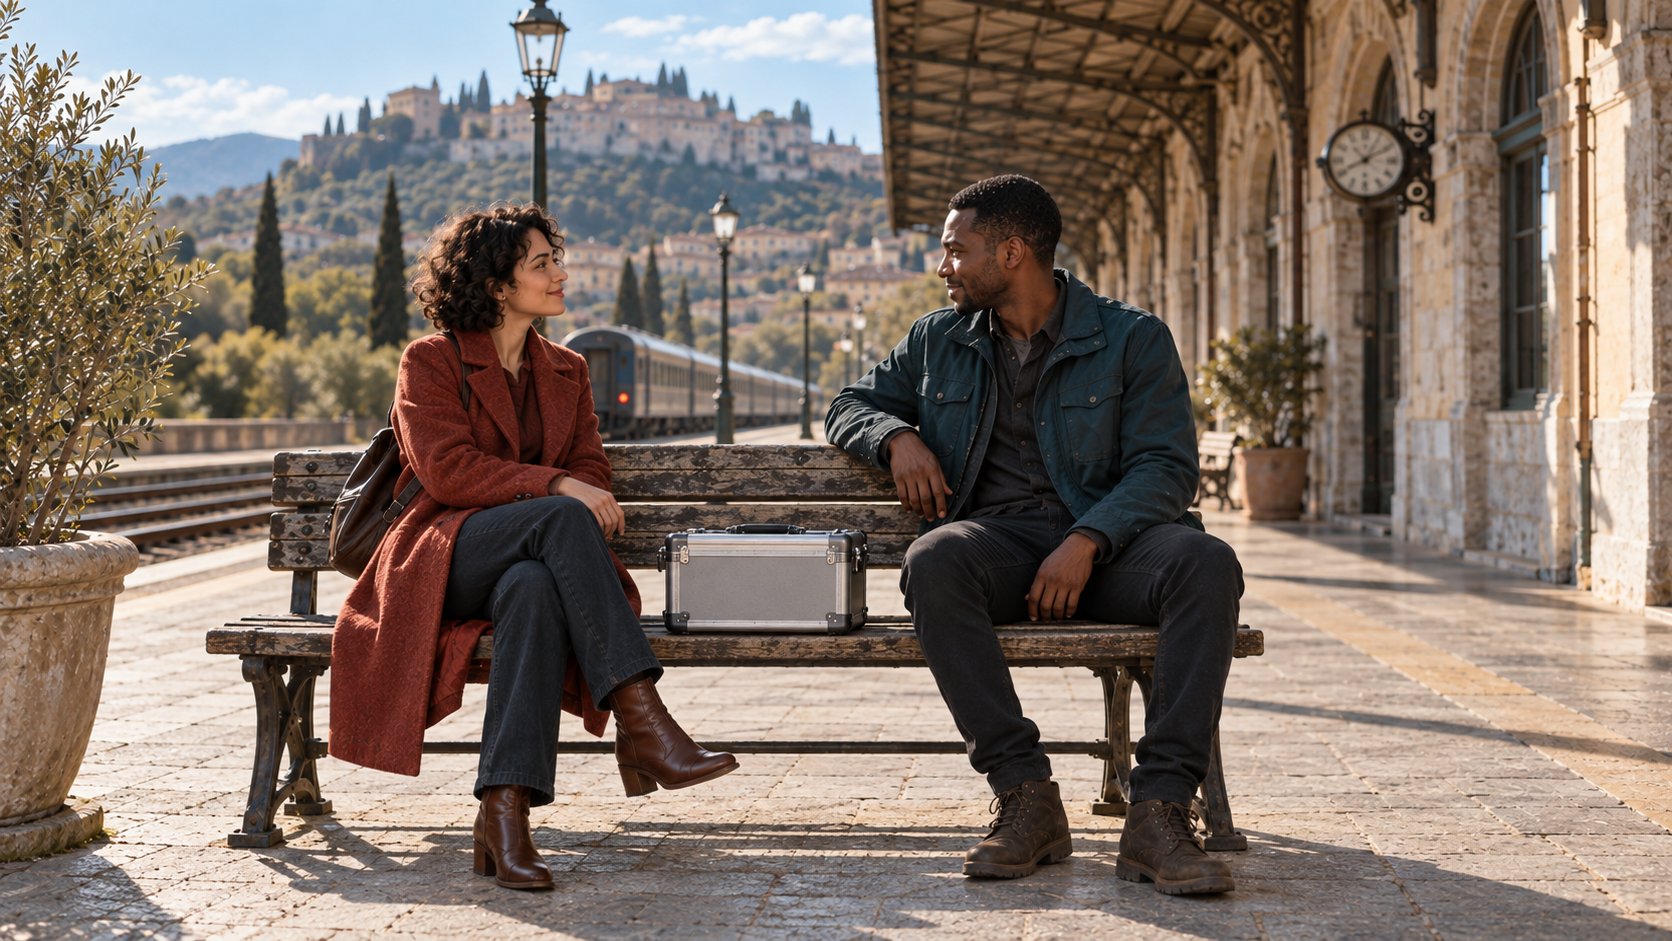
Quadro final gerado ilustrativo: os mesmos rostos, casacos, banco, estação, maleta e iluminação tornam fácil detectar desvios de continuidade.
Revise falhas e reexecute a menor parte possível
Relacione cada falha visível a uma única alteração no prompt
Revise o vídeo completo em velocidade normal, depois examine a transferência e o diálogo em meia velocidade. Se as identidades se trocarem, fortaleça o mapeamento entre sujeito e referência e simplifique o corte. Se os rostos se fundirem em uma tomada aberta, aumente a separação entre os sujeitos ou transfira o diálogo para uma tomada média de dois planos; o guia de correção de rostos distantes aborda escolhas de enquadramento e referências para esse problema.| Falha | Causa provável | Menor mudança útil | | --- | --- | --- | | Personagens trocam de papéis | Guarda-roupa semelhante ou rótulos ambíguos | Restaurar rótulos distintos, roupas, posições e IDs dos falantes | | Ambas as bocas se movem | Comportamento do ouvinte não especificado | Adicionar “ouve, lábios permanecem fechados” após cada linha | | Aparece um braço extra | A transição ignora um estado de contato | Expandir as fases de suporte compartilhado e liberação | | O objeto muda de forma | Excesso de ações ou definição fraca do objeto | Fixar dimensões, alça, acabamento e proprietário final | | As linhas de olhar se quebram após o corte | As posições não são reestabelecidas | Reafirmar tanto as posições quanto o olhar sob o novo ângulo | | O ambiente é reiniciado | Âncoras da cena eram implícitas | Repetir plataforma, banco, trem, direção da luz e horário |
Não regenere uma boa introdução apenas porque um quadro de transição falha. Salve as referências de personagem aceitas, a versão do prompt, a seed ou o registro da tarefa, quando disponíveis, bem como a saída e a nota de falha. Em seguida, execute novamente a menor tentativa com uma única alteração corretiva. Seedance Agent pode organizar essas referências, comparar candidatos, manter o estado de aprovação e encaminhar apenas o segmento falhoso por meio de um fluxo de trabalho de referência para vídeo.
Conclusão
Um fluxo de trabalho confiável de vídeo com duas pessoas (MiniMax H3) utiliza o modo de entrada adequado, dois registros de sujeitos inequívocos, IDs de falantes estáveis (S1 e S2), uma interação causal, mudanças explícitas de estado do objeto e um plano de cortes cujos estados finais correspondam às aberturas seguintes. Revise identidade, propriedade da boca, mãos, linhas de olhar, geometria do objeto, ambiente e som separadamente, e execute novamente apenas o trecho falhoso. Para manter juntas referências, tomadas, aprovações e revisões direcionadas, construa a sequência com dois personagens usando Seedance Agent.
Pronto para testar por conta própria?
Coloque os passos desta guia em prática com Seedance e transforme prompts ou imagens em vídeos polidos em minutos.
Créditos grátis ao se cadastrar. Planos a partir de US$20/mês.
Artigos relacionados
Mais posts no mesmo idioma que talvez você queira ler a seguir.
Guia de Acesso Antecipado ao Socialive Catalyst: Prepare um Primeiro Piloto Útil
Saiba quem pode acessar o Socialive Catalyst, o que está incluído na versão beta inicial, o que preparar para uma demonstração e como testar um fluxo de trabalho de vídeo corporativo com marca.
Ler artigo
FramePack Torch CUDA Não Habilitado: Diagnosticar e Corrigir o Ambiente Correto
Corrija o FramePack quando o Torch não possui suporte a CUDA verificando o runtime Python exato, substituindo uma versão (wheel) somente para CPU, lidando com compatibilidade de driver ou RTX e comprovando a correção.
Ler artigo
Tutorial do Google Vids sobre Avatares Pessoais: Gravar, Instruir e Corrigir
Crie um avatar pessoal no Google Vids, conclua a captura facial e vocal, redija um prompt útil do Gemini Omni, corrija o acesso ausente e gerencie sua gravação.
Ler artigo