
Fluxo de trabalho do avatar falante contínuo MiniMax H3: Manter um mesmo rosto e voz em todos os clipes

AI Overview
O MiniMax H3 consegue gerar um vídeo contínuo de avatar falante?
Sim, mas um resultado longo deve ser planejado como diversos clipes aprovados, em vez de uma única geração indefinida. A ferramenta H3 gera clipes de 4–15 segundos; portanto, divida o roteiro em pausas naturais e una segmentos que compartilhem o mesmo rosto, voz, enquadramento e tom ambiente (room tone).
Como manter a mesma identidade de avatar em todos os segmentos?
Utilize uma única referência de identidade limpa, repita os mesmos traços visíveis, atribua um ID de falante estável — por exemplo, S1 — e inicie cada continuação a partir de um quadro-limite neutro já aprovado. Altere apenas o diálogo e o gesto mínimo estritamente necessário.
O que torna as transições entre clipes de avatar falante imperceptíveis?
Finalize cada segmento após uma frase completa, com a boca fechada, olhar estável, mãos imóveis e uma breve cauda de tom ambiente. Inicie o próximo segmento exatamente nesse mesmo estado, então oculte a junção sob uma pausa natural ou um corte contido (restrained cutaway).
Como evitar a deriva na sincronização labial?
Mantenha cada bloco falado curto o suficiente para caber em uma única respiração, escreva o diálogo exato dentro da tag <d> e evite movimentos concorrentes do rosto ou da câmera. Revise a movimentação bucal em velocidade normal e quadro a quadro antes de aprovar o segmento.
Planeje um Avatar Contínuo como Segmentos Curtos e Aprovados
Construa o produto final a partir de clipes do tamanho de uma respiração
O fluxo de trabalho de avatar falante contínuo do MiniMax H3 é um plano de produção, não uma solicitação de duração ilimitada. As ferramentas oficiais H3 aceitam durações inteiras de 4 a 15 segundos. Trate esse limite como uma restrição criativa: cada clipe deve conter uma ideia completa, um gesto moderado e um estado final limpo. Uma explicação de 45 segundos pode se transformar em quatro segmentos de 10–13 segundos, em vez de três clipes forçados ao limite máximo.
Marque o roteiro antes de qualquer geração. Boas quebras seguem pontuação, uma respiração ou uma mudança de tópico. Más quebras dividem nomes, números ou frases emocionalmente conectadas. Leia em voz alta cada segmento com um cronômetro e reserve aproximadamente um segundo para o ajuste inicial e a pausa final. Se a fala já ocupar toda a duração, reduza o texto em vez de exigir que o modelo acelere.
| Segmento | Tarefa falada | Ação-alvo | Estado final exigido |
|---|---|---|---|
| A | Apresentar o tema | Pequeno gesto com a mão aberta | Boca fechada, mãos descendo |
| B | Explicar o ponto-chave | Um gesto contido com o indicador | Mesmo olhar, mãos sobre a mesa |
| C | Apresentar o exemplo | Leve aceno, sem movimento de câmera | Expressão neutra e tom ambiente |
| D | Entregar a chamada para ação (CTA) | Inclinação sutil, seguida de estabilização | Pausa de dois batimentos para edição |
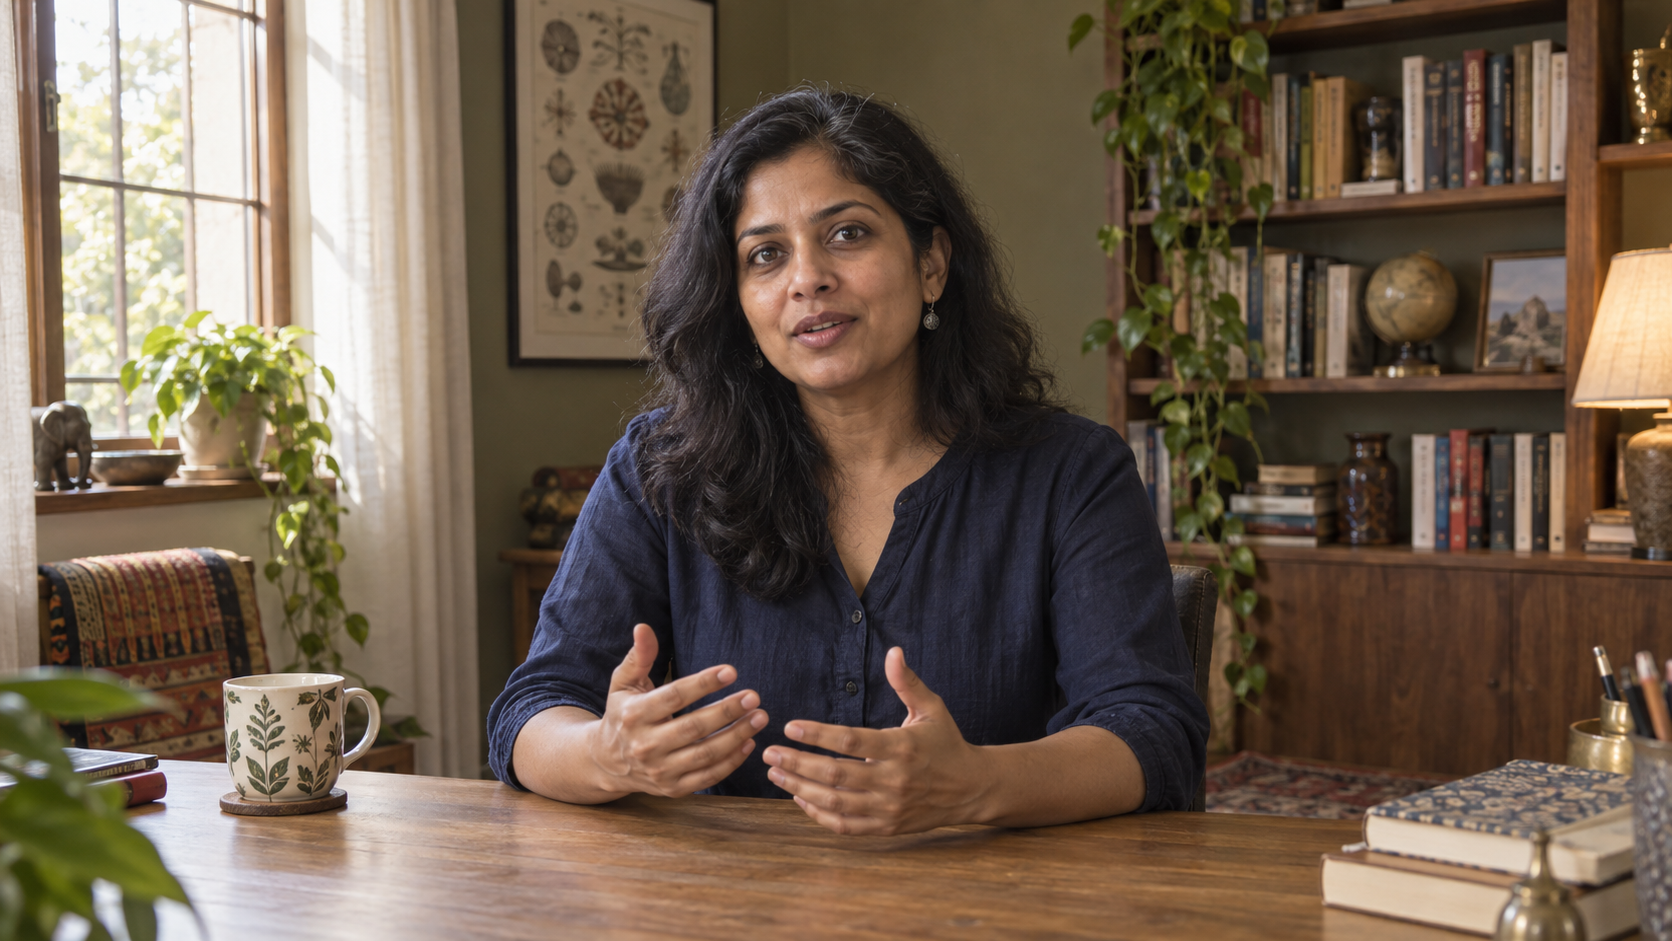
Imagem gerada ilustrativa, não um resultado real do MiniMax H3: o enquadramento médio, as mãos visíveis, a vestimenta simples e o fundo estável fornecem mais evidências de continuidade para uma sequência falada do que um retrato fechado (beauty portrait).
Essa segmentação também torna a recuperação economicamente viável. Se o segmento C apresentar uma forma bucal fraca, gere novamente apenas o C, em vez de arriscar todo o material já aprovado. A mesma lógica de pontos de verificação (checkpoints) usada no fluxo de trabalho multietapa retomável aplica-se aqui: salve, para cada segmento, a versão do roteiro, o conjunto de referências, o prompt, a saída gerada e o quadro-limite aprovado.
Prepare o Rosto, a Voz, o Roteiro e o Quadro
Crie um único pacote compacto de continuidade
Escolha uma imagem de referência com um rosto legível, lábios relaxados, fundo desimpedido e o mesmo ângulo de câmera exigido para o vídeo final. Um enquadramento médio ou médio-fechado costuma ser mais seguro do que uma tomada ampla, pois mantém a boca grande o suficiente para inspeção. Mantenha o cabelo afastado dos lábios, evite que as mãos cruzem a parte inferior do rosto e use iluminação direcional suave, em vez de sombras duras e móveis.
Escreva um bloco fixo de identidade e reutilize-o palavra por palavra. Inclua faixa etária, tipo de cabelo, vestuário, uma característica distintiva porém comum, qualidade vocal, ritmo de fala, sotaque (apenas quando relevante), altura da câmera, tamanho da tomada, direção da luz e elementos de ancoragem no fundo. Não adicione novos adjetivos em segmentos posteriores; acréscimos aparentemente inócuos podem alterar o estilo, a idade ou as proporções faciais.
Para geração orientada por referência, o H3 pode utilizar ativos de imagem, vídeo e áudio. Seu guia oficial completo de referências distingue sujeitos visíveis, âncoras visuais concretas, vídeos-fonte e referências de áudio. Quando uma referência de áudio fornece a característica vocal — e não um sinal copiado — descreva-a como referência de timbre e modo de entrega. Mantenha sempre o mesmo ID de falante vinculado ao avatar sempre que ela efetivamente falar.
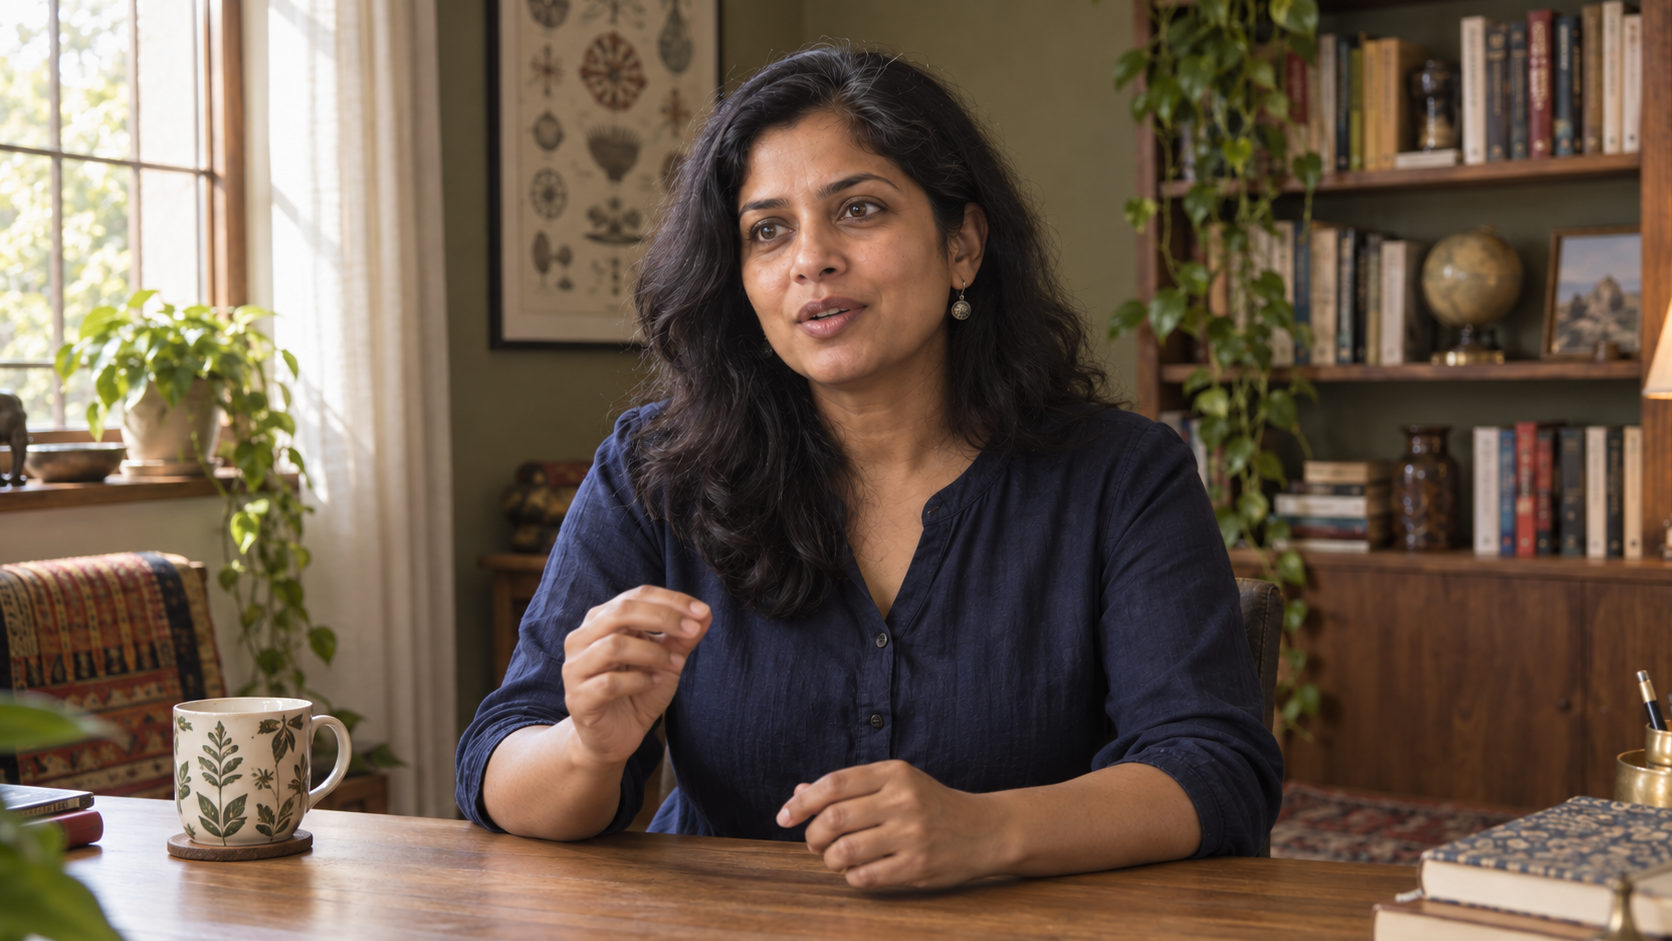
Alvo de continuidade para um segmento falado: identidade, lente, olhar, vestuário e iluminação permanecem fixos, enquanto apenas a forma bucal e um pequeno gesto mudam.
Grave o diálogo limpo caso precise de uma voz específica. Use um ambiente silencioso, distância constante entre a boca e o microfone, sem música de fundo e arquivos separados para cada segmento. Igualize o volume e o tom ambiente antes da geração. Se o objetivo for simplesmente uma voz nativa plausível, especifique timbre e ritmo estáveis, mas ainda assim mantenha as palavras exatas no prompt. O guia de consistência vocal inclui uma útil lista de verificação auditiva que também funciona ao revisar saídas do H3.
Escreva o Diálogo para o H3 Sem Perder a Identidade do Falante
Mantenha a direção visual fora da tag de diálogo
O guia oficial de base do H3 utiliza IDs de falante estáveis, como (S1), e coloca apenas as palavras a serem faladas dentro de <d>. A frase identificadora, a ação, a entonação e o ID do falante permanecem fora da tag. Essa separação evita que notas de desempenho se transformem acidentalmente em diálogo.
[Shot 1] Uma tomada realista em plano médio da mesma educadora científica sentada à escrivaninha de carvalho. A câmera, a lente, a direção da iluminação, o vestuário, os livros, as plantas e a xícara permanecem inalterados. A mulher adulta calma (S1), com voz grave-média, ritmo medido e dicção clara, olha ligeiramente ao lado da lente. Ela faz um pequeno gesto com a mão aberta e diz: <d>[English] A stable avatar begins with a stable handoff between every approved clip.</d> Após a frase, seus lábios se fecham, suas mãos retornam à escrivaninha e ela mantém o mesmo ponto de fixação por um segundo. O tom ambiente silencioso persiste. Sem música, sem movimento de câmera, sem sobreposição de texto.
Repita a frase identificadora sempre que uma nova geração pudesse, de outra forma, esquecer quem é o S1. Não crie um novo número de falante para o mesmo avatar no próximo clipe. Se outra voz entrar em cena, atribua S2 uma única vez e mantenha os papéis explícitos. Para um explicador de uma única pessoa, excluir outras vozes audíveis elimina uma fonte desnecessária de desvio.
Escreva uma única cláusula falada por ação visível. Giros rápidos da cabeça, grandes movimentos dos braços, aproximações da câmera e frases longas competem todos pelo mesmo curto intervalo. Quando a precisão labial é importante, mantenha a câmera estática e o tronco imóvel. Use os controles práticos de expressão descritos no guia de prompts de microexpressões do H3 para solicitar um leve levantamento de sobrancelha ou um aceno contido, sem alterar toda a face.
Mantenha um Estado Âncora através de cada corte
Termine limpo antes de solicitar o próximo início
O último segundo de um clipe torna-se o contrato visual para o próximo. Solicite um estado final travado: lábios fechados, mandíbula relaxada, olhos fixos no mesmo ponto de referência, mãos em posição nomeada, ombros nivelados e objetos de fundo inalterados. Exporte esse final aprovado como âncora de imagem para o próximo clipe, sempre que a rota de geração permitir. Uma pausa neutra é mais reutilizável do que um quadro capturado no meio de uma palavra.
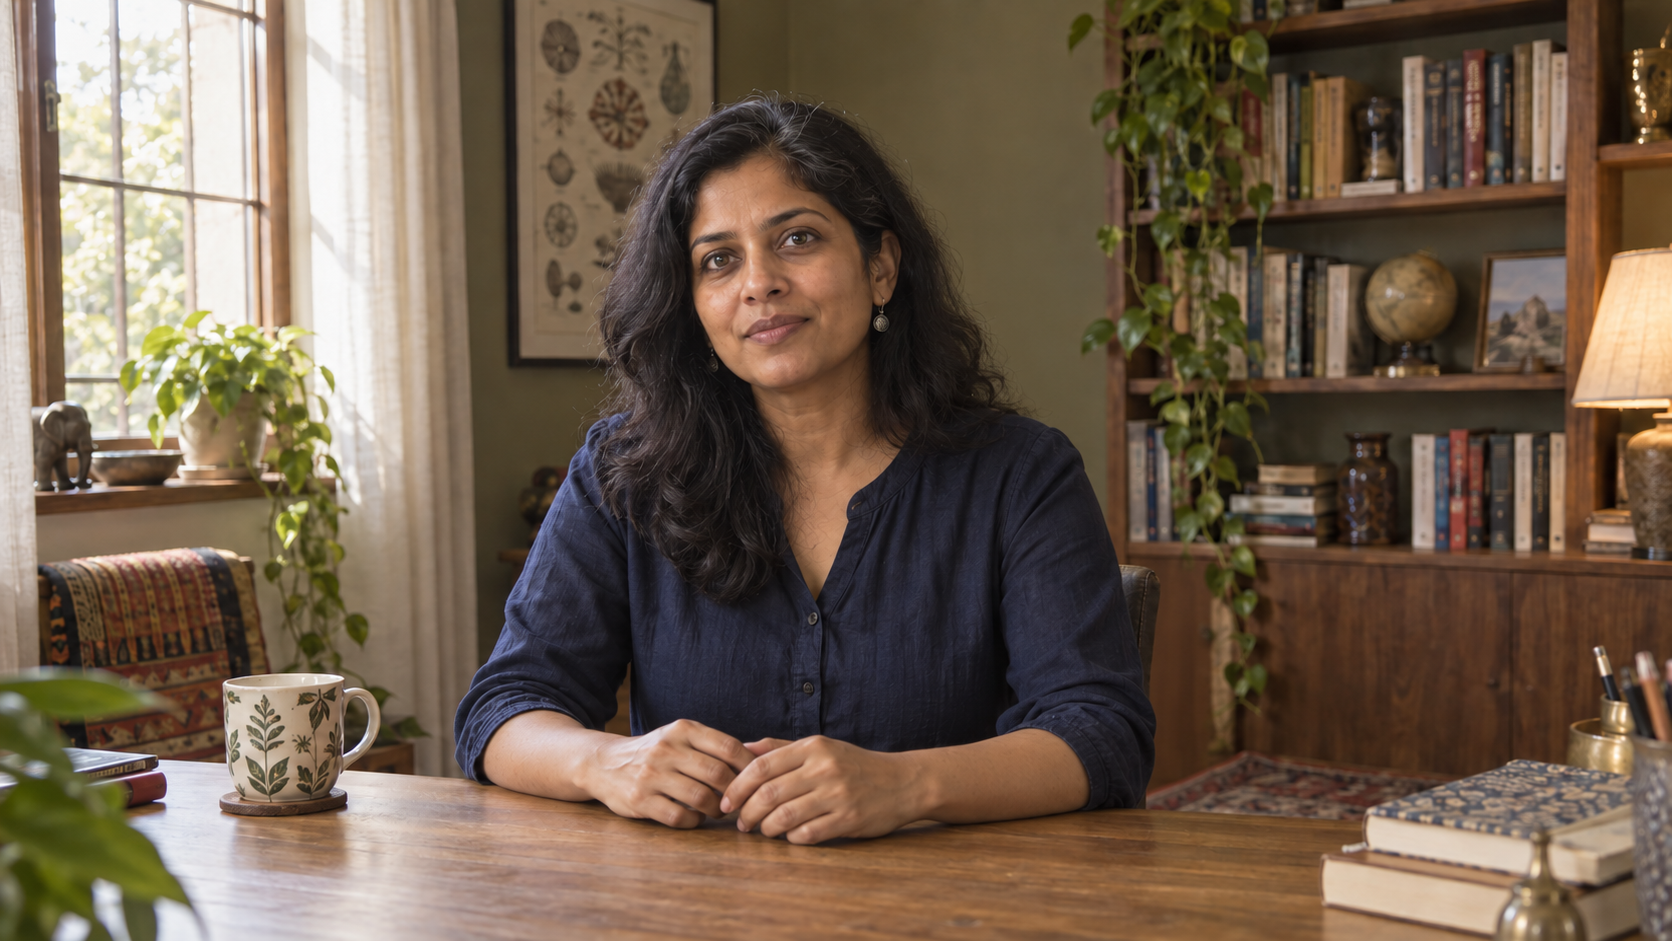
Um quadro-limite útil é intencionalmente desprovido de eventos: a boca está fechada, o olhar e a postura estão estabilizados, e nenhum gesto precisa continuar magicamente através da edição.
No início do segmento B, reafirme o estado travado antes da nova ação. Preserve o tamanho da cabeça, a altura da câmera, o ponto de fixação, a direção da iluminação, a posição das mangas e a localização de objetos de fundo com alto contraste. O primeiro movimento deve começar após uma breve estabilização, não no quadro um. Se o próximo clipe iniciar com uma pose diferente, o público perceberá o salto antes mesmo de ouvir as palavras.
O H3 suporta modos de quadro inicial/final e modo de referência, mas utilize apenas o modo adequado à tarefa. Uma imagem-limite concreta funciona como âncora de quadro; uma amostra de áudio pode orientar o timbre; um vídeo anterior pode fornecer contexto de movimento ou continuidade. Mais referências não são automaticamente melhores. Remova qualquer ativo que entre em conflito com o enquadramento, o vestuário ou a voz aprovados.
O método de transição está intimamente relacionado ao planejamento multi-keyframe, mas um avatar falante exige menos ambições visuais. Um único estado âncora estável por limite normalmente supera um storyboard denso que exija mudanças simultâneas na face, nas mãos, na câmera e no ambiente.
Monte os segmentos sem saltos audíveis ou visuais
Corte em uma pausa e preserve o tom ambiente
Posicione todos os clipes aprovados em uma única linha do tempo, na ordem do roteiro. Recorte quadros de estabilização duplicados, mas mantenha material neutro suficiente para afastar o corte de uma boca aberta. Ajuste escala e posição antes de adicionar transições. Um corte direto durante uma pausa natural costuma ser mais limpo do que uma dissolução, que pode brevemente mostrar duas bocas e deixar a face com aparência instável.
Saída real do Seedance, não um resultado do MiniMax H3: use esta amostra com áudio nativo como referência para avaliação do sincronismo fala-tempo, movimento facial e ambiente contínuo.
Ouça as junções com a imagem oculta. Igualize o volume do diálogo, o nível de ruído de fundo, a reverberação e a duração de cada respiração. Insira uma camada contínua e curta de tom ambiente sob toda a sequência, para que pequenas lacunas não soem como se o ambiente tivesse sido desligado. Evite música até que o corte vocal funcione; uma trilha sonora pode mascarar um corte defeituoso durante a edição, mas não o corrigirá.
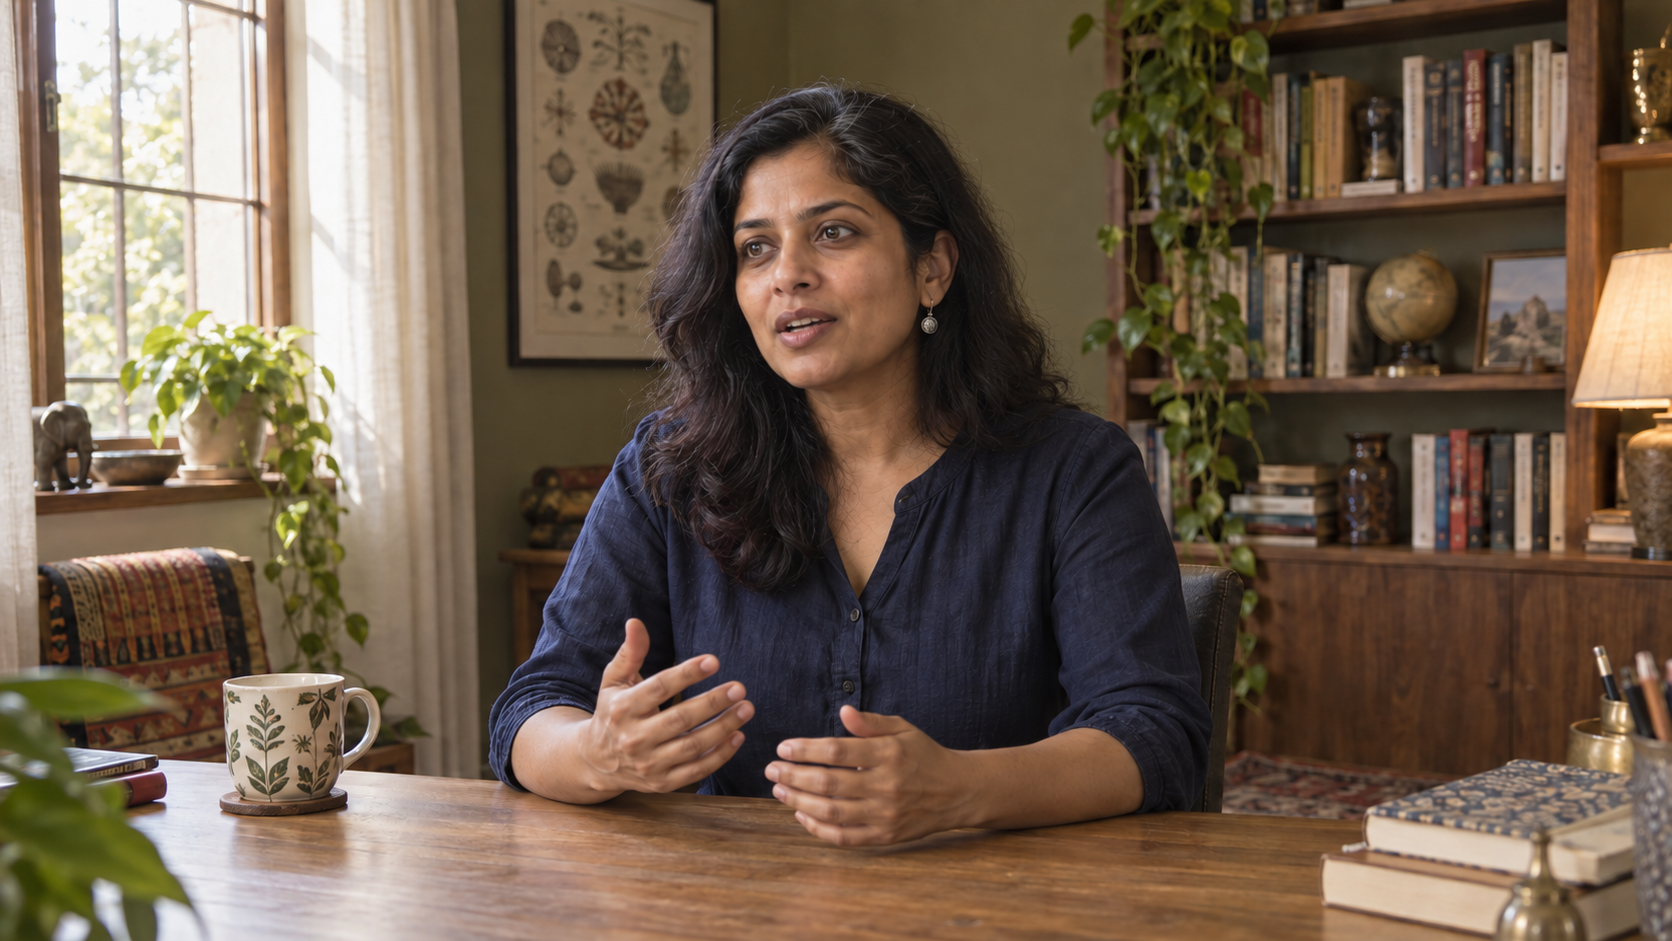
Alvo de continuidade: identidade e âncoras visuais permanecem estáveis, enquanto a nova frase começa com um gesto de mão ligeiramente diferente, porém ainda crível.
Se um salto persistir, use uma tomada alternativa relevante por um ou dois segundos: o caderno do orador, um objeto mencionado por ela ou uma visão mais ampla do mesmo ambiente. Não insira imagens de arquivo aleatórias. A tomada alternativa deve responder ou ilustrar a frase falada e, em seguida, retornar ao mesmo estado do avatar.
Revise falhas de sincronismo labial, voz e continuidade
Aprove cada clipe em cinco revisões separadas
Primeiro, assista ao vídeo em velocidade normal para compreender o significado e o ritmo natural. Segundo, desative o áudio e examine identidade, dentes, lábios, mandíbula, olhos e mãos. Terceiro, ouça sem assistir, prestando atenção ao timbre da voz, ao ritmo, ao tom ambiente (room tone) e a cliques. Quarto, avance quadro a quadro os primeiros e últimos doze quadros de cada segmento. Quinto, assista à sequência montada em um player com tamanho de tela de smartphone, onde mudanças faciais sutis podem parecer mais evidentes.
Rejeite um clipe quando a boca continuar se movendo após a voz parar, os dentes mudarem de forma quadro a quadro, a mandíbula deslizar lateralmente, a cor dos olhos mudar, uma mão passar pela face ou a voz mudar abruptamente de idade ou distância. Não tente corrigir uma identidade quebrada com realce (sharpening). Execute novamente o menor segmento falhado a partir do último ponto âncora aprovado.
Quando várias falhas compartilharem uma mesma causa, simplifique antes de regenerar. Encurte a frase, remova um gesto, fixe a câmera, amplie o rosto na moldura ou substitua uma referência ambígua. Seedance Agent é útil nesta etapa, pois permite manter juntos o pacote de referência, os prompts por segmento, as saídas reais, as anotações e os pontos aprovados para reexecução. Você pode comparar os resultados de H3 com um fluxo de trabalho controlado de referência para vídeo, em vez de reconstruir o projeto a partir de arquivos dispersos.
Conclusão
Um avatar falante contínuo confiável de MiniMax H3 é montado a partir de segmentos curtos de fala, passíveis de revisão: cronometre o roteiro, mantenha uma única identidade e definição de voz de S1, coloque palavras exatas dentro de <d>, finalize cada clipe em um ponto âncora neutro e una as tomadas aprovadas sobre um tom ambiente contínuo. Este método não promete geração infinita; ele oferece um caminho recuperável para construir explicações mais longas sem sacrificar a fidelidade facial, vocal ou a sincronização labial. Para planejar referências, prompts, saídas, aprovações e reexecuções seletivas em uma única produção, inicie um projeto de avatar falante com Seedance Agent.
Pronto para testar por conta própria?
Coloque os passos desta guia em prática com Seedance e transforme prompts ou imagens em vídeos polidos em minutos.
Créditos grátis ao se cadastrar. Planos a partir de US$20/mês.
Artigos relacionados
Mais posts no mesmo idioma que talvez você queira ler a seguir.
Controle do Comprimento Focal da Câmera MiniMax H3: Aspectos Largos, Normais e Telefoto
Controle o aspecto aparente da lente no MiniMax H3 com tamanho da tomada, distância da câmera, linguagem de zoom, quadros de referência e um teste repetível de prompt de 24 mm a 85 mm.
Ler artigo
Fluxo de Trabalho de Vídeo para Duas Pessoas com MiniMax H3: Manter Papéis, Diálogos e Movimentos Claros
Criar uma cena com MiniMax H3 para duas pessoas com rótulos de sujeito estáveis, bloqueio legível, diálogos atribuídos, transferências limpas de adereços e um fluxo de trabalho prático de verificação de falhas.
Ler artigo
Guia de Acesso Antecipado ao Socialive Catalyst: Prepare um Primeiro Piloto Útil
Saiba quem pode acessar o Socialive Catalyst, o que está incluído na versão beta inicial, o que preparar para uma demonstração e como testar um fluxo de trabalho de vídeo corporativo com marca.
Ler artigo