
Como Fazer um Vídeo de IA Seguir uma Ação com Múltiplas Etapas
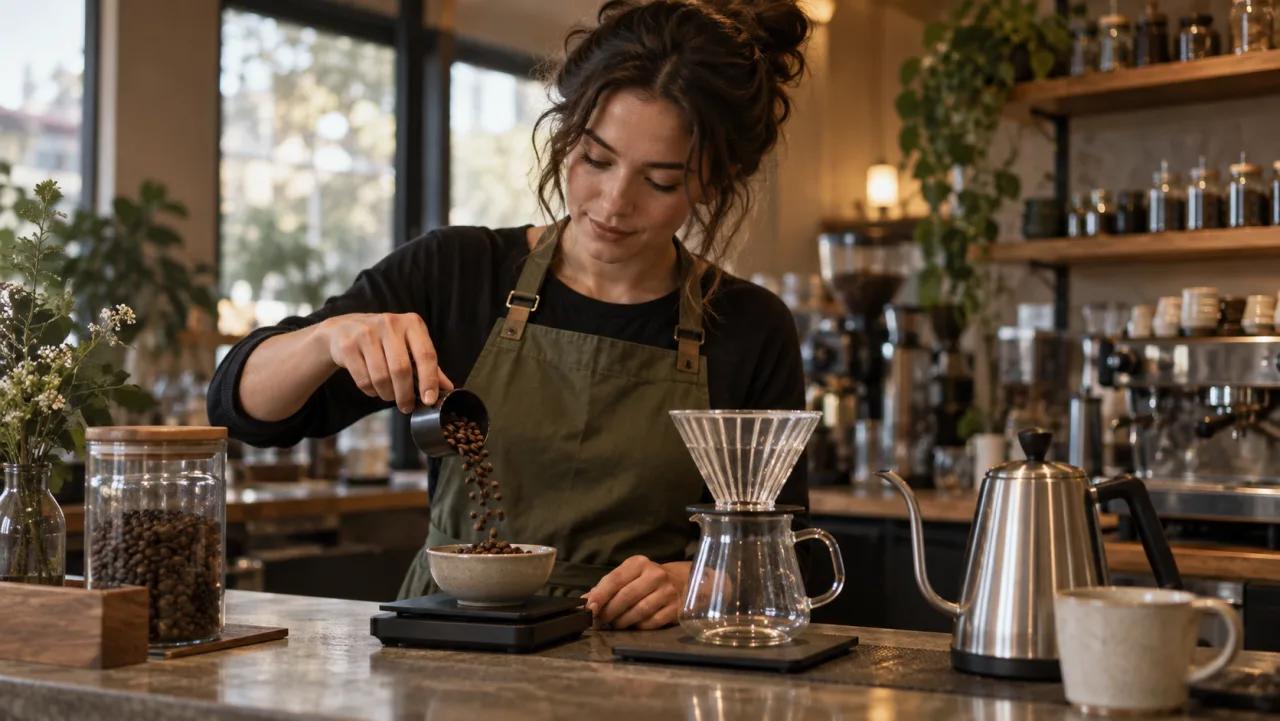
Um vídeo de IA frequentemente executa bem uma única ação visível, mas perde a sequência quando o prompt solicita cinco etapas. Um sujeito pode despejar antes de pegar o bule, um objeto pode retornar ao estado inicial entre etapas ou o clipe pode gastar toda a sua duração na pose inicial. A solução confiável é transformar a ideia em mudanças observáveis de estado, garantir tempo suficiente na tela para cada ação e dividir a sequência quando um único clipe não consegue representá-la com clareza.
Este guia mostra como fazer um vídeo de IA seguir uma ação com múltiplas etapas, sem tratar o prompt como um roteiro cinematográfico. O exemplo prático é um barista que mede grãos, despeja água, remove o coador e apresenta a xícara finalizada. O mesmo método se aplica a demonstrações de montagem, receitas, uso de produtos, tutoriais artesanais e pequenas sequências narrativas.
AI Overview
Como fazer um vídeo de IA seguir as etapas em ordem?
Escreva cada etapa como uma ação física visível, defina o estado antes e depois dela e conecte as ações com palavras explícitas de ordem ou carimbos de tempo. Mantenha a sequência curta o suficiente para caber na duração do clipe.
Uma ação com múltiplas etapas deve ser gerada em um único clipe?
Use um único clipe para duas ou três ações fortemente interligadas que caibam confortavelmente. Divida sequências mais longas, delicadas ou que envolvam mudanças de estado em tomadas separadas, levando adiante o último quadro aceito como ponto de partida.
Por que o modelo ignora a ação do meio?
O prompt pode conter muitas ações para os segundos disponíveis, ou o estado intermediário pode ser visualmente ambíguo. Dê a essa etapa uma interação concreta com um objeto, mais tempo e um resultado claro.
Como manter a consistência do sujeito e dos objetos?
Fixe a imagem de referência, a vestimenta, os adereços, a posição da câmera, a iluminação e o estado inicial. Reutilize um quadro-limite previamente aceito sempre que a próxima tomada deva começar exatamente onde a anterior terminou.
Definir Etapas Atômicas e Estados
Comece com um objetivo descrito em linguagem simples, depois reduza-o a ações que uma câmera possa capturar. “Fazer café” não é um plano de ações. “Ela despeja grãos no moedor” é. Evite combinar intenção, emoção, movimento de câmera e várias mudanças de objeto em uma única frase. Cada linha deve ter um ator, um verbo, um objeto e um resultado visível.
Crie uma planilha de transição de estados antes de escrever o prompt:
| Etapa | Estado inicial | Ação visível | Estado final | Travamento de continuidade |
|---|---|---|---|---|
| 1 | Grãos na colher; moedor vazio | Barista despeja grãos no moedor | Colher vazia; grãos no moedor | Mesmo avental, balcão e xícara |
| 2 | Bule erguido; leito de café seco | Barista despeja em círculo lento | Leito de café em floração | Mesma mão, bule e câmera |
| 3 | Despejo concluído; coador sobre a garrafa | Barista põe o bule sobre a bancada e levanta o coador | Xícara cheia pronta | Nível do líquido e posições dos adereços |
| 4 | Xícara sobre a bancada | Barista desliza a xícara para frente | Xícara finalizada apresentada | Mesma iluminação e fundo |
O estado final é tão importante quanto a ação. Ele informa ao gerador o que deve permanecer quando a próxima ação começa. Se um prato, ferramenta, vestuário ou produto mudar de orientação, anote esse resultado. Essa disciplina também melhora um fluxo de trabalho simples de texto para vídeo, pois o prompt descreve evidências, não uma intenção vaga.
Ajustar Ações à Duração Disponível
Uma sequência falha quando seu “orçamento de ações” excede seu “orçamento de tempo”. Reserve tempo para antecipação, execução e estabilização. A mão deve alcançar o bule antes de despejar; o bule deve parar antes de ser colocado sobre a bancada. Esses momentos de transição são breves, mas evitam “teletransporte”.
Para um clipe de cinco segundos, almeje uma única ação principal ou duas ações simples e interligadas. Em oito a dez segundos, duas ou três ações podem funcionar, desde que a câmera permaneça estável e os objetos continuem facilmente identificáveis. Quatro etapas deliberadas normalmente merecem múltiplas tomadas. Um ritmo de montagem acelerado pode mostrar mais eventos, mas não prova que uma única ação contínua foi concluída.
Atribua janelas temporais aproximadas apenas após simplificar a sequência. Por exemplo: 0–2 segundos, erguer o bule; 2–6 segundos, despejar em círculo lento; 6–8 segundos, devolver o bule à bancada. Deixe um estado de repouso limpo ao final. Carimbos de tempo exatos servem como orientação, não como comandos de edição precisos por quadro; portanto, avalie a ordem visível, não os números.
Se a duração for fixa, remova primeiro os movimentos decorativos. Uma órbita da câmera, vapor flutuante, clientes ao fundo e um movimento complexo das mãos competem todos pela capacidade de movimento. Mantenha a câmera fixa na primeira tentativa bem-sucedida e, só depois que a ordem das ações estiver estável, adicione um leve avanço (push-in) com moderação.
Construir um Prompt de Ação Sequencial
Descreva a cena estável uma vez, depois as ações ordenadas, e por fim as restrições de câmera e qualidade. Isso mantém o prompt legível e evita que um longo preâmbulo estilístico oculte a tarefa.
Use este modelo pronto para cópia:
[Sujeito e aparência fixa] em [ambiente estável].
Estado inicial: [posições das mãos, ferramentas e objetos].
Primeiro, [uma ação visível e seu resultado].
Em seguida, [uma ação visível e seu resultado].
Por fim, [uma ação visível e seu estado final de repouso].
As ações ocorrem nessa ordem exata, com contato natural das mãos e sem reinicialização de objetos.
[Enquadramento e movimento da câmera]. [Iluminação e estilo visual].
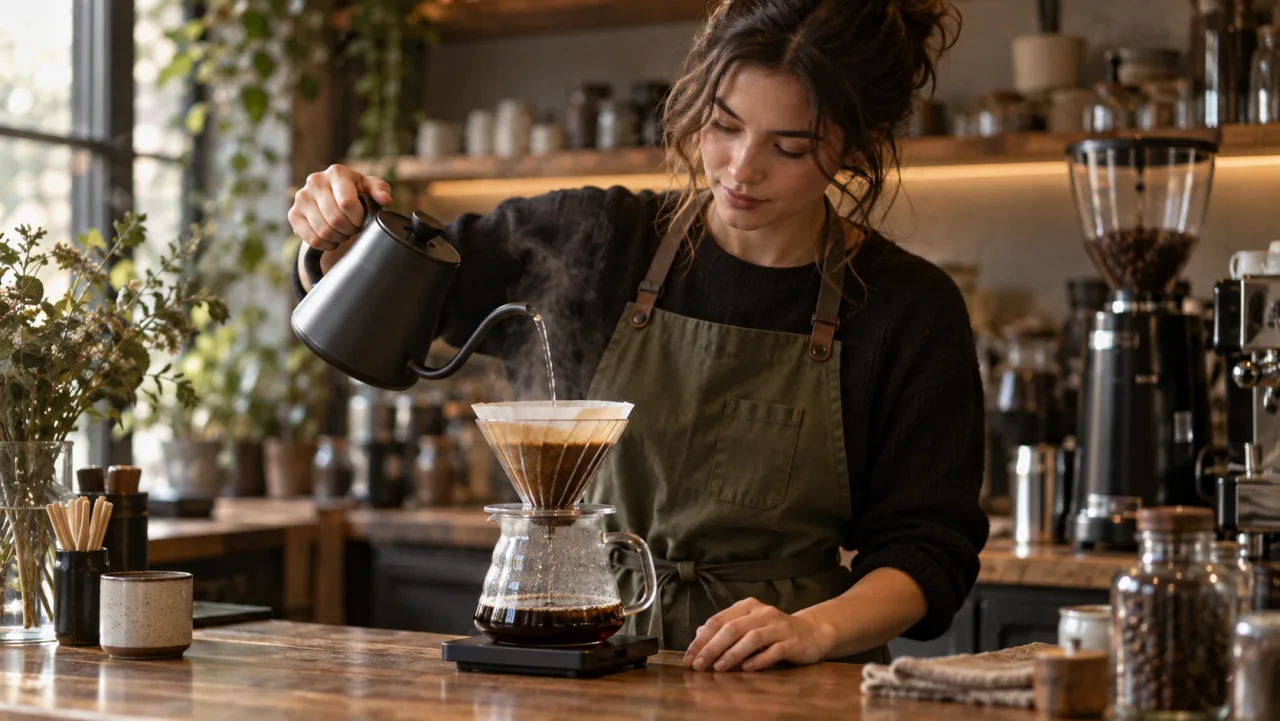
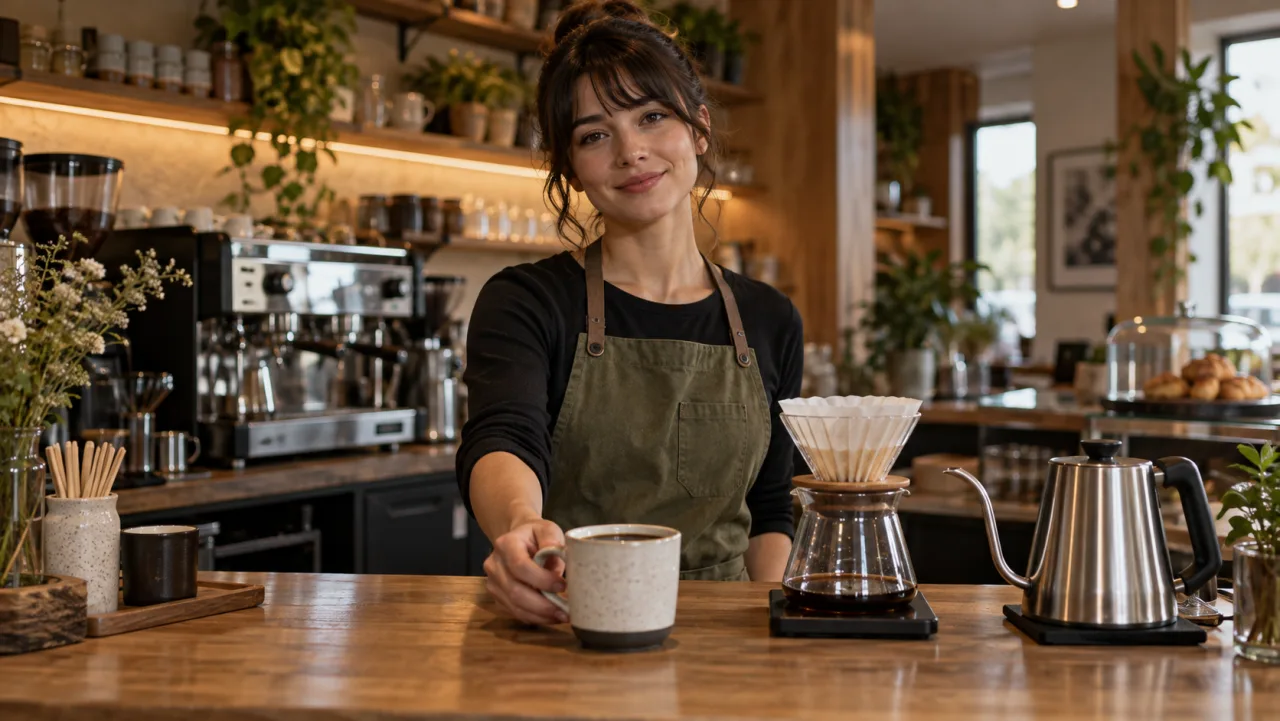
```Para a cena do café: “Uma barista com um avental verde-oliva está atrás de um balcão de madeira para café. Estado inicial: sua mão direita segura um bule de bico de ganso acima de uma camada seca de café moído. Primeiro, ela inicia um despejo lento em círculo. Em seguida, o café ‘floresce’ enquanto ela continua o movimento circular controlado. Por fim, ela interrompe o despejo e coloca o bule sobre o balcão. As ações ocorrem exatamente nessa ordem. Plano médio fixo, iluminação natural quente proveniente de uma janela.”
Descrições positivas geralmente funcionam melhor do que uma longa lista de proibições. Indique, por exemplo, “a xícara permanece no lado esquerdo da garrafa” em vez de depender apenas de “não mova a xícara”. Se a composição inicial for importante, comece com [image-to-video](/pt/image-to-video) e escolha uma referência que já contenha todos os objetos essenciais.
## Gerar uma única cena ou dividir em clipes
Gere uma única cena quando o mesmo sujeito executa uma ação contínua em um único local e a câmera pode observar todos os resultados. Divida a sequência quando um objeto se transforma, o sujeito muda de posição, uma nova ferramenta entra em cena ou um passo desaparece repetidamente.
Uma regra prática de decisão é simples: se você não conseguir descrever a sequência com três verbos e uma imagem inicial estável, use mais de uma cena. A cena um pode terminar com o bule repousando sobre o balcão. A cena dois começa a partir desse quadro final aceito e mostra a remoção do coador. Isso atribui a cada geração uma tarefa menor, preservando ao mesmo tempo a aparência de um fluxo de trabalho contínuo.
Não continue reexecutando um prompt sobrecarregado. Após duas ou três falhas com o mesmo passo ausente, reduza a unidade. O [tutorial Pika sobre múltiplos quadros-chave](/pt/blog/pika-multiple-keyframe-video-tutorial) é útil quando uma ferramenta suporta pontos de referência visual explícitos. Para controle mais amplo de identidade e ambiente, utilize os métodos descritos no [guia de consistência de vídeo IA](/pt/blog/best-ai-video-generator-for-consistency).
## Manter a continuidade entre etapas
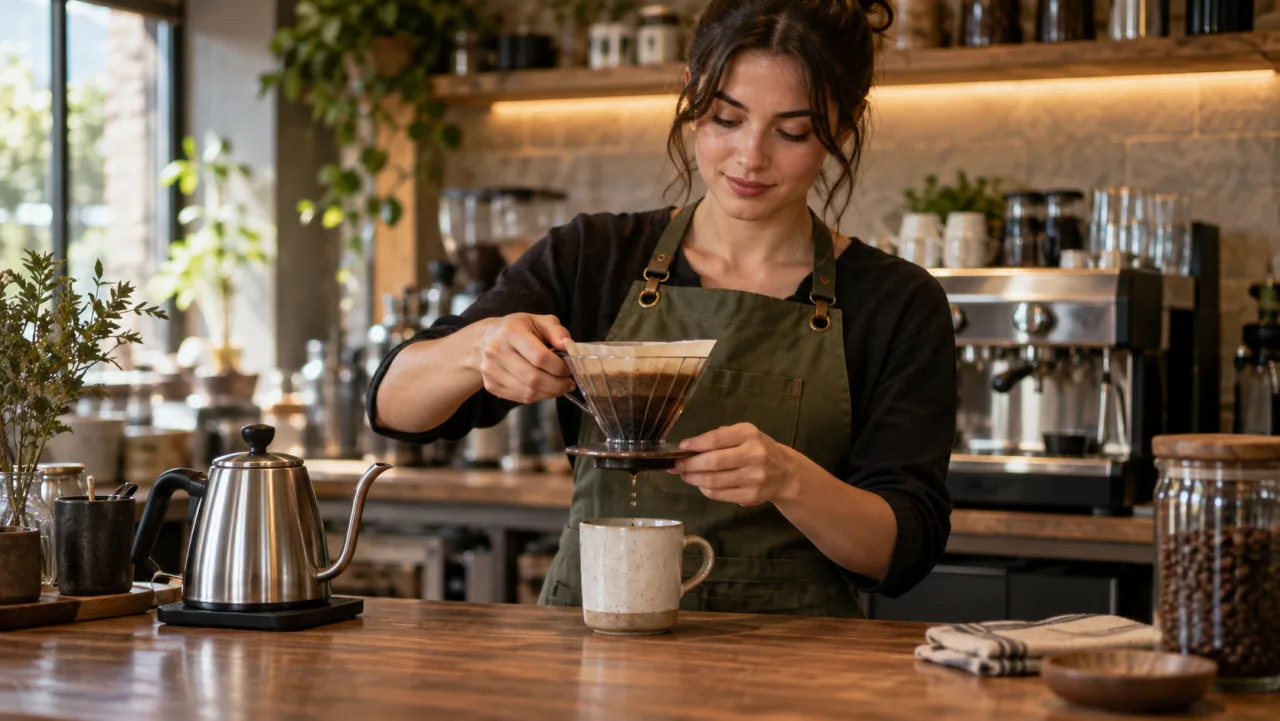
O limite entre clipes é onde fluxos de trabalho de múltiplas etapas frequentemente falham. Salve o quadro final somente após as mãos, os objetos e o sujeito estarem em um estado neutro e legível. Um quadro com desfoque de movimento, uma ferramenta parcialmente oculta ou dedos cruzando um objeto confere à próxima geração geometria incerta.
Transfira cinco travamentos para o próximo clipe: identidade do sujeito, vestuário, objeto principal, ambiente e direção da câmera. Anote também a variável que pode mudar. No exemplo do café, o nível do líquido pode subir, mas o design da xícara, o avental, o balcão e a direção da luz devem permanecer fixos.
Ao usar um quadro-limite, descreva-o como estado inicial, em vez de repetir toda a ação anterior. O próximo prompt deve dizer: “O bule repousa no lado direito do balcão e o coador cheio permanece acima da garrafa. A barista levanta o coador verticalmente.” Repetir o despejo induz o modelo a reiniciá-lo.
Este exemplo real de Seedance é incluído como referência de movimento independente para avaliar contato, estabilidade da câmera e assentamento. Não serve como evidência de que essa sequência exata de café foi gerada em uma única passagem.
```official-video
src=https://r2.seedance.tv/blog/runway-failed-generation-credits-refund/seedance-coffee-motion-control-v1.mp4
poster=https://r2.seedance.tv/blog/runway-failed-generation-credits-refund/seedance-coffee-motion-control-poster-v1.jpg
label=Seedance motion-control reference for action review
Revisar e corrigir a sequência
Assista primeiro em velocidade normal. Confirme que as ações ocorrem na ordem correta e que cada uma produz seu estado exigido. Em seguida, inspecione quadro a quadro ao redor do contato das mãos e dos limites entre cenas. Uma tomada bela ainda falha se a tampa se abre antes do toque da mão ou se um recipiente cheio fica vazio.
Use uma lista compacta de verificação para aceitação:
- Cada ação exigida aparece uma única vez e na ordem correta.
- Os estados inicial e final são visualmente legíveis.
- As mãos entram em contato com o objeto pretendido sem fusão nem troca de lado.
- Os objetos não desaparecem, duplicam, reiniciam ou alteram seu design.
- A direção da câmera e a posição do sujeito na tela permanecem consistentes.
- O quadro final pode servir como ponto limpo de transição ou edição.
Corrija a menor unidade defeituosa. Se a etapa dois estiver ausente, aloque-lhe mais tempo ou isole-a em uma nova cena. Se houver deriva de identidade, fortaleça a referência e reduza o movimento da câmera. Se o objeto se transformar, escolha um quadro-limite mais claro e reafirme sua geometria. Se a edição parecer abrupta, adicione uma pose de assentamento de meio segundo, em vez de regenerar toda a sequência.
O Seedance Agent é útil quando a tarefa exige várias gerações: ele pode manter juntos a planilha de estados, as referências, a ordem dos clipes, as anotações de revisão e as reexecuções direcionadas. Isso torna a aprovação focada em transições observáveis, em vez de questionar se um clipe atraente “parece certo”.
Conclusão
Para fazer vídeos de IA seguirem uma ação de múltiplas etapas, converta a ideia em verbos atômicos, defina todos os estados iniciais e finais, distribua as ações conforme a duração do clipe e divida a sequência antes que ela fique sobrecarregada. Preserve a continuidade com quadros-limite limpos, travamentos visuais estáveis e uma lista de verificação de revisão que teste a ordem — e não apenas o estilo. Quando estiver pronto para planejar, gerar, comparar e corrigir uma cadeia de ações mais longa, construa o fluxo de trabalho no Seedance Agent.
Pronto para testar por conta própria?
Coloque os passos desta guia em prática com Seedance e transforme prompts ou imagens em vídeos polidos em minutos.
Créditos grátis ao se cadastrar. Planos a partir de US$28/mês.
Artigos relacionados
Mais posts no mesmo idioma que talvez você queira ler a seguir.
Pictory Editar Vídeo Usando Texto: Cortar uma Gravação a Partir de sua Transcrição
Faça o upload de uma gravação para o Pictory, verifique sua transcrição, exclua texto para cortar o vídeo, corrija cortes bruscos e legendas, adicione imagens complementares (B-roll) e exporte uma versão final limpa.
Ler artigo
Tutorial em vídeo sobre o Voice Changer da ElevenLabs: Substituir uma voz e manter a performance
Transforme o diálogo de um vídeo com o Voice Changer da ElevenLabs, preserve a emoção e o sincronismo temporal, restaure a sincronização labial, solucione artefatos e finalize uma mixagem consistente.
Ler artigo
Runway Aleph Green Screen: Crie um sujeito com capacidade de chroma key e uma placa limpa
Transforme imagens normais em um ativo de fundo verde com o Runway Aleph 2.0, escreva um prompt preciso, aplique o chroma key ao resultado, corrija problemas nas bordas e crie uma placa limpa.
Ler artigo