
Comment faire en sorte qu’une vidéo générée par une IA suive une action en plusieurs étapes
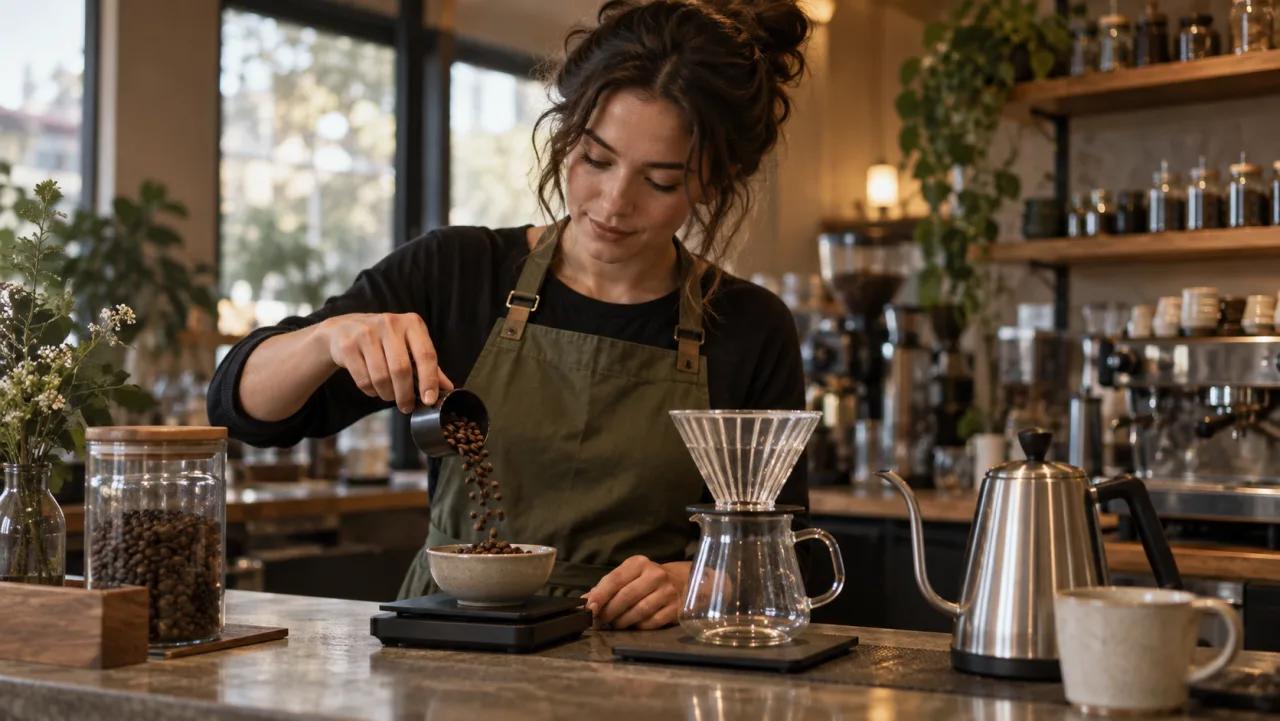
Une vidéo générée par IA gère souvent bien une seule action visible, mais perd le fil dès lors qu’une instruction demande d’en exécuter cinq. Par exemple, le sujet peut verser de l’eau avant d’avoir saisi la bouilloire, un objet peut revenir à son état initial entre deux étapes, ou la séquence peut consacrer toute sa durée à la pose initiale. La solution fiable consiste à reformuler l’idée en changements d’état observables, à accorder à chaque action suffisamment de temps à l’écran, et à scinder la séquence dès lors qu’un seul extrait ne parvient pas à la restituer proprement.
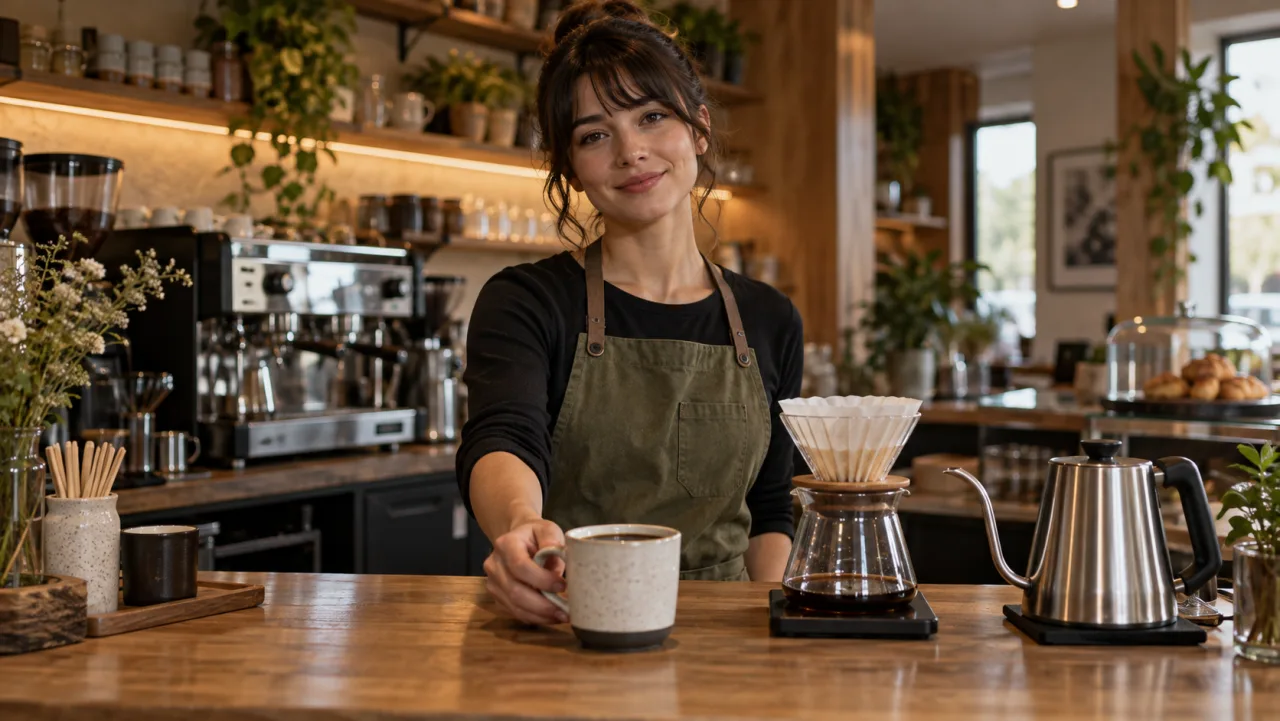
Ce guide explique comment faire en sorte qu’une vidéo générée par IA suive une action comportant plusieurs étapes, sans traiter l’instruction comme un scénario cinématographique. L’exemple concret utilisé ici est celui d’un barista qui dose les grains de café, verse de l’eau, retire le filtre et présente la tasse terminée. La même méthode s’applique aux démonstrations de montage, aux recettes, à l’utilisation de produits, aux tutoriels artisanaux et aux courts moments narratifs.
AI Overview
Comment faire en sorte qu’une vidéo générée par IA suive les étapes dans l’ordre ?
Formulez chaque étape comme une action physique visible, définissez clairement l’état avant et après celle-ci, et reliez les actions à l’aide de mots indiquant explicitement l’ordre ou de repères temporels. Gardez la séquence assez courte pour tenir dans la durée allouée à l’extrait.
Une action comportant plusieurs étapes doit-elle être générée en un seul extrait ?
Utilisez un seul extrait pour deux ou trois actions étroitement liées et facilement logeables dans le temps imparti. Scindez les séquences plus longues, plus délicates ou impliquant des changements d’état en prises de vue distinctes, en reportant systématiquement la dernière image acceptée comme point de départ de la suivante.
Pourquoi le modèle omet-il l’action intermédiaire ?
L’instruction peut contenir trop d’actions pour la durée disponible, ou l’état intermédiaire peut être visuellement ambigu. Accordez à cette étape une interaction concrète avec un objet, davantage de temps et un résultat clairement identifiable.
Comment maintenir la cohérence du sujet et des objets ?
Verrouillez l’image de référence, la tenue vestimentaire, les accessoires, la position de la caméra, l’éclairage et l’état initial. Réutilisez une image limite acceptée lorsque la prise suivante doit commencer exactement là où la précédente s’est terminée.
Définir des étapes atomiques et des états
Commencez par un objectif formulé en langage courant, puis réduisez-le à des actions perceptibles par une caméra. « Préparer du café » n’est pas un plan d’action. « Elle verse les grains dans le moulin à café » l’est. Évitez de combiner intention, émotion, mouvement de caméra et plusieurs changements d’objet dans une seule phrase. Chaque ligne doit comporter un seul acteur, un seul verbe, un seul objet et un seul résultat visible.
Rédigez une fiche de transition d’états avant de rédiger l’instruction :
| Étape | État initial | Action visible | État final | Verrouillage de continuité |
|---|---|---|---|---|
| 1 | Grains dans la cuillère ; moulin vide | Le barista verse les grains dans le moulin | Cuillère vide ; grains dans le moulin | Même tablier, comptoir, tasse |
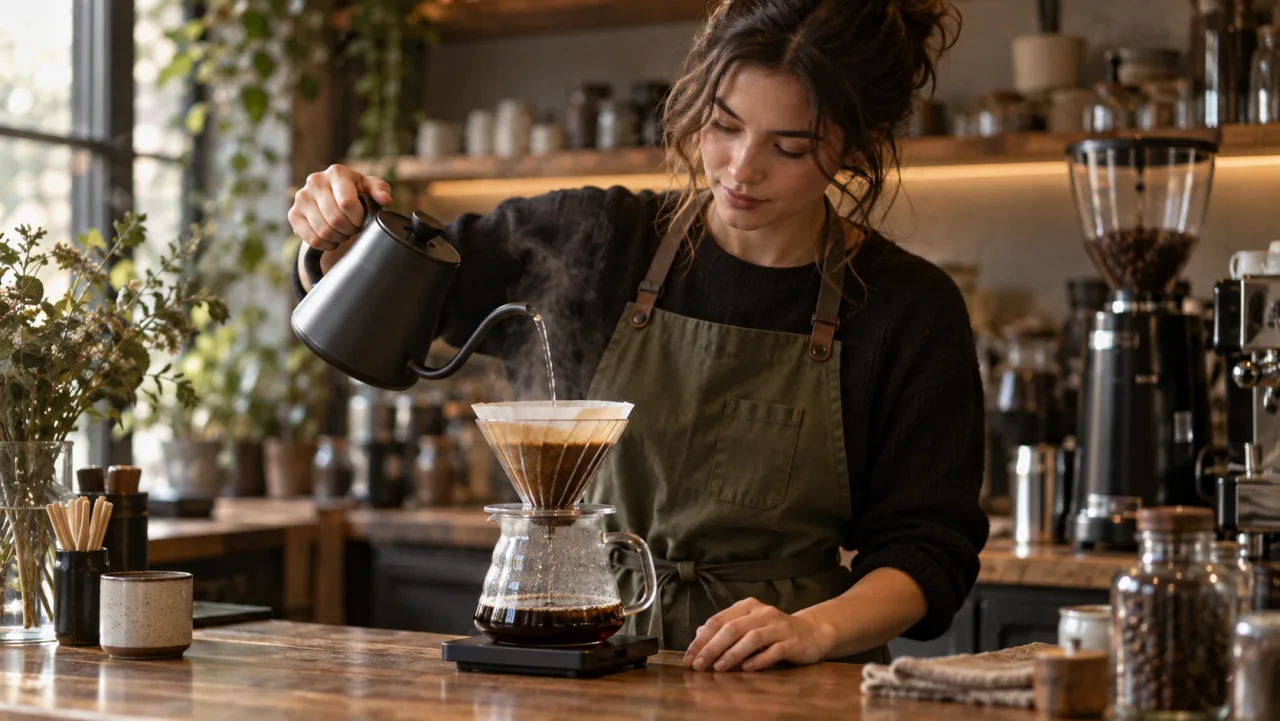
| 2 | Bouilloire levée ; lit de café sec | Le barista verse lentement en cercle | Lit de café gonflé (« bloom ») | Même main, bouilloire, caméra |
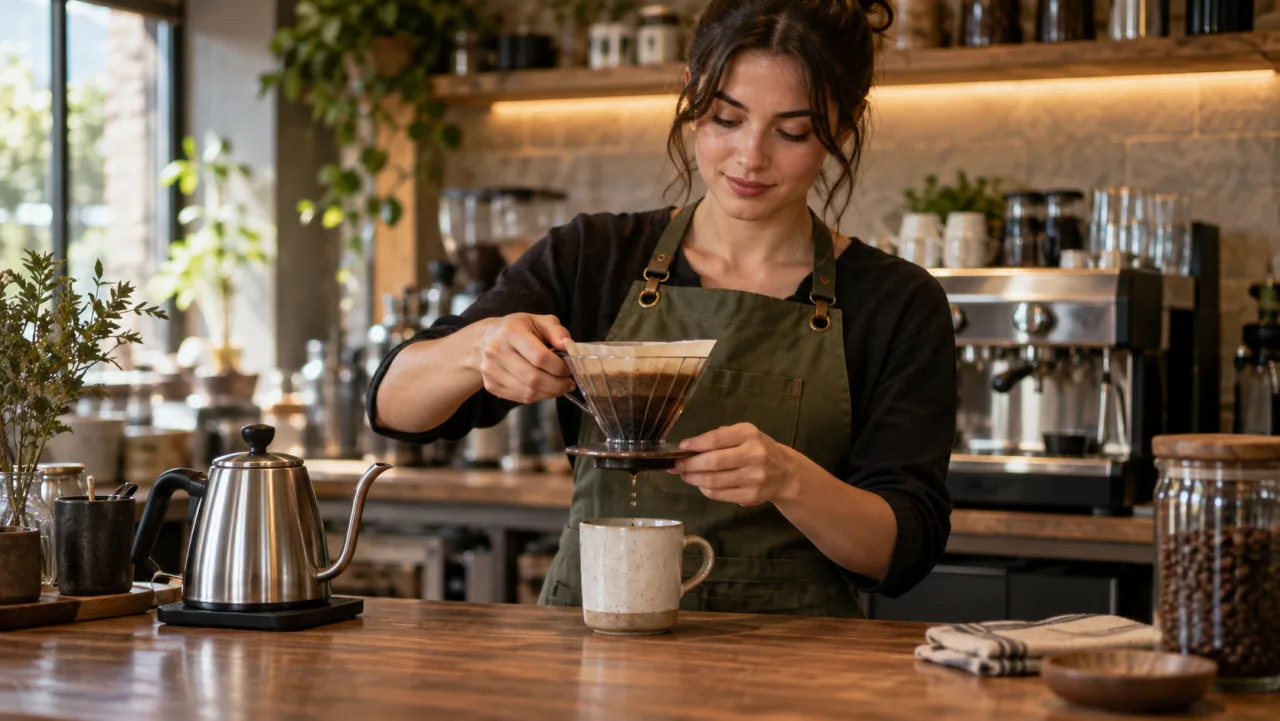
| 3 | Versement terminé ; filtre posé sur la carafe | Le barista pose la bouilloire et soulève le filtre | Tasse remplie prête | Niveau du liquide et positions des accessoires |
| 4 | Tasse posée sur le comptoir | Le barista fait glisser la tasse vers l’avant | Tasse présentée | Même éclairage et arrière-plan |
L’état final compte autant que l’action elle-même : il indique au générateur ce qui doit demeurer inchangé au début de l’action suivante. Si une assiette, un outil, un vêtement ou un produit change d’orientation, notez ce résultat. Cette discipline améliore également un flux de travail simple texte-vers-vidéo, car l’instruction décrit des éléments observables plutôt qu’une intention vague.
Adapter les actions à la durée disponible
Une séquence échoue lorsque son « budget d’actions » dépasse son « budget temporel ». Prévoyez du temps pour l’anticipation, l’exécution et la stabilisation. La main doit atteindre la bouilloire avant de verser ; la bouilloire doit s’immobiliser avant d’être reposée. Ces temps de transition sont brefs, mais ils évitent tout effet de téléportation.
Pour un extrait de cinq secondes, visez une seule action principale ou deux actions simples et connectées. Sur huit à dix secondes, deux ou trois actions peuvent convenir si la caméra reste stable et si les objets restent aisément lisibles. Quatre étapes délibérées méritent généralement plusieurs prises. Un montage rapide permet de montrer davantage d’événements, mais ne prouve pas qu’une action continue a été menée à terme.
N’attribuez des plages temporelles approximatives qu’après avoir simplifié la séquence. Par exemple : 0–2 secondes, lever la bouilloire ; 2–6 secondes, verser lentement en cercle ; 6–8 secondes, reposer la bouilloire sur le comptoir. Laissez un état de repos net à la fin. Les repères temporels précis servent de simple orientation, non d’instructions de montage cadencées image par image : évaluez donc l’ordre visible plutôt que les chiffres.
Si la durée est fixe, supprimez d’abord les mouvements décoratifs. Une rotation de caméra, de la vapeur flottante, des clients en arrière-plan ou un geste complexe de la main entrent tous en concurrence pour la capacité de représentation du mouvement. Verrouillez la caméra pour la première prise réussie, puis ajoutez une légère avancée progressive une fois que l’ordre des actions est stabilisé.
Construire une instruction d’action séquentielle
Décrivez une fois la scène stable, puis les actions ordonnées, puis les contraintes relatives à la caméra et à la qualité. Cela rend l’instruction lisible et empêche un long préambule stylistique d’en masquer la tâche centrale.
Utilisez ce modèle prêt à copier :
[Le sujet et son apparence fixe] dans [un environnement stable].
État initial : [positions des mains, des outils et des objets].
D’abord, [une action visible et son résultat].
Ensuite, [une action visible et son résultat].
Enfin, [une action visible et son état final de repos].
Les actions se produisent dans cet ordre exact, avec un contact naturel des mains et sans réinitialisation d’objets.
[Cadrage et mouvement de la caméra]. [Éclairage et style visuel].
```Pour la séquence café : « Une barista portant un tablier vert olive se tient derrière un comptoir à café en bois. État initial : sa main droite tient une bouilloire à bec verseur au-dessus d’un lit de café sec. D’abord, elle commence un versement circulaire lent. Ensuite, le café gonfle (« bloom ») tandis qu’elle poursuit ce cercle contrôlé. Enfin, elle cesse de verser et pose la bouilloire sur le comptoir. Les actions se déroulent dans cet ordre exact. Plan moyen verrouillé, lumière naturelle chaude provenant d’une fenêtre. »
Les descriptions positives fonctionnent généralement mieux qu’une longue liste d’interdictions. Précisez plutôt « la tasse reste sur le côté gauche de la carafe » plutôt que de vous contenter de « ne pas déplacer la tasse ». Si la composition initiale est cruciale, commencez par [image-to-video](/fr/image-to-video) et choisissez une référence contenant déjà tous les accessoires essentiels.
## Générer une seule séquence ou découper en plans
Générez un seul plan lorsque le même sujet exécute une action continue à un endroit fixe et que la caméra peut observer tous les résultats. Découpez la séquence lorsqu’un objet se transforme, lorsque le sujet change de position, lorsqu’un nouvel outil entre en scène, ou lorsqu’une étape disparaît répétitivement.
Une règle décisionnelle pratique est simple : si vous ne pouvez pas décrire la séquence avec trois verbes et une image initiale stable, utilisez plusieurs plans. Le plan un peut se terminer avec la bouilloire posée sur le comptoir. Le plan deux débute à partir de cette image finale acceptée et montre le retrait du filtre à goutte-à-goutte. Cela allège la tâche de chaque génération tout en préservant l’apparence d’un flux de travail unique.
N’insistez pas indéfiniment sur un prompt surchargé. Après deux ou trois échecs avec la même étape manquante, réduisez la granularité de l’unité. Le [tutoriel Pika sur les images-clés multiples](/fr/blog/pika-multiple-keyframe-video-tutorial) s’avère utile lorsque l’outil prend en charge des points de repère visuels explicites. Pour un contrôle plus large de l’identité et de l’environnement, appliquez les méthodes décrites dans le [guide de cohérence vidéo IA](/fr/blog/best-ai-video-generator-for-consistency).
## Assurer la continuité entre les étapes
La frontière entre les plans est souvent là où les workflows multi-étapes échouent. Ne sauvegardez la dernière image que lorsque les mains, les accessoires et le sujet sont dans un état neutre et lisible. Une image comportant du flou de mouvement, un outil partiellement masqué ou des doigts traversant un objet fournit à la génération suivante une géométrie incertaine.
Transférez cinq éléments verrouillés vers le plan suivant : identité du sujet, tenue vestimentaire, objet principal, environnement et direction de la caméra. Indiquez également la variable autorisée à changer. Dans l’exemple du café, le niveau de liquide peut monter, mais le design de la tasse, le tablier, le plan de travail et la direction de la lumière doivent rester fixes.
Lorsque vous utilisez une image-frontière, décrivez-la comme état initial plutôt que de répéter toute l’action précédente. Le prompt suivant doit dire : « La bouilloire repose sur le côté droit du comptoir et le filtre rempli demeure au-dessus de la carafe. La barista soulève le filtre verticalement. » Répéter le versement inciterait le modèle à le redémarrer.
Cet exemple réel de Seedance est inclus comme référence de mouvement indépendante pour évaluer le contact, la stabilité de la caméra et le temps de stabilisation. Il ne prouve pas que cette séquence café précise ait été générée en une seule passe.
```official-video
src=https://r2.seedance.tv/blog/runway-failed-generation-credits-refund/seedance-coffee-motion-control-v1.mp4
poster=https://r2.seedance.tv/blog/runway-failed-generation-credits-refund/seedance-coffee-motion-control-poster-v1.jpg
label=Seedance motion-control reference for action review
Examiner et corriger la séquence
Regardez d’abord à vitesse normale. Vérifiez que les actions se produisent dans l’ordre prévu et que chacune aboutit à l’état requis. Ensuite, examinez image par image les zones de contact des mains et les frontières entre les plans. Une prise magnifique échoue néanmoins si le couvercle s’ouvre avant que la main ne le touche, ou si un récipient rempli devient vide.
Utilisez une liste compacte de critères d’acceptation :
- Chaque action requise apparaît une fois et dans l’ordre.
- Les états initial et final sont lisibles visuellement.
- Les mains entrent en contact avec l’objet prévu sans fusion ni changement de côté.
- Les accessoires ne disparaissent pas, ne se dupliquent pas, ne reviennent pas à leur état initial ni ne changent de design.
- La direction de la caméra et la position à l’écran du sujet restent constantes.
- L’image finale peut servir de point de transmission propre ou de point de montage.
Corrigez l’unité défectueuse la plus petite. Si l’étape deux est absente, accordez-lui davantage de temps ou isolez-la dans un nouveau plan. Si l’identité dérive, renforcez la référence et réduisez le mouvement de caméra. Si l’objet se transforme, choisissez une image-frontière plus claire et reformulez sa géométrie. Si le montage semble brutal, ajoutez une pose de stabilisation d’une demi-seconde plutôt que de régénérer toute la séquence.
Seedance Agent s’avère utile lorsque la tâche nécessite plusieurs générations : il permet de conserver ensemble la fiche d’état, les références, l’ordre des plans, les notes d’analyse et les régénérations ciblées. Cela rend l’approbation centrée sur les transitions observables, plutôt que sur la question de savoir si un plan attrayant « donne l’impression d’être juste ».
Conclusion
Pour faire en sorte que la vidéo IA suive une action multi-étapes, transformez l’idée en verbes atomiques, définissez précisément chaque état initial et final, répartissez les actions selon la durée du plan, et découpez la séquence avant qu’elle ne devienne surchargée. Préservez la continuité à l’aide d’images-frontières propres, de verrous visuels stables et d’une liste de vérification qui teste l’ordre plutôt que le style seul. Lorsque vous êtes prêt à planifier, générer, comparer et corriger une chaîne d’actions plus longue, construisez le workflow dans Seedance Agent.
Prêt à essayer par vous-même ?
Mettez en pratique les étapes de ce guide dans Seedance et transformez vos prompts ou images en vidéos abouties en quelques minutes.
Crédits offerts à l'inscription. Forfaits à partir de $28/mois.
Articles associés
D'autres articles dans la même langue à lire ensuite.
Pictory Modifier une vidéo à l’aide de texte : découper un enregistrement à partir de sa transcription
Téléversez un enregistrement sur Pictory, vérifiez sa transcription, supprimez du texte pour couper la vidéo, corrigez les coupes brusques et les sous-titres, ajoutez des séquences B-roll, puis exportez une version finale propre.
Lire l'article
Tutoriel vidéo ElevenLabs Voice Changer : Remplacer une voix tout en conservant la performance
Transformez le dialogue d’une vidéo à l’aide d’ElevenLabs Voice Changer, préservez les émotions et le rythme, restaurez la synchronisation labiale, résolvez les artefacts et finalisez un mix cohérent.
Lire l'article
Runway Aleph Green Screen : Créer un sujet claquable et une plaque propre
Transformer des séquences vidéo classiques en ressource verte avec Runway Aleph 2.0, rédiger une invite précise, effectuer le chroma key sur le résultat, corriger les problèmes de contour et générer une plaque propre.
Lire l'article