
Tutoriel vidéo ElevenLabs Voice Changer : Remplacer une voix tout en conservant la performance
AI Overview
ElevenLabs Voice Changer peut-il traiter un fichier vidéo ?
Oui. La version web de Voice Changer accepte des fichiers audio ou vidéo enregistrés ou téléchargés, puis renvoie une parole transformée que vous pouvez replacer sous l’image d’origine.
Voice Changer préserve-t-il le rythme et l’émotion ?
Il est conçu pour préserver la performance source, y compris le débit, l’accentuation, les accents régionaux, les chuchotements, les rires et la transmission émotionnelle, tout en modifiant la voix perçue du locuteur.
Quelle est la durée maximale d’un segment Voice Changer ?
ElevenLabs indique actuellement une limite de cinq minutes par segment pour Voice Changer. Divisez les scènes plus longues en sections contrôlées et conservez des « handles » (marges) pour des coupes propres.
Voice Changer est-il identique au doublage ou à la synthèse vocale (text-to-speech) ?
Non. Voice Changer transfère une performance orale existante ; le doublage traduit et adapte le discours, tandis que la synthèse vocale génère une lecture à partir d’un texte écrit.
Planifier le remplacement vocal avant le téléchargement
Le flux de travail vidéo de changement de voix avec ElevenLabs comporte deux tâches distinctes : transformer une performance, puis synchroniser le nouvel audio avec l’image. Voice Changer convertit la parole enregistrée en une voix sélectionnée tout en conservant une grande partie du rythme et de l’expression d’origine. Il ne finalise pas automatiquement votre mix vidéo, ne corrige pas systématiquement tous les décalages labiaux, ni ne décide quels souffles ou bruits ambiants doivent figurer dans la scène. Traitez le résultat téléchargé comme une nouvelle piste dialogue nécessitant examen et montage.
Commencez par une courte scène et rédigez une note d’acceptation avant toute intervention sur l’audio. Identifiez le locuteur, la langue, la voix cible, l’intention émotionnelle, les points exacts d’entrée et de sortie, ainsi que la visibilité ou non de la bouche. Une prise large à vocation pédagogique tolère davantage de dérive temporelle qu’une réplique dramatique en gros plan. Conservez le clip original, une exportation propre du dialogue, la prise transformée et la vidéo finale synchronisée comme fichiers séparés.
Les droits sur la voix relèvent de la production, non d’une tâche de nettoyage. Utilisez votre propre performance, une voix dont vous êtes autorisé à vous servir, ou une voix issue d’une bibliothèque correctement licenciée. Ne présentez jamais une voix transformée comme une approbation réelle d’une personne physique. Si la voix cible correspond à un personnage récurrent, enregistrez l’identifiant vocal et les paramètres approuvés afin que la scène suivante démarre depuis la même base.
Image de production illustrative originale. Enregistrez une performance maîtrisée tout en regardant l’image, et conservez la prise non traitée comme référence temporelle.
Si la vidéo elle-même nécessite encore une performance stable du personnage, construisez-la d’abord dans l’espace de travail image-vers-vidéo. Pour un projet complet comportant de nombreux clips, utilisez l’espace de travail création vidéo afin de séparer les décisions visuelles des révisions vocales.
Exporter une performance source propre depuis la vidéo
La performance source détermine le rythme, l’émotion, la prononciation et les pauses : la préparation audio compte donc davantage que l’ajustement ultérieur des paramètres. N’exportez que la plage de dialogue nécessaire. Utilisez un format courant préservant une qualité suffisante pour le traitement, évitez les exports successifs avec perte, et laissez de courtes marges (« handles ») avant et après la réplique pour les fondues.
Écoutez attentivement la musique, les effets sonores, la réverbération, les autres locuteurs et le bruit de fond. La conversion vocale peut réinterpréter tout ce qui atteint la piste parlée. Si votre vidéo contient une bande-son mixée, isolez d’abord le dialogue ou revenez à la timeline du projet pour exporter uniquement le locuteur concerné. ElevenLabs documente une option de suppression du bruit ambiant, mais celle-ci ne doit pas remplacer une source propre lorsque vous maîtrisez le montage.
Enregistrez avec une distance micro constante et un niveau modéré. Les consonnes saturées ne peuvent pas être restaurées par un simple changement de voix, et des portes de bruit trop agressives risquent de couper des syllabes ou des souffles discrets. Préservez les détails utiles de la performance : un rire, un chuchotement, une pause ou une élocution tendue peuvent précisément correspondre à ce que Voice Changer est conçu pour transposer dans la voix cible.
Pour les scènes dépassant cinq minutes, effectuez les coupes aux pauses naturelles plutôt qu’à des limites temporelles arbitraires. Ajoutez, si possible, une ou deux secondes de chevauchement, puis choisissez la transition la plus propre après conversion. Tenez une fiche de repérage indiquant le nom du fichier, le timecode source, le texte de la réplique, l’émotion visée et la voix cible. Cela évite d’insérer une réplique corrigée dans la mauvaise prise.
Transformer la voix dans ElevenLabs
Ouvrez Voice Changer, enregistrez directement ou téléchargez l’audio ou la vidéo préparée, puis sélectionnez la voix cible autorisée. ElevenLabs décrit actuellement le produit comme une solution « parole-à-parole » : elle transfère une performance existante vers une autre voix, plutôt que de générer une nouvelle performance à partir d’un script. Le guide officiel des fonctionnalités recommande le modèle multilingue parole-à-parole pour de nombreux cas d’usage, et documente 29 langues prises en charge pour ce modèle.
Testez d’abord une réplique représentative avant de traiter l’intégralité de la scène. Elle doit inclure la hauteur habituelle du locuteur, un pic émotionnel, une phrase discrète et le nom propre le plus difficile à prononcer. Générez la prise et comparez-la à la source en termes d’exactitude des mots, de cadence, de position des souffles, de clarté des consonnes et de forme émotionnelle. Un timbre convaincant ne suffit pas si la performance s’est appauvrie ou si la dernière syllabe tombe après le point de coupe.
*Configuration illustrative de performance. Transmettez au modèle le rythme et l’émotion souhaités via la performance source, plutôt que d’attendre que la voix cible les invente.*Modifiez une seule variable à la fois. Commencez par confirmer la voix cible et le modèle. Ensuite, comparez uniquement la suppression du bruit de fond si du bruit est effectivement présent. Évitez d’exécuter une performance médiocre à travers de nombreux paramètres ; enregistrer à nouveau une prise claire et intentionnelle est généralement plus facile à évaluer. Téléchargez chaque sortie acceptée avec un nom de version incluant la scène, la réplique, la voix, la langue et le numéro de prise.
Remplacer le dialogue original et rétablir la synchronisation
Importez le fichier transformé dans votre logiciel d’édition sur une nouvelle piste située directement sous la piste du dialogue original. Alignez-vous sur la première consonne nette ou sur le premier transitoire, et non simplement sur le début du fichier. Coupez le son de la piste originale, observez attentivement les mouvements de la bouche pendant toute la durée de la réplique, et placez des repères partout où la synchronisation commence à dériver.
Ne modifiez pas immédiatement la durée de l’ensemble de la prise par time-stretching. Commencez par supprimer les silences initiaux, vérifiez si le taux d’échantillonnage de l’export source a changé, puis alignez les pauses internes. Des ajustements régionaux fins sont moins dommageables que de forcer toute la phrase à s’adapter à une nouvelle durée. Découpez aux inspirations ou aux images où la bouche est fermée, déplacez la phrase suivante, et utilisez des fondues croisées courtes à puissance égale. Si un mot reste visiblement désynchronisé, régénérez cette phrase à partir d’une prise source dont la durée correspond exactement.
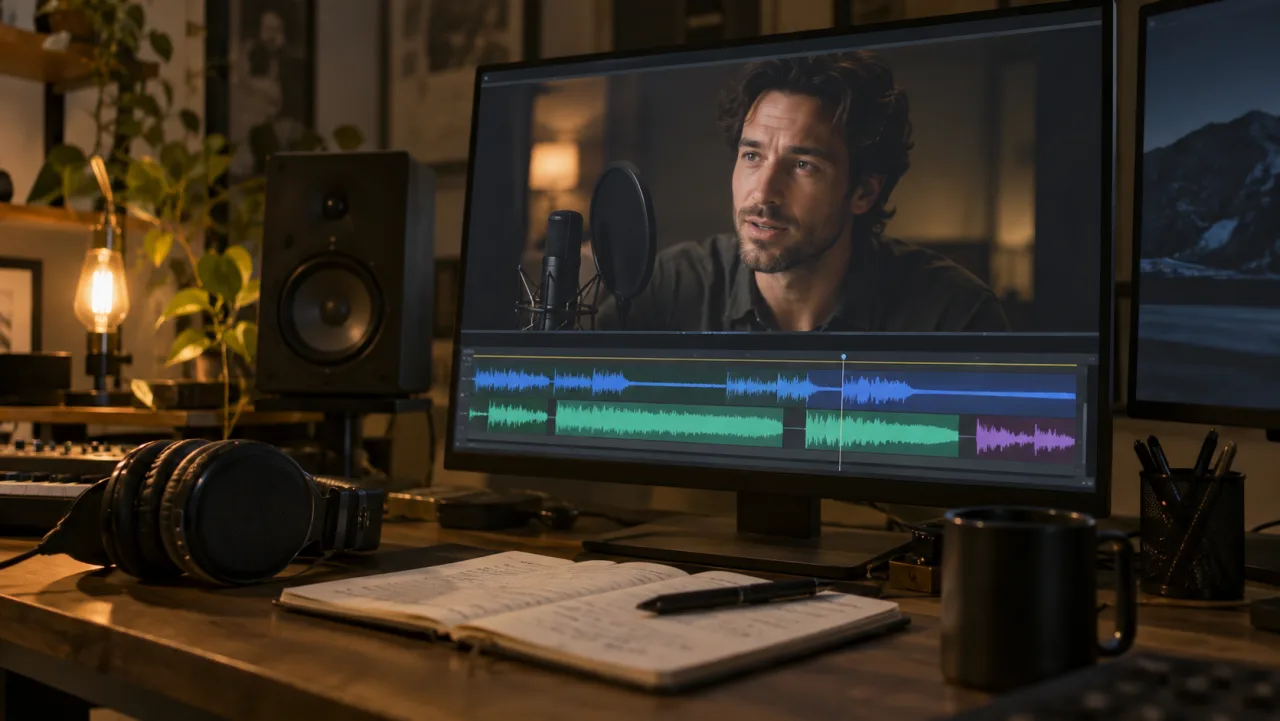
Vue illustrative de finition, non une interface ElevenLabs. Alignez la parole sur l’image dans l’éditeur, puis restaurez l’ambiance et les effets autour de la piste approuvée contenant le dialogue.
Il s’agit d’un exemple réel de mouvement Seedance, et non d’un résultat ElevenLabs Voice Changer. Utilisez-le pour vous entraîner à vérifier la fermeture de la bouche, le timing des syllabes, les mouvements de la tête et le ton ambiante par rapport à l’image animée.
Restaurez les sons non dialogués une fois la synchronisation stabilisée. Ajoutez le ton ambiante d’origine en dessous, recréez les respirations uniquement là où elles servent la performance, et réinsérez la musique et les effets sur des pistes séparées. Une voix transformée parfaitement propre placée dans une pièce bruyante semblera déconnectée, à moins que l’ambiance, la perspective et la réverbération ne correspondent exactement au plan.
Harmoniser la voix, la scène et le mix sur plusieurs extraits
La cohérence relève d’un système de production. Conservez la même voix cible approuvée et le même modèle de base sur toute une scène. Enregistrez les prises complémentaires à une distance micro similaire et avec une intensité de jeu comparable. Une prise forte et rapprochée dans une source, et une autre discrète et lointaine dans une autre, peuvent produire des résultats qui semblent provenir d’enregistrements différents, même si l’identité vocale est nominativement identique.
Ajustez le niveau sonore après le montage, et non en appliquant systématiquement un limiteur à chaque génération. Comparez le timbre du dialogue, la perspective acoustique de la pièce, la sifflement (sibilance), le niveau des respirations et le bruit de fond. N’utilisez qu’un léger égaliseur et une compression légère une fois que la prise vocale approuvée est correctement synchronisée. Vérifiez l’écoute sur casque, sur petits haut-parleurs et sur smartphone, car les consonnes agressives et les tons ambiants mal adaptés se révèlent souvent sur des systèmes audio limités.
Pour les projets multilingues, déterminez si l’objectif est un remplacement vocal dans la même langue ou une traduction. Voice Changer préserve une réplique jouée ; il ne dispense pas de la planification nécessaire concernant la longueur du script traduit ni les mouvements labiaux. Si vous avez besoin de dialogue traduit, consultez le flux de travail distinct pour le doublage vidéo et prévoyez du temps pour l’adaptation des textes et l’approbation speaker par speaker.
Utilisez une grille comparative pour chaque extrait : intelligibilité de la source, identité cible, émotion, prononciation, synchronisation, ambiance et statut des droits. Indiquez une seule raison de rejet plutôt que des notes vagues telles que « ça sonne faux ». Cela rend la prochaine prise ou conversion plus ciblée.
Résolvez les problèmes vidéo courants liés à Voice Changer.
Si les mots semblent brouillés, revenez à la source propre et vérifiez les clips, les chevauchements, la réverbération excessive et la musique de fond. Si l’émotion disparaît, enregistrez une interprétation plus explicite plutôt que d’augmenter aléatoirement le traitement. Si la voix change de caractère entre deux extraits, vérifiez que la même voix, le même modèle, la même langue et le même style source ont bien été utilisés.
En cas de dérive temporelle, mesurez précisément où elle commence. Un décalage constant indique un problème d’alignement ; une dérive croissante suggère un problème de durée ou de taux d’échantillonnage ; une seule phrase défectueuse nécessite une correction locale ou un nouvel enregistrement. Lorsque la bouche est visible, choisissez des points de coupe naturels correspondant à des instants où la bouche est fermée, et évitez d’étirer les consonnes. Lorsque le locuteur est hors champ, privilégiez le rythme et la continuité sonore.
La suppression du bruit de fond peut aider une source bruyante, mais écoutez attentivement la disparition des respirations, les résonances métalliques et les mots calmes tronqués. Comparez-la à une exportation manuelle propre du dialogue. Si une autre voix perce dans l’extrait, isolez ou réenregistrez la réplique plutôt que d’espérer qu’une seule conversion parviendra à séparer et transformer uniquement la personne visée.
Le guide de dépannage pour la génération audio fournit un schéma décisionnel utile pour distinguer les échecs de génération des problèmes d’édition. Pour la finition axée sur les lèvres, le tutoriel de synchronisation labiale explique comment inspecter le timing des mouvements buccaux plutôt que de juger uniquement sur la base de l’audio.
Examiner, versionner et livrer la vidéo finale
Regardez une première fois pour suivre l’histoire, puis une deuxième fois pour détecter les défauts. Lors de ce second passage, examinez le nom propre le plus difficile, le pic émotionnel, la réplique la plus discrète, le mouvement labial le plus rapide, la première image après chaque coupure, ainsi que la transition vers le ton ambiante. Ensuite, comparez le mix final avec l’original à niveau sonore identique. Une voix différente peut sembler plus impressionnante simplement parce qu’elle est plus forte.
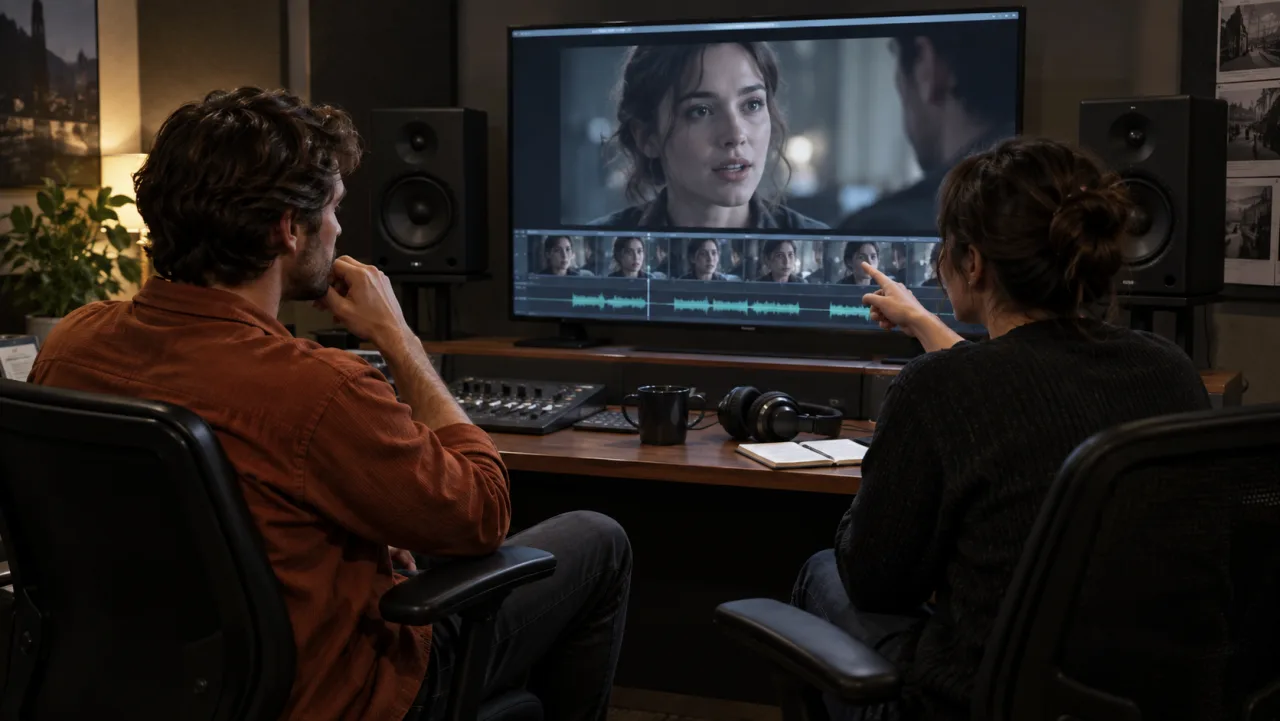
Session d’approbation à titre illustratif. Vérifiez l’identité vocale, l’intelligibilité, le calage labial, l’ambiance sonore et la divulgation avant d’exporter la vidéo finale.
Conservez les supports originaux, la source isolée, la piste transformée, le fichier de session, le mix final et l’enregistrement d’approbation. Notez la voix cible, le modèle, la langue, la base juridique des droits, la date de traitement et le monteur.
Pour les campagnes comportant de nombreuses scènes, Seedance Agent peut organiser les références, les feuilles de repérage, les versions vocales, les décisions des relecteurs et les réexécutions sélectives. Il n’accorde pas de droits sur la voix ni ne certifie une synchronisation parfaite, mais il rend la traçabilité de la production visible et empêche qu’une ancienne prise ne réintègre discrètement le montage final.
Conclusion
Un flux de travail vidéo ElevenLabs Voice Changer fiable commence par une voix cible autorisée et une interprétation source propre et intentionnelle. Transformez une courte phrase représentative, conservez les paramètres approuvés, alignez la nouvelle piste sur l’image, corrigez localement les dérives temporelles, restaurez le bruit ambiant de la pièce, puis examinez séparément l’identité vocale, l’émotion, la prononciation et le calage labial. Conservez toutes les sources et toutes les approbations traçables afin que les révisions ultérieures ne rompent pas la continuité. Pour coordonner les prises vocales, les références de scène, les approbations et l’assemblage final dans une production plus vaste, construisez le flux de travail avec Seedance Agent.
Prêt à essayer par vous-même ?
Mettez en pratique les étapes de ce guide dans Seedance et transformez vos prompts ou images en vidéos abouties en quelques minutes.
Crédits offerts à l'inscription. Forfaits à partir de $28/mois.
Articles associés
D'autres articles dans la même langue à lire ensuite.
Runway Aleph Green Screen : Créer un sujet claquable et une plaque propre
Transformer des séquences vidéo classiques en ressource verte avec Runway Aleph 2.0, rédiger une invite précise, effectuer le chroma key sur le résultat, corriger les problèmes de contour et générer une plaque propre.
Lire l'article
Tutoriel de remplacement d’objets vidéo Pika : remplacer un objet sans altérer la prise de vue
Apprenez à remplacer un objet dans une vidéo Pika à l’aide de Pikaswaps, à rédiger des invites cibles et de remplacement précises, à corriger les scintillements et à vérifier la continuité du mouvement.
Lire l'article
Les nœuds vidéo ComfyUI n’apparaissent pas : identifiez et corrigez l’étape manquante
Résolvez le problème des nœuds vidéo ComfyUI manquants en vérifiant la propriété des nœuds, les importations Python, les versions, les chemins des modèles, ainsi qu’un test vidéo rapide avant toute réinstallation.
Lire l'article