
Flujo de trabajo para video con dos personas en MiniMax H3: mantener claros los roles, el diálogo y el movimiento
AI Overview
¿Puede MiniMax H3 generar a dos personas en un solo vídeo?
Sí. H3 puede representar múltiples personajes, pero cada persona necesita una identidad, posición, acción y rol hablante distintos. Una escena corta con una sola interacción es más fiable que un indicio (prompt) sobrecargado con varios movimientos simultáneos.
¿Cómo evitar que dos personajes intercambien sus identidades?
Asigne etiquetas estables como Subject 1 y Subject 2, otorgue a cada uno una vestimenta única y una posición fija en pantalla, y repita únicamente los rasgos que deben persistir. Use imágenes de referencia separadas cuando la precisión de la identidad sea crítica.
¿Cómo debe redactarse el diálogo entre dos personas en MiniMax H3?
Asigne identificadores estables a los hablantes, como S1 y S2, indique quién habla antes de cada línea y coloque únicamente las palabras exactas pronunciadas dentro de la etiqueta de diálogo. Especifique que la boca del oyente permanece cerrada.
¿Qué modo de H3 es el más adecuado para una escena con dos personajes?
Use el modo de texto o de primer fotograma para una escena inventada sencilla, el modo de primer y último fotograma para una transición controlada única, y el modo de referencia completa cuando imágenes, movimientos o recursos vocales independientes deban definir a las dos personas.
Elija el modo de H3 adecuado para dos personas
Deje que la restricción más exigente determine el modo de entrada
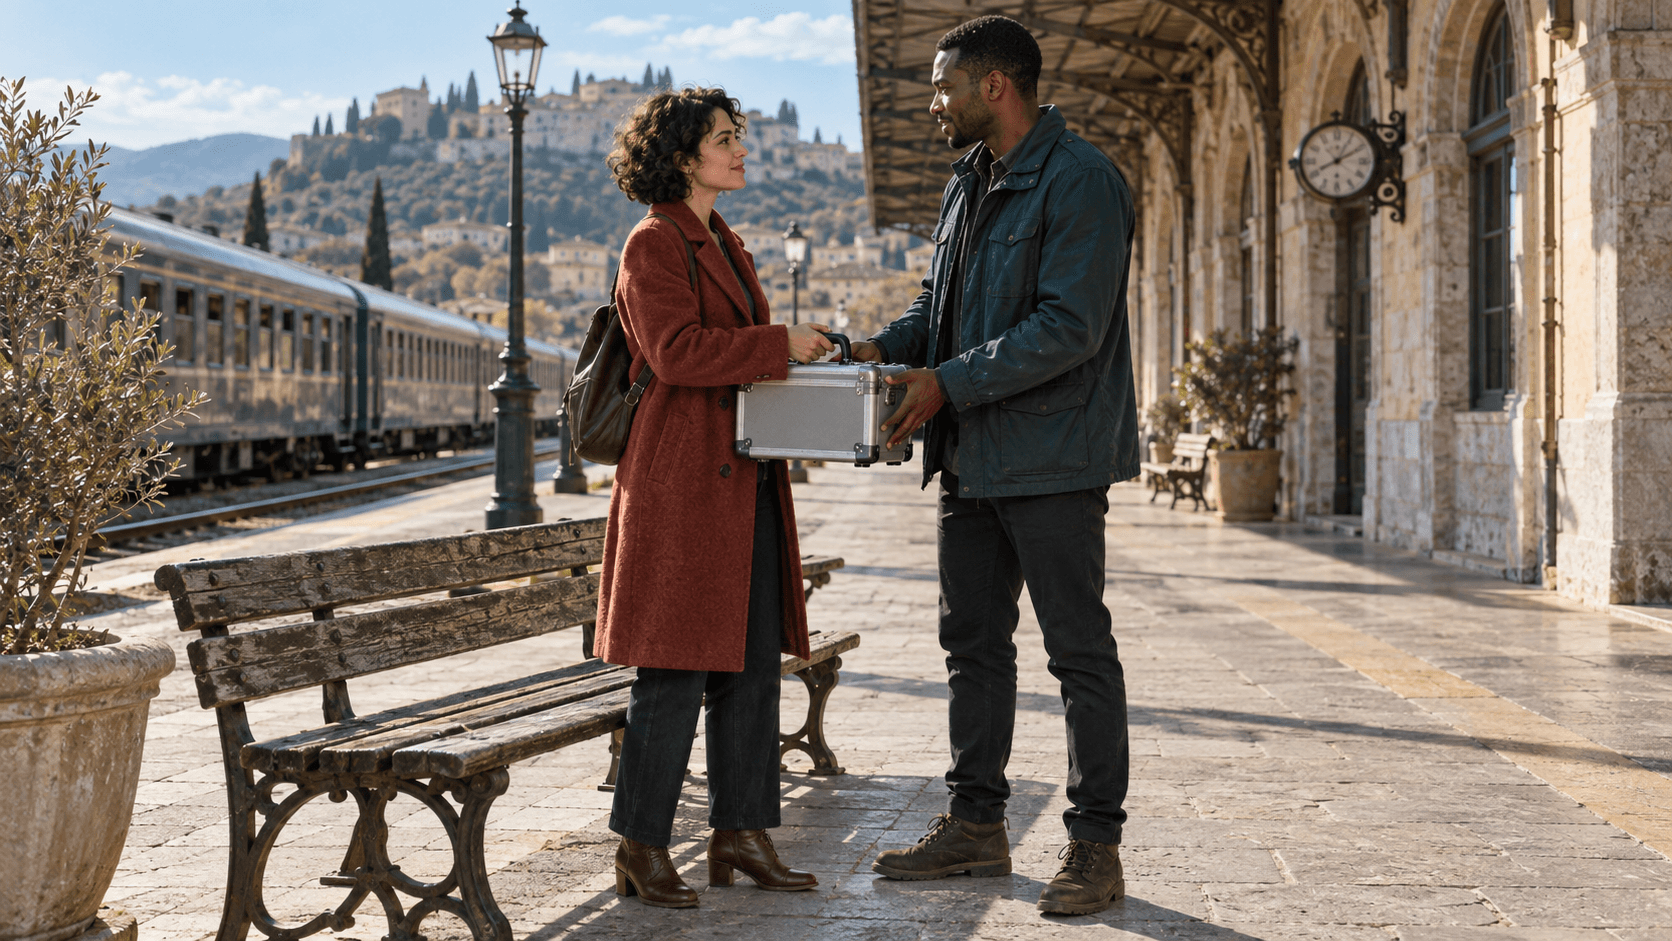
Un flujo de trabajo de MiniMax H3 para vídeos con dos personas comienza antes de redactar el indicio (prompt). Decida qué elementos deben controlarse con precisión. La generación texto-audio-vídeo es suficiente cuando ambos personajes pueden inventarse. Un único primer fotograma resulta útil cuando ya importan la composición inicial, la vestimenta y las posiciones relativas. El modo de primer y último fotograma es útil cuando una interacción única debe finalizar en un estado conocido, por ejemplo, cuando una persona entrega una maleta a otra.
El modo de referencia completa es la opción más adecuada cuando el Personaje A y el Personaje B provienen de imágenes de identidad diferentes, cuando un vídeo independiente aporta el movimiento corporal o cuando las referencias vocales son relevantes. MiniMax admite hasta nueve imágenes de referencia, tres vídeos y tres fragmentos de audio, con un total de 12 archivos de referencia. El audio de referencia no puede ser la única entrada; debe acompañarse de una imagen o un vídeo. No combine tareas de control por fotogramas y de referencia completa en una única solicitud.
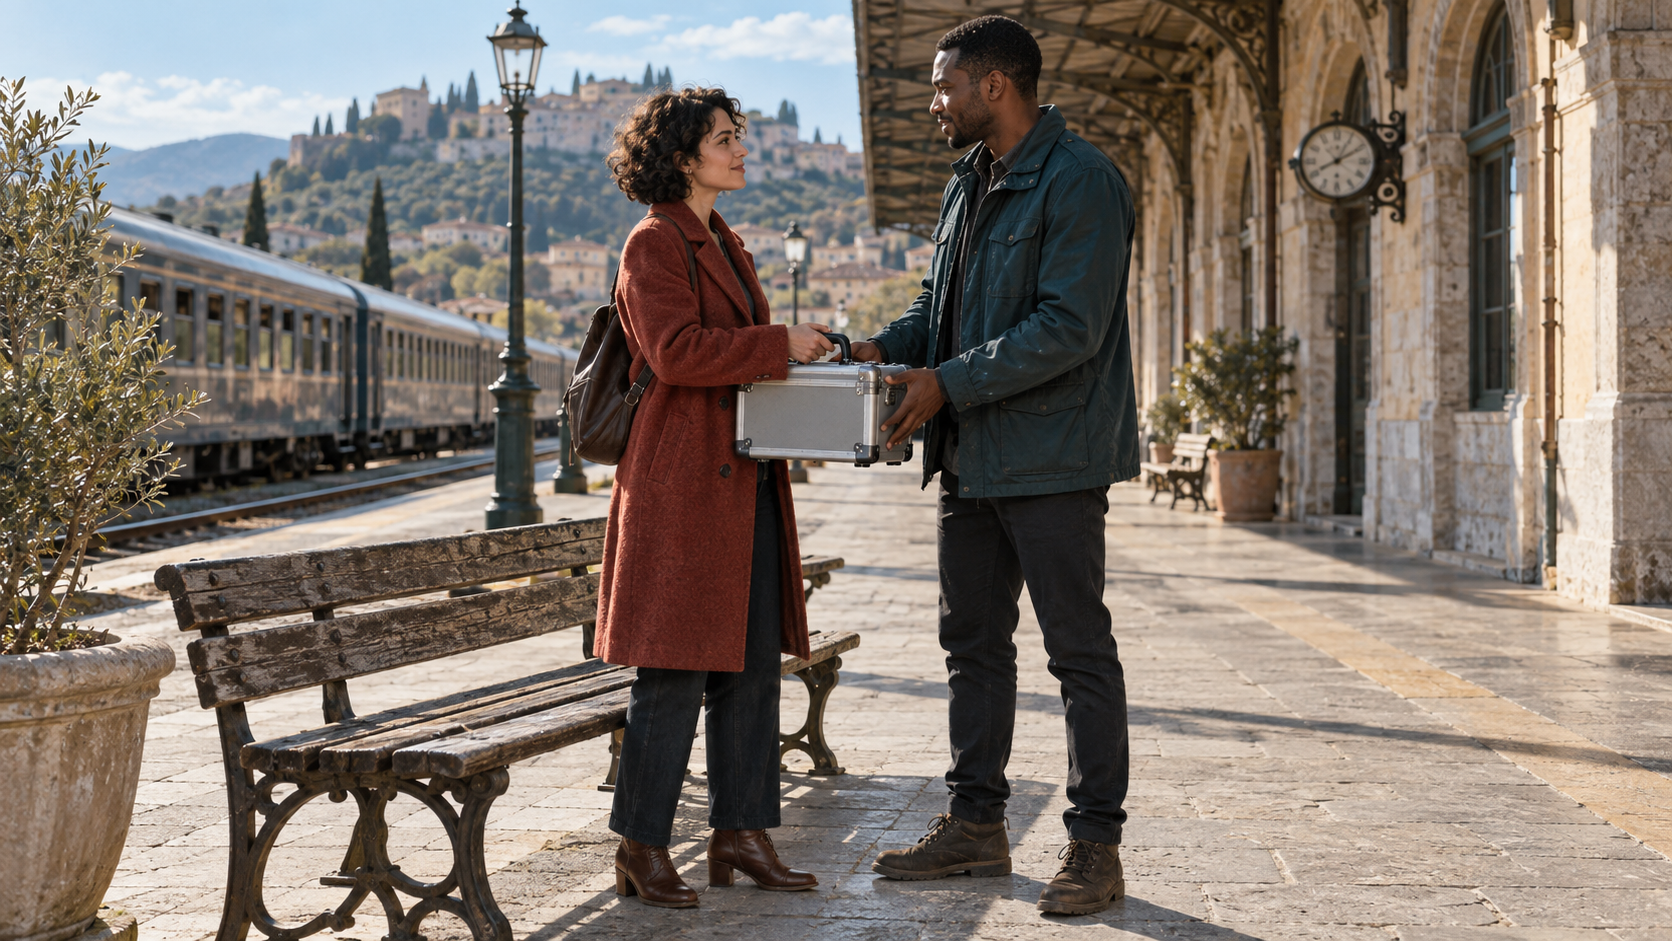
Fotograma de referencia generado ilustrativo: dos abrigos distintos, siluetas separadas, un andén fijo y un objeto compartido crean anclajes de continuidad fácilmente identificables.
Utilice la duración como un «presupuesto de acciones». H3 admite vídeos de 4 a 15 segundos, pero 15 segundos no significa que pueda incluir más trama. Asigne a dos personas un único «acento causal»: acercamiento, intercambio y estabilización; pregunta, respuesta y reacción; o entrada, percepción y salida. Si la escena requiere una segunda ubicación u otra acción importante, cree un nuevo clip y conéctelo mediante un flujo de trabajo multitoma reanudable.
Defina Subject 1 y Subject 2
Cree una tarjeta compacta de identidad y bloqueo
Redacte las descripciones de los dos personajes como registros de producción independientes antes de escribir la línea temporal. Cada tarjeta debe especificar una identidad visible, vestimenta, posición inicial, propiedad de objetos, límite de movimiento, identificador del hablante y fuente de referencia. Las diferencias deben ser fácilmente apreciables a simple vista; frases como «dos personas con chaquetas oscuras» invitan a la ambigüedad.
| Control | Subject 1 | Subject 2 |
|---|---|---|
| Identidad | Mujer, principios de los 30, rizos oscuros cortos | Hombre, mediados de los 30, cabello muy corto |
| Vestimenta | Abrigo de lana color óxido, botas marrones | Chaqueta táctica verde azulado intenso, botas oscuras |
| Posición inicial | Izquierda de la pantalla, junto al banco | Derecha de la pantalla, cerca del muro de la estación |
| Estado del objeto | Sostiene el asa de la maleta | Sostiene el cuerpo de la maleta |
| Identificador del hablante | S1 | S2 |
| Límite de movimiento | Un paso hacia adelante, suelta el asa | Recibe la maleta, da un paso atrás |
En el modo de referencia completa, defina qué aporta cada recurso. Una etiqueta de sujeto representa contenido visual reutilizable, mientras que las etiquetas «Imagen», «Vídeo» y «Audio» identifican los soportes originales o referencias estructurales. No denomine toda la primera imagen como Subject 1 si contiene a dos personas y una ubicación. Indique que Subject 1 es la mujer de la «Imagen 1» y que Subject 2 es el hombre de la «Imagen 2»; defina la plataforma por separado únicamente si debe reutilizarse activamente.
subject_definitions:
<Subject 1> es la mujer de <Picture 1>, conservando sus rizos oscuros cortos, su abrigo color óxido, su rostro y sus botas marrones.
<Subject 2> es el hombre de <Picture 2>, conservando su cabello muy corto, su chaqueta verde azulado intenso, su rostro y sus botas oscuras.
<Subject 3> es la pequeña maleta de equipamiento plateada mostrada en <Picture 3>, conservando su tamaño, su asa, sus cierres y su acabado de metal cepillado.
Evite volver a describir los rostros de forma distinta en tomas posteriores. Las etiquetas estables reducen la competencia entre adjetivos y referencias. Para anclajes escénicos que deben persistir ante cambios de punto de vista, la guía de coherencia ambiental de MiniMax H3 explica cómo nombrar arquitectura, dirección de la luz, mobiliario y objetos de fondo sin convertir el indicio (prompt) en un catálogo.
Bloquee la interacción y la entrega del objeto
Describa los cambios de estado, no solo las intenciones
«Intercambian la maleta de forma natural» oculta los fotogramas más difíciles. Describa el estado del objeto en orden de reproducción: Subject 1 sostiene el asa; Subject 2 coloca ambas manos bajo la maleta; ambos la sostienen brevemente; Subject 1 abre los dedos y retira la mano; Subject 2 retrocede con la maleta; ambos se estabilizan. Así, el modelo dispone de una secuencia observable, en lugar de una vaga acción social.
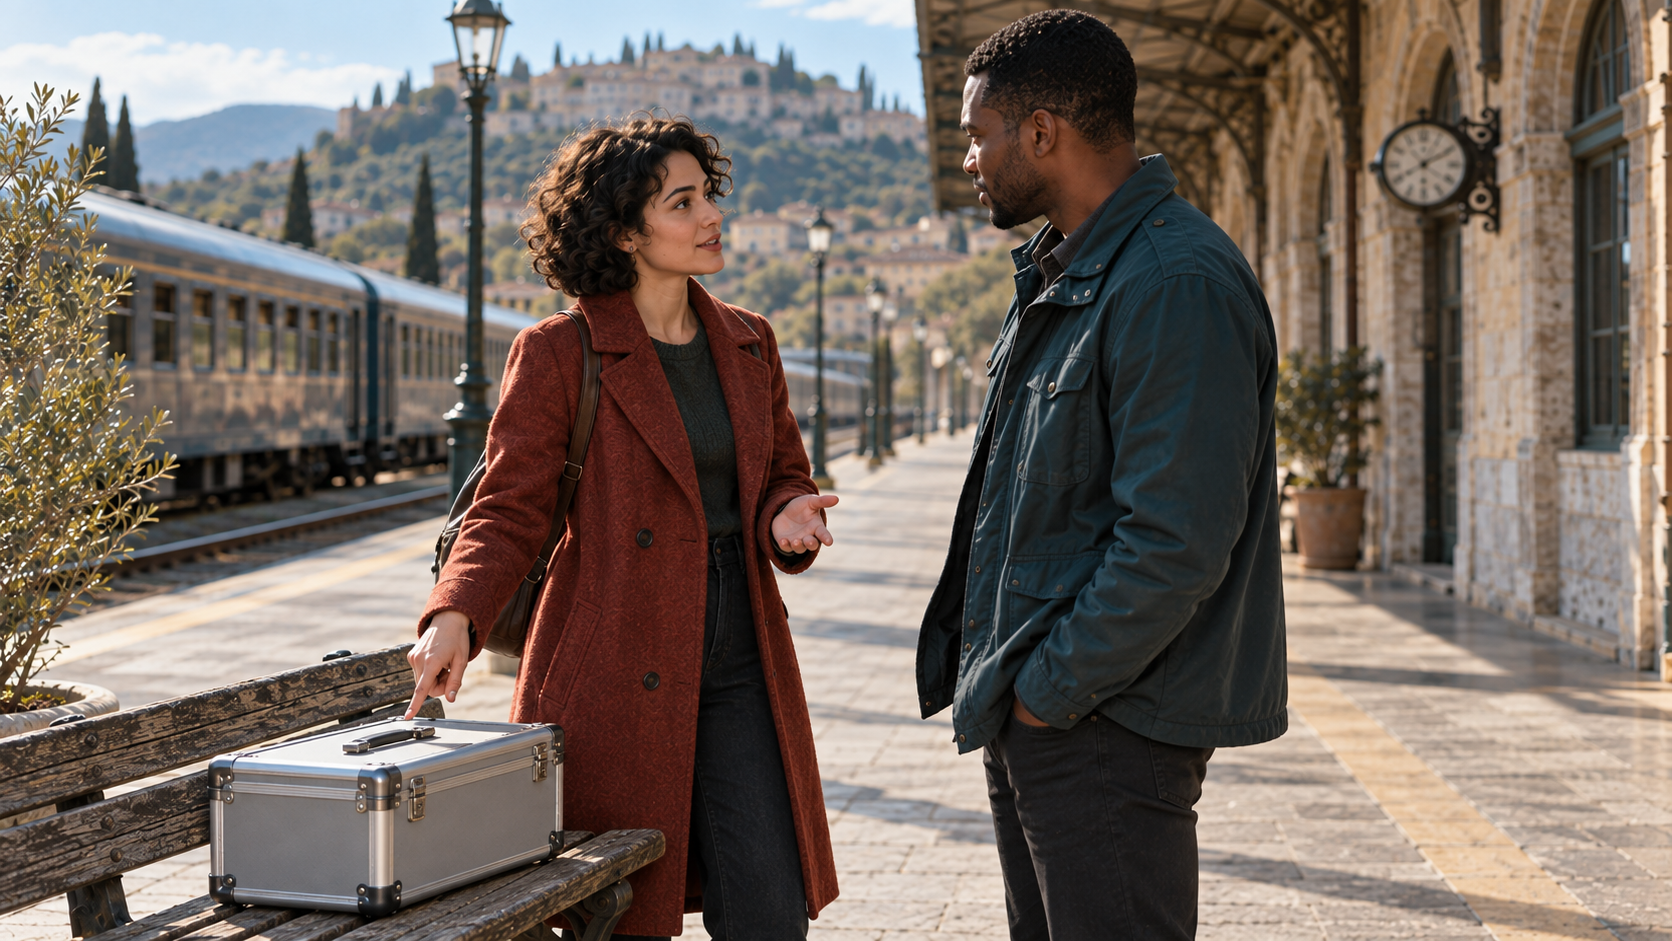
Fotograma de bloqueo generado ilustrativo: el hablante posee el gesto, el oyente mantiene una línea visual clara y el maletín permanece en una ubicación estable antes de la entrega.
Mantenga un lenguaje espacial coherente. «Izquierda de pantalla» y «derecha de pantalla» son términos relativos a la cámara; «cerca de las vías» y «cerca del muro de la estación» resisten mejor un cambio de ángulo inverso. Cuando un corte modifica la orientación, restablezca la posición de ambas personas antes de la siguiente acción. Use un solo movimiento de cámara a la vez —por ejemplo, un acercamiento lento hacia la pareja— en lugar de combinar un arco, un zoom, un barrido (pan) y una sacudida tipo cámara en mano.
Las manos fallan cuando ambas personas intentan atravesarse mutuamente o cuando el prompt omite una fase de contacto. Otorgue al maletín un tamaño suficiente para permitir dos agarres claramente legibles, evite que cualquiera de los cuerpos cruce al otro y permita que el intercambio dure varios segundos. Un final limpio es fundamental: identifique quién posee el maletín, dónde se ubica cada persona, hacia dónde mira y si alguno de los labios está en movimiento.
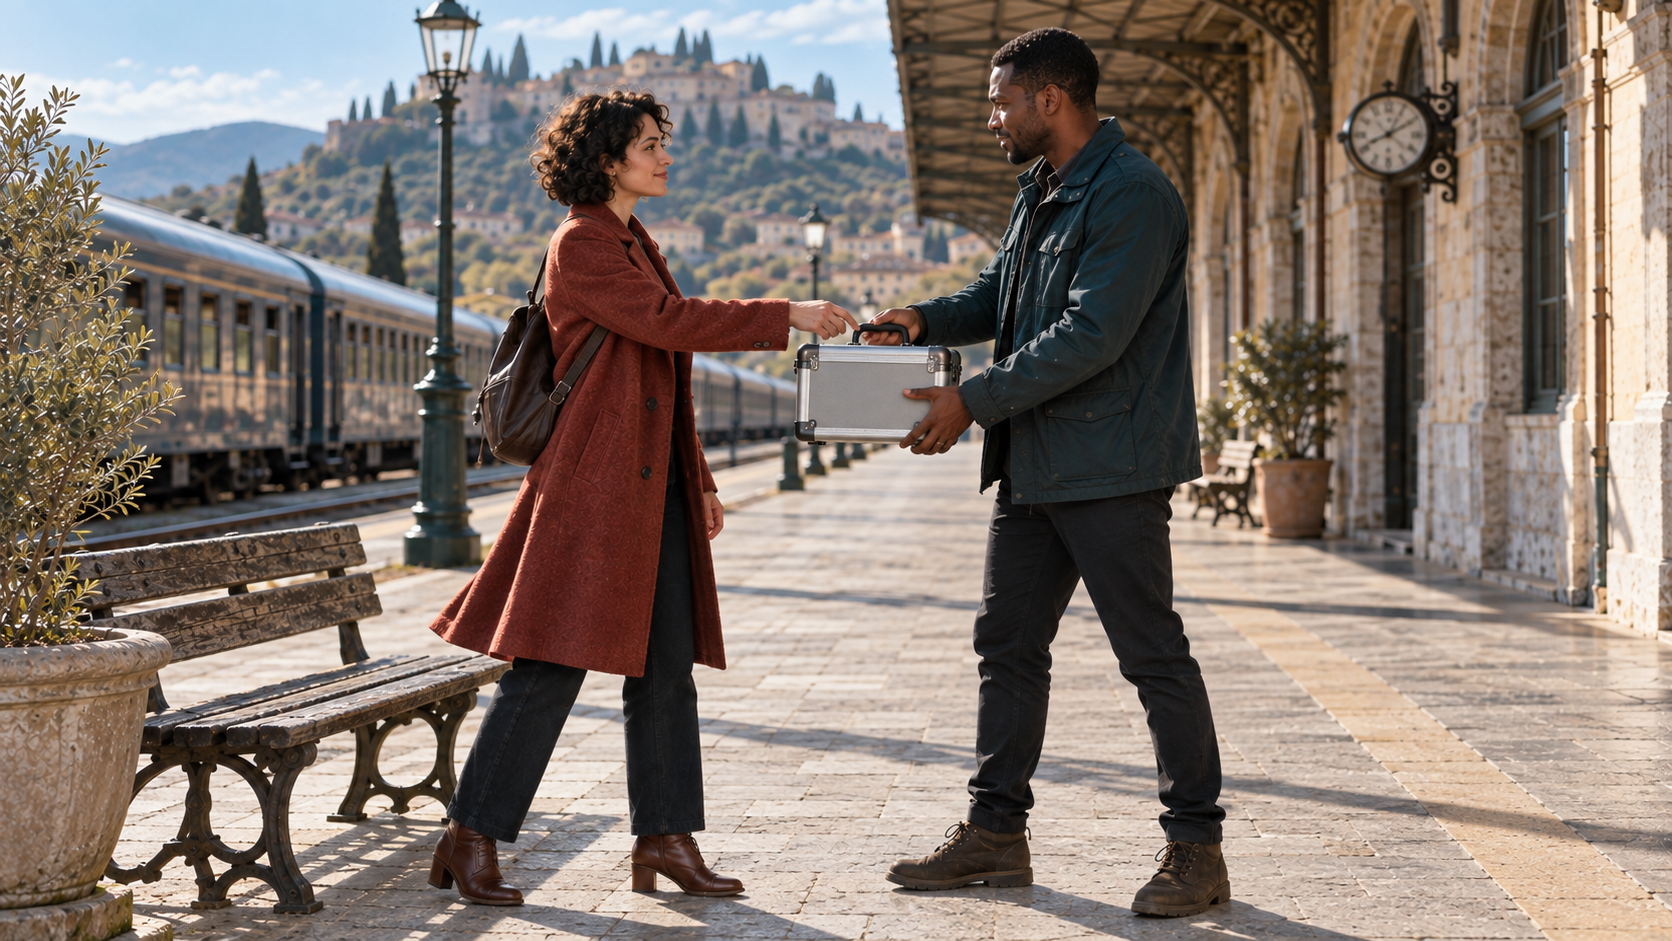
Fotograma de acción generado ilustrativo: revise la separación entre las manos, la geometría del objeto, la continuidad de los abrigos y la ausencia de un brazo adicional durante el contacto compartido.
Controlar el diálogo y el sonido entre dos hablantes
Asigne cada línea y cada beat de escucha
La guía base oficial de MiniMax utiliza identificadores estables de hablante como S1 y S2. Coloque la frase identificativa, el ID del hablante, la entonación y la acción fuera de la etiqueta de diálogo; dentro de ella, incluya únicamente la etiqueta lingüística y el contenido exacto hablado. Cuando ambos hablan simultáneamente, se admite un ID compuesto como S1,S2, pero el diálogo superpuesto constituye una prueba más difícil que las líneas alternadas.
La mujer con el abrigo rojo óxido (S1) mira el maletín y dice en voz baja: <d>[English] Keep this with you until the next stop.</d> Subject 2 escucha y sus labios permanecen cerrados.
El hombre con la chaqueta verde azulada (S2) recibe el maletín, mantiene contacto visual con ella y responde: <d>[English] I understand.</d> Subject 1 escucha y sus labios permanecen cerrados.
Use frases cortas que se ajusten a la toma visible. Especifique cuándo termina el discurso, cuándo se cierra la mandíbula y cuándo reacciona el oyente. Incluya la ambientación del entorno, los pasos, los clics del cierre del maletín y el movimiento de las telas en la paisaje sonoro general, en lugar de repetirlos como parte del diálogo. Coloque la música destinada exclusivamente al público en el campo de música no diegética. Si una voz en off pertenece a una fuente fuera de pantalla, indíquelo explícitamente como tal y mantenga los labios del personaje en pantalla cerrados.
Resultado real de Seedance, no un resultado de MiniMax H3: use un clip controlado con un solo hablante como referencia para los movimientos labiales, la sincronización y el tono ambiental del espacio antes de evaluar un intercambio más complejo entre dos personas.
Para voces recurrentes en varios clips, la guía de coherencia vocal de Seedance ofrece una revisión auditiva centrada en el timbre, el ritmo, la intensidad, el tono ambiental y la separación entre hablantes.
Elaborar un plan de continuidad en tres planos
Que cada corte herede un estado fijado
Tres planos cortos suelen ser suficientes para muchas escenas con dos personas. El plano 1 establece a ambos sujetos, la plataforma y la posesión inicial del maletín. El plano 2 se acerca para la entrega y registra una línea de cada hablante. El plano 3 confirma al nuevo propietario del objeto y otorga a ambos personajes una reacción silenciosa. Asigne a cada plano un estado inicial, una acción, un comportamiento de cámara, un componente sonoro y un estado final fijado.
El final del plano 1 debe coincidir exactamente con el inicio del plano 2. Si el maletín está sobre el banco en el instante del corte, no puede aparecer repentinamente en las manos de Subject 2 en el primer fotograma siguiente sin que se observe su recogida. Si Subject 1 está de pie junto a las vías, no la invierta hacia el muro de la estación a menos que el corte y la orientación de la cámara lo justifiquen explícitamente. La metodología multi-fotograma de MiniMax H3 muestra cómo asignar fotogramas ordenados a una línea temporal maestra sin tratarlos como un collage vertical de viñetas.
La guía base de H3 permite definir tiempos de corte precisos tras el plano 1. Úselos únicamente cuando aporten claridad y mantenga los intervalos continuos. Un plan práctico de 12 segundos podría distribuirse así: 0–4 segundos para el establecimiento, 4–9 segundos para el intercambio y 9–12 segundos para la pausa final. Los últimos dos segundos no deben introducir una acción nueva.
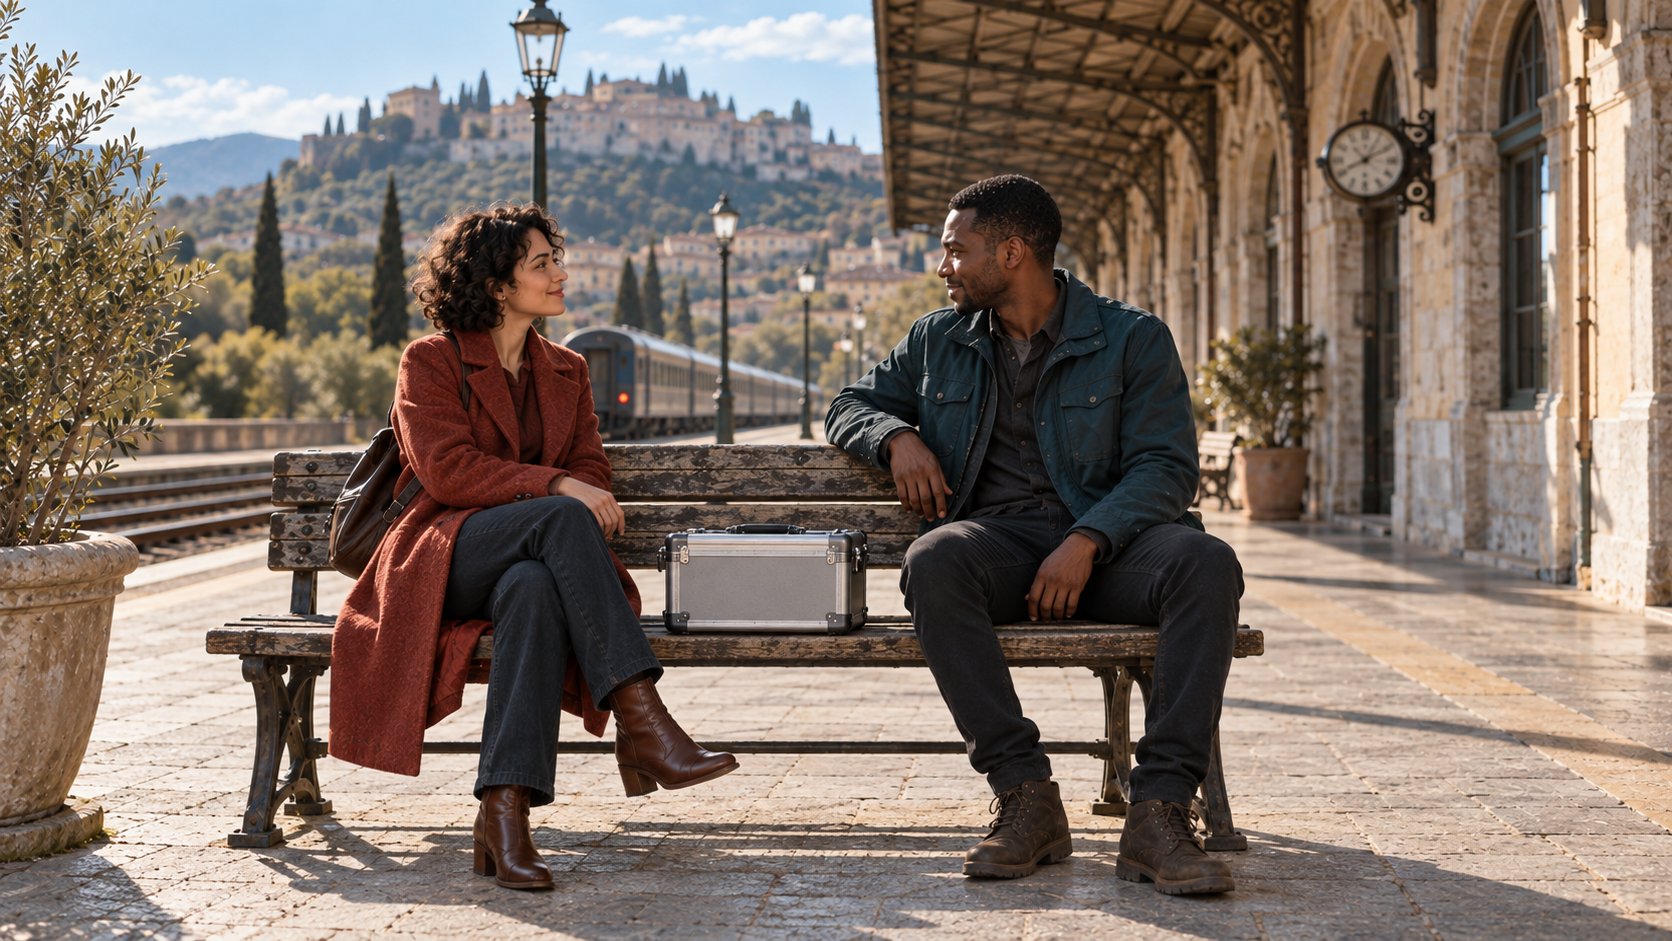
Fotograma final generado ilustrativo: los mismos rostros, abrigos, banco, estación, maletín y luz facilitan la detección de cualquier desviación en la continuidad.
Revisar los fallos y volver a ejecutar la parte más pequeña posible
Relacione cada fallo visible con un único cambio en el prompt
Revise el video completo a velocidad normal y luego examine detalladamente la entrega y el diálogo a media velocidad. Si las identidades se intercambian, refuerce el mapeo entre los sujetos y sus referencias y simplifique el corte. Si los rostros se fusionan en una toma amplia, aumente la separación entre los sujetos o traslade el diálogo a una toma media con ambos personajes; la guía para corregir rostros lejanos aborda opciones de encuadre y selección de referencias específicas para este problema.| Fallo | Causa probable | Cambio más pequeño y útil | | --- | --- | --- | | Los personajes intercambian roles | Vestuario similar o etiquetas ambiguas | Restaurar etiquetas, ropa, posiciones e identificadores de hablante distintos | | Ambas bocas se mueven | El comportamiento del oyente no está especificado | Agregar “escucha, los labios permanecen cerrados” después de cada línea | | Aparece un brazo extra | La transición omite un estado de contacto | Ampliar las fases de soporte compartido y liberación | | El accesorio cambia de forma | Demasiadas acciones o definición débil del accesorio | Bloquear dimensiones, mango, acabado y propietario final | | Las líneas de mirada se rompen tras el corte | Las posiciones no se restablecen | Reafirmar ambas posiciones y la dirección de la mirada en el nuevo ángulo | | El entorno se reinicia | Los anclajes de escena eran implícitos | Repetir plataforma, banco, tren, dirección de la luz y hora |
No regenere una buena toma inicial solo porque un fotograma de transición falle. Guarde las referencias de personaje aceptadas, la versión del prompt, la semilla o el registro de la tarea cuando estén disponibles, la salida y la nota de fallo. Luego, vuelva a ejecutar la toma más pequeña con un único cambio correctivo. Seedance Agent puede organizar esas referencias, comparar candidatos, conservar el estado de aprobación y enviar únicamente el segmento fallido a través de un flujo de trabajo de referencia-a-vídeo.
Conclusión
Un flujo de trabajo fiable para vídeos de dos personas (MiniMax H3) utiliza el modo de entrada adecuado, dos registros de sujetos inequívocos, identificadores estables de hablante (S1 y S2), una interacción causal única, cambios explícitos de estado del accesorio y un plan de cortes cuyos estados finales coincidan con las aperturas siguientes. Revise por separado identidad, propiedad de la boca, manos, líneas de mirada, geometría del accesorio, entorno y sonido; luego, vuelva a ejecutar únicamente el compás fallido. Para mantener juntas las referencias, tomas, aprobaciones y revisiones dirigidas, construya la secuencia de dos personajes con Seedance Agent.
¿Listo para probarlo tú mismo?
Pon en práctica los pasos de esta guía con Seedance y convierte prompts o imágenes en videos pulidos en minutos.
Créditos gratis al registrarte. Planes desde $20/mes.
Artículos relacionados
Más publicaciones en el mismo idioma que quizá quieras leer después.
Guía de acceso anticipado a Socialive Catalyst: Preparación de una primera prueba útil
Aprenda quién puede acceder a Socialive Catalyst, qué incluye la versión beta temprana, qué debe preparar para una demostración y cómo probar un flujo de trabajo de video empresarial con marca.
Leer artículo
FramePack Torch CUDA no habilitado: diagnosticar y solucionar el entorno adecuado
Solucione FramePack cuando Torch no tiene soporte para CUDA mediante la verificación del entorno de ejecución de Python exacto, la sustitución de una wheel exclusiva para CPU, la gestión de compatibilidad con controladores o tarjetas RTX, y la verificación de que la reparación funcionó.
Leer artículo
Tutorial de avatar personal de Google Vids: grabación, indicación y corrección
Cree un avatar personal de Google Vids, complete la captura facial y de voz, redacte una indicación útil de Gemini Omni, corrija el acceso faltante y gestione su grabación.
Leer artículo