
Flujo de trabajo del avatar parlante continuo MiniMax H3: mantener un mismo rostro y voz en todos los clips

AI Overview
¿Puede MiniMax H3 generar un video continuo de un avatar parlante?
Sí, pero un resultado largo debe planificarse como varios fragmentos aprobados, no como una generación indefinida. H3 genera fragmentos de 4 a 15 segundos; por tanto, divida el guion en pausas naturales y combine los segmentos que compartan el mismo rostro, voz, encuadre y tono ambiental.
¿Cómo se mantiene la misma identidad de avatar en cada segmento?
Utilice una única referencia de identidad limpia, repita los mismos rasgos visibles, asigne un identificador de hablante estable —por ejemplo, S1— y comience cada continuación desde un fotograma límite neutro ya aprobado. Cambie únicamente el diálogo y el gesto más pequeño estrictamente necesario.
¿Qué hace que los cortes entre fragmentos de avatares parlantes parezcan imperceptibles?
Finalice cada segmento tras una oración completa, con la boca cerrada, la mirada fija y estable, las manos reposadas y una breve cola de tono ambiental. Inicie el siguiente segmento desde ese mismo estado, y oculte la unión bajo una pausa natural o un corte discreto.
¿Cómo se evita que la sincronización labial se desplace?
Mantenga cada bloque hablado lo suficientemente corto como para una sola respiración, escriba el diálogo exacto dentro de la etiqueta <d> y evite movimientos faciales o de cámara que compitan con el habla. Revise la boca a velocidad normal y fotograma a fotograma antes de aprobar el segmento.
Planifique un avatar parlante continuo como breves segmentos aprobados
Construya la versión final a partir de fragmentos del tamaño de una respiración
El flujo de trabajo para avatares parlantes continuos de MiniMax H3 es un plan de producción, no una solicitud de duración ilimitada. Las herramientas oficiales de H3 aceptan duraciones enteras de 4 a 15 segundos. Trate ese límite como una restricción creativa: cada fragmento debe contener una idea completa, un gesto moderado y un estado final limpio. Una explicación de 45 segundos podría convertirse en cuatro segmentos de 10–13 segundos, en lugar de tres fragmentos forzados al límite máximo.
Marque el guion antes de generar cualquier cosa. Los puntos de corte adecuados siguen la puntuación, una respiración o un cambio de tema. Los puntos de corte inadecuados dividen nombres, números o frases emocionalmente vinculadas. Lea en voz alta cada segmento con un cronómetro y reserve aproximadamente un segundo para el ajuste inicial y la pausa final. Si la línea hablada ya ocupa toda la duración, acorte el texto en lugar de pedirle al modelo que acelere.
| Segmento | Tarea hablada | Acción objetivo | Estado final requerido |
|---|---|---|---|
| A | Presentar el tema | Gestura pequeña con la mano abierta | Boca cerrada, manos descendiendo |
| B | Explicar el punto clave | Un gesto restringido con el índice | Mirada constante, manos sobre la mesa |
| C | Brindar el ejemplo | Asentimiento breve, sin movimiento de cámara | Expresión neutra y tono ambiental |
| D | Transmitir la llamada a la acción (CTA) | Ligero inclinarse, seguido de estabilidad | Pausa de dos tiempos para edición |
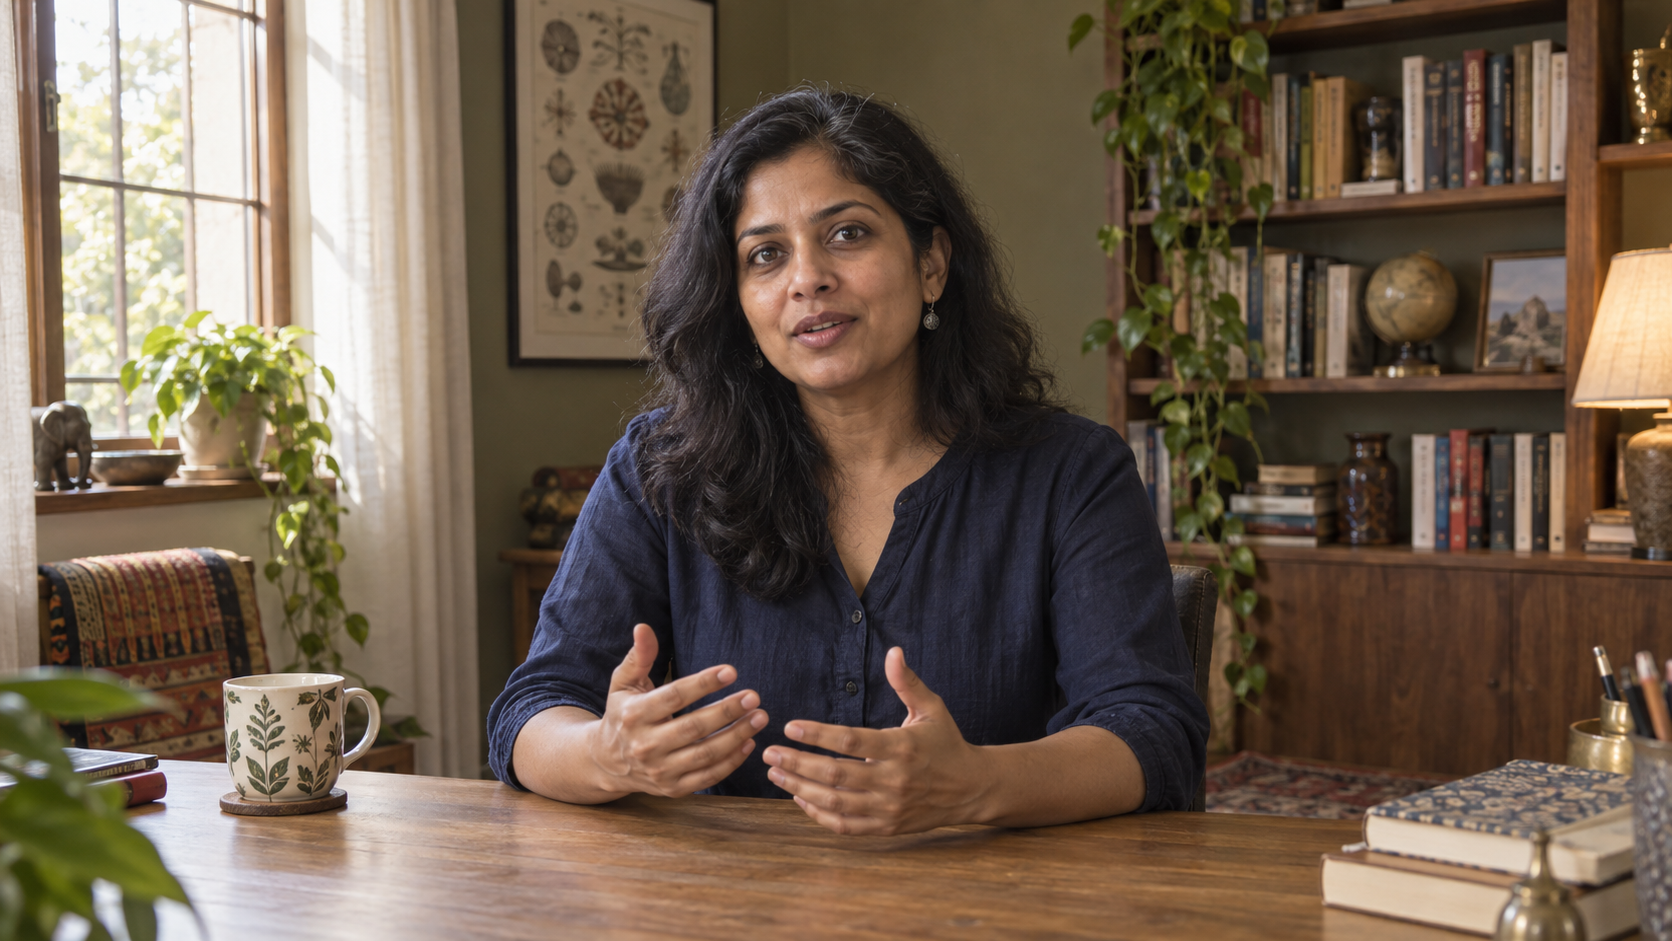
Imagen generada ilustrativa, no un resultado de MiniMax H3: el encuadre medio, las manos visibles, la vestimenta sencilla y el fondo estable aportan más evidencia de continuidad a una secuencia parlante que un retrato cercano de belleza.
Esta segmentación también facilita la recuperación. Si el segmento C presenta una forma labial deficiente, regenérelo únicamente, sin arriesgar el resto del material ya aprobado. La misma lógica de puntos de control del flujo de trabajo multitoma reanudable se aplica aquí: guarde la versión del guion, el conjunto de referencias, el prompt, la salida y el fotograma límite aprobado para cada segmento.
Prepare el rostro, la voz, el guion y el fotograma
Cree un paquete compacto de continuidad
Elija una imagen de referencia con un rostro legible, labios relajados, fondo despejado y el mismo ángulo de cámara requerido para el video final. Un encuadre medio o medio cercano suele ser más seguro que una toma amplia, porque la boca permanece lo suficientemente grande como para inspeccionarla. Mantenga el cabello alejado de los labios, evite que las manos crucen la parte inferior del rostro y use luz direccional suave en lugar de sombras duras y móviles.
Escriba un bloque fijo de identidad y reutilícelo palabra por palabra. Incluya rango de edad, cabello, vestimenta, una característica distintiva pero común, calidad vocal, ritmo de habla, acento solo cuando sea relevante, altura de la cámara, tamaño de la toma, dirección de la luz y anclajes del fondo. No añada nuevos adjetivos en segmentos posteriores; incluso adiciones aparentemente inofensivas pueden alterar el estilo, la edad o las proporciones faciales.
Para la generación guiada por referencias, H3 puede utilizar activos de imagen, video y audio. Su guía oficial completa de referencias distingue entre sujetos visibles, anclajes pictóricos concretos, videos fuente y referencias de audio. Cuando una referencia de audio aporta el carácter vocal más que una señal copiada, descríbala como una referencia de timbre y entrega. Mantenga el mismo identificador de hablante asociado al avatar siempre que esta hable efectivamente.
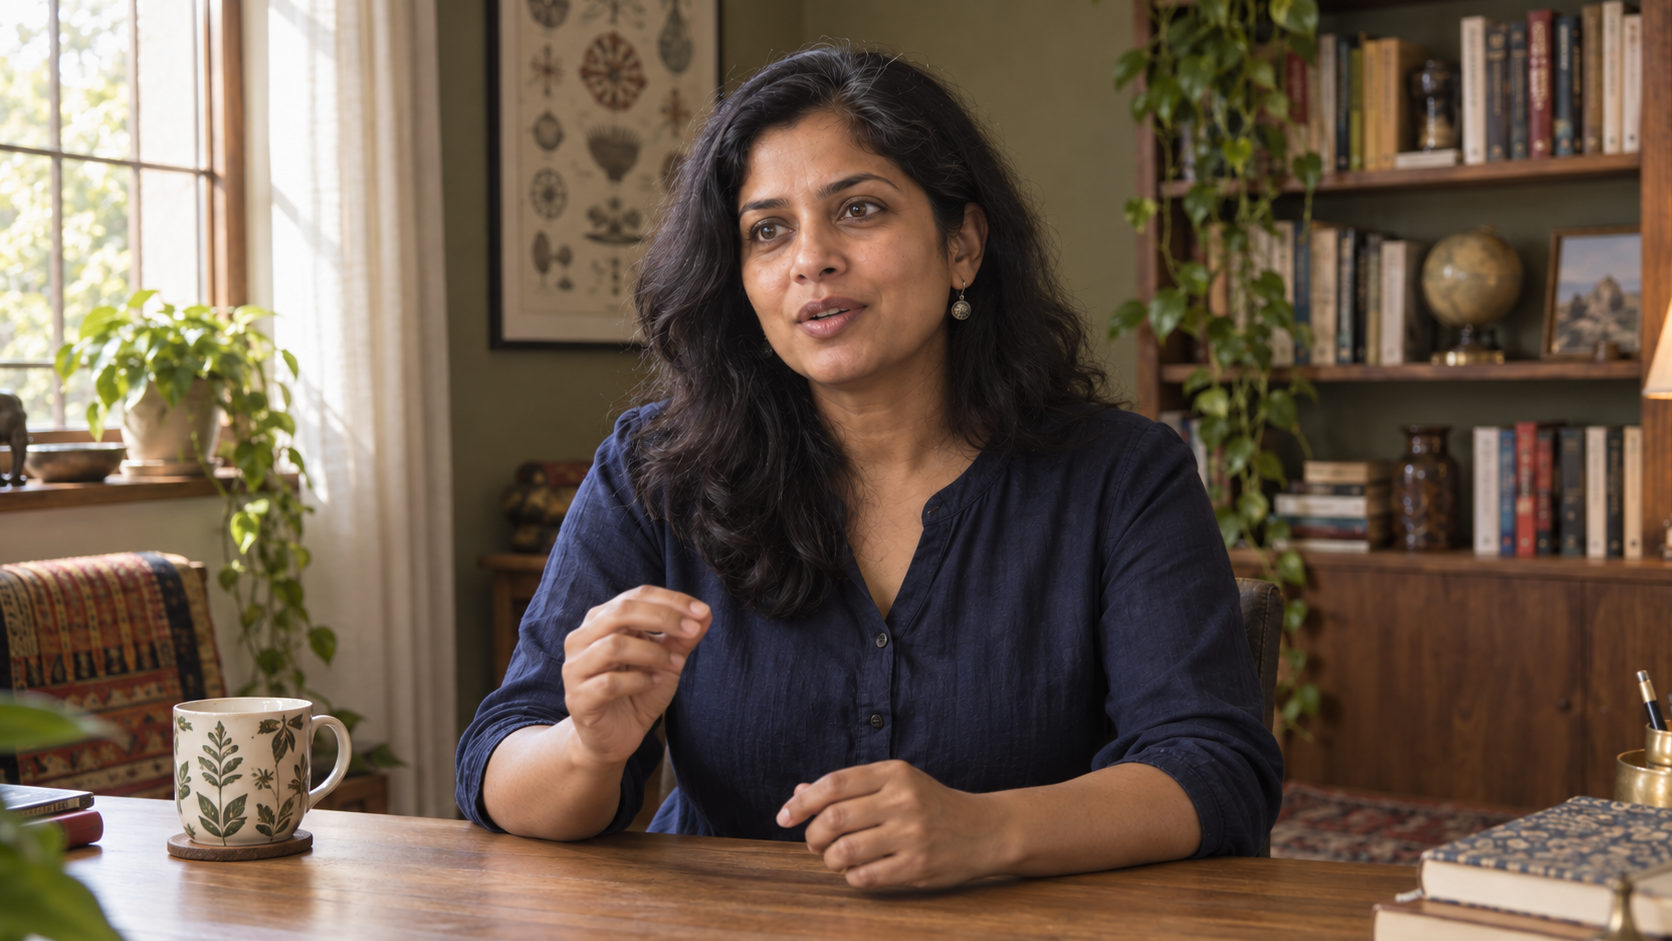
Objetivo de continuidad para un segmento hablado: identidad, lente, mirada, vestimenta y luz permanecen fijas, mientras solo cambian la forma de la boca y un gesto pequeño.
Grabe el diálogo limpio si necesita una voz específica. Use una habitación silenciosa, distancia constante al micrófono, sin música de fondo y archivos separados para cada segmento. Igualar el volumen y el tono ambiental antes de la generación. Si el objetivo es simplemente una voz nativa creíble, especifique un timbre y un ritmo estables, pero mantenga aún así las palabras exactas en el prompt. La guía de coherencia vocal incluye una útil lista de verificación auditiva que también resulta útil al revisar las salidas de H3.
Escriba el diálogo para H3 sin perder la identidad del hablante
Mantenga la dirección visual fuera de la etiqueta de diálogo
La guía oficial base de H3 utiliza identificadores estables de hablante, como (S1), y coloca únicamente las palabras que deben pronunciarse dentro de <d>. La frase identificativa, la acción, la entonación y el identificador del hablante permanecen fuera de la etiqueta. Esa separación evita que las indicaciones de interpretación se conviertan accidentalmente en diálogo.
[Plano 1] Plano medio realista del mismo educador científico sentado ante un escritorio de roble. La cámara, el objetivo, la dirección de la iluminación, la vestimenta, los libros, las plantas y la taza permanecen inalterados. La mujer adulta serena (S1), con voz cálida de registro medio-bajo, ritmo medido y dicción clara, mira justo al lado de la lente. Realiza un pequeño gesto con la mano abierta y dice: <d>[Inglés] Un avatar estable comienza con una transición estable entre cada clip aprobado.</d>. Tras la oración, cierra los labios, vuelve las manos al escritorio y mantiene la misma línea de mirada durante un segundo. El tono ambiental silencioso continúa. Sin música, sin movimiento de cámara ni superposición de texto.
Repita la frase identificativa cuando una nueva generación pudiera, de otro modo, olvidar quién es S1. No cree un nuevo número de hablante para el mismo avatar en el siguiente clip. Si interviene otra voz, asigne S2 una sola vez y mantenga explícitos los roles. En un explicador individual, excluir otras voces audibles elimina una fuente innecesaria de desviación.
Escriba una cláusula hablada por cada acción visible. Giros rápidos de cabeza, movimientos amplios de brazos, acercamientos de cámara y frases largas compiten todos por el mismo breve intervalo. Cuando la precisión bucal es fundamental, mantenga la cámara estática y el torso inmóvil. Utilice los controles prácticos de expresión facial descritos en la guía de prompts de microexpresiones de H3 para solicitar un leve levantamiento de cejas o un asentimiento restringido, sin alterar toda la cara.
Mantenga un estado ancla a lo largo de cada corte
Finalice limpiamente antes de solicitar el siguiente inicio
El último segundo de un clip constituye el «contrato visual» para el siguiente. Solicite un estado final bloqueado: labios juntos, mandíbula relajada, mirada fija en la misma marca, manos en una posición específica, hombros nivelados y objetos de fondo inalterados. Exporte ese final aprobado como imagen ancla para el siguiente clip, siempre que la ruta de generación lo permita. Una pausa neutra resulta más reutilizable que un fotograma capturado en plena emisión de una palabra.
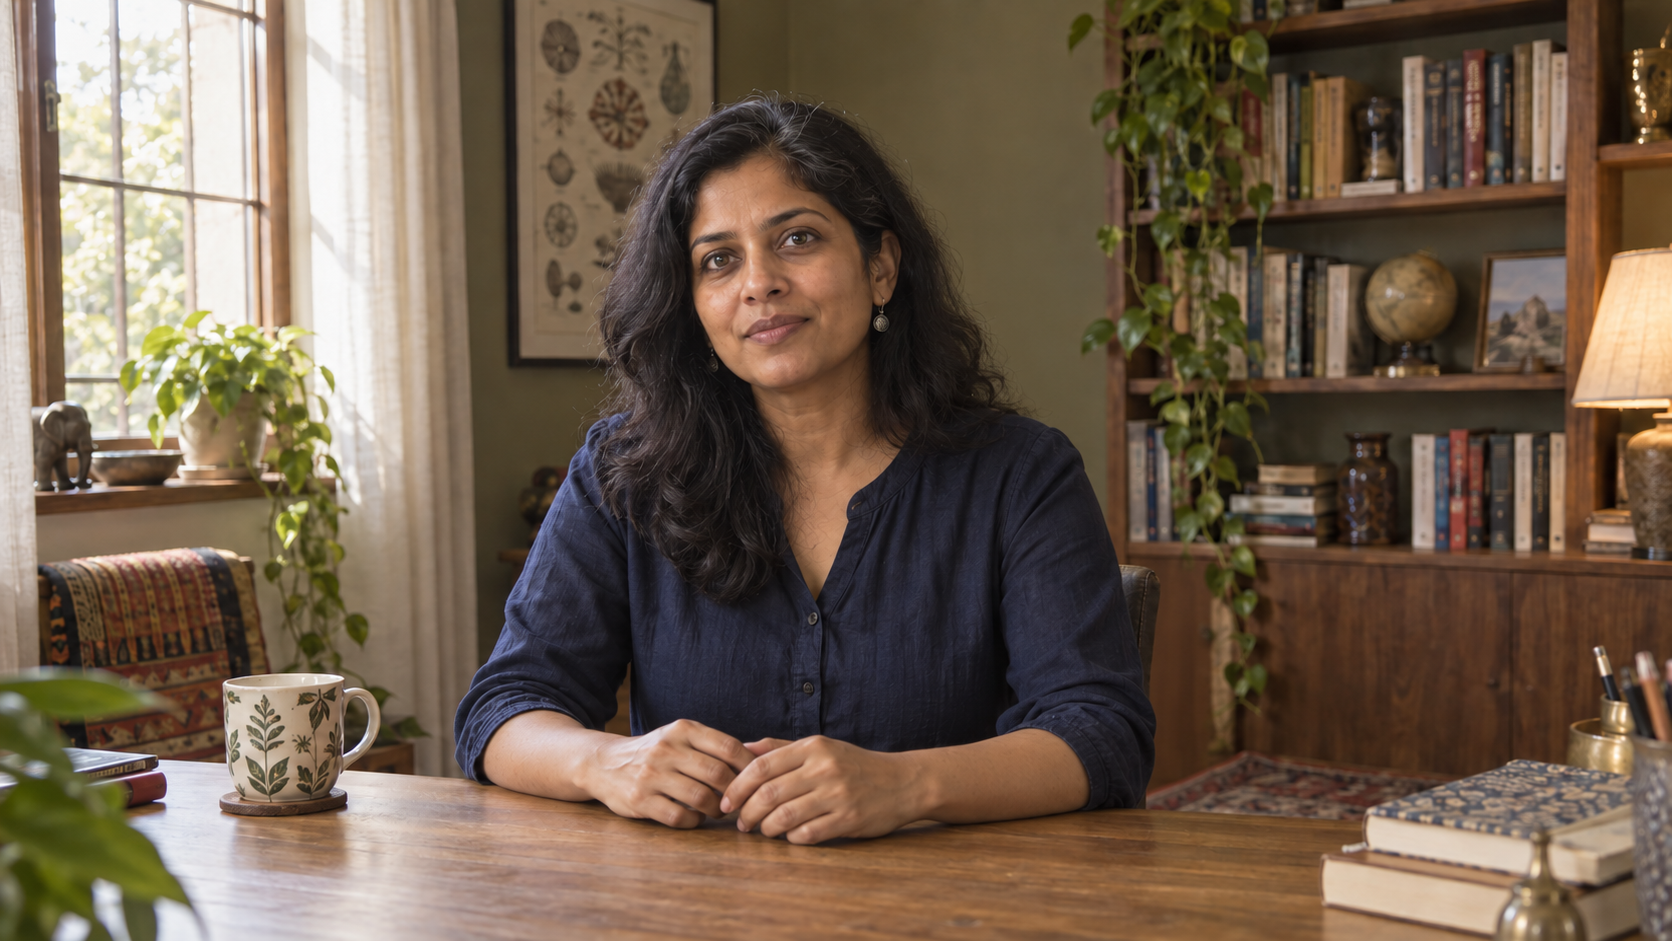
Un fotograma límite útil es intencionalmente poco llamativo: la boca está cerrada, la mirada y la postura están estabilizadas, y ningún gesto debe continuar mágicamente a través del corte.
Al inicio del segmento B, reafirme el estado bloqueado antes de iniciar la nueva acción. Preservar el tamaño de la cabeza, la altura de la cámara, la línea de mirada, la dirección de la iluminación, la posición de las mangas y la ubicación de los objetos de fondo de alto contraste. El primer movimiento debe comenzar tras una breve estabilización, no en el fotograma uno. Si el siguiente clip comienza con una postura distinta, el público percibirá el salto antes de escuchar las palabras.
H3 admite modos de primera/última imagen y de referencia, pero utilice únicamente el modo adecuado para la tarea. Una imagen límite concreta actúa como ancla fotogramétrica; una muestra de audio puede orientar el timbre; un video previo puede aportar contexto de movimiento o continuidad. Más referencias no son automáticamente mejores. Elimine cualquier recurso que contradiga el encuadre, la vestimenta o la voz aprobados.
El método de transición está estrechamente relacionado con la planificación multi-fotograma clave, pero un avatar parlante requiere menos ambiciones visuales. Un ancla estable por cada límite suele ser preferible a un guion gráfico denso que exija cambios simultáneos en la cara, las manos, la cámara y la habitación.
Ensamble los segmentos sin saltos auditivos ni visuales
Corte en una pausa y preserve el tono ambiental
Coloque cada clip aprobado en una única línea de tiempo, en orden de guion. Recorte los fotogramas duplicados de estabilización, pero conserve suficiente material neutro para alejar el corte de una boca abierta. Ajuste escala y posición antes de añadir transiciones. Un corte directo durante una pausa natural suele ser más limpio que una fundida, que puede mostrar brevemente dos bocas y hacer que el rostro parezca inestable.
Resultado real de Seedance, no un resultado de MiniMax H3: use esta muestra nativa de audio como referencia para evaluar la sincronización del habla, el movimiento facial y la continuidad del ambiente.
Escuche las uniones con la imagen oculta. Igualar el volumen del diálogo, el nivel de ruido de fondo, la reverberación y la duración de cada respiración. Coloque una pista continua de tono ambiental bajo la secuencia, para que pequeñas brechas no suenen como si la habitación se apagara repentinamente. Evite la música hasta que el corte vocal funcione correctamente; una banda sonora puede ocultar un mal empalme durante la edición, pero no lo solucionará.
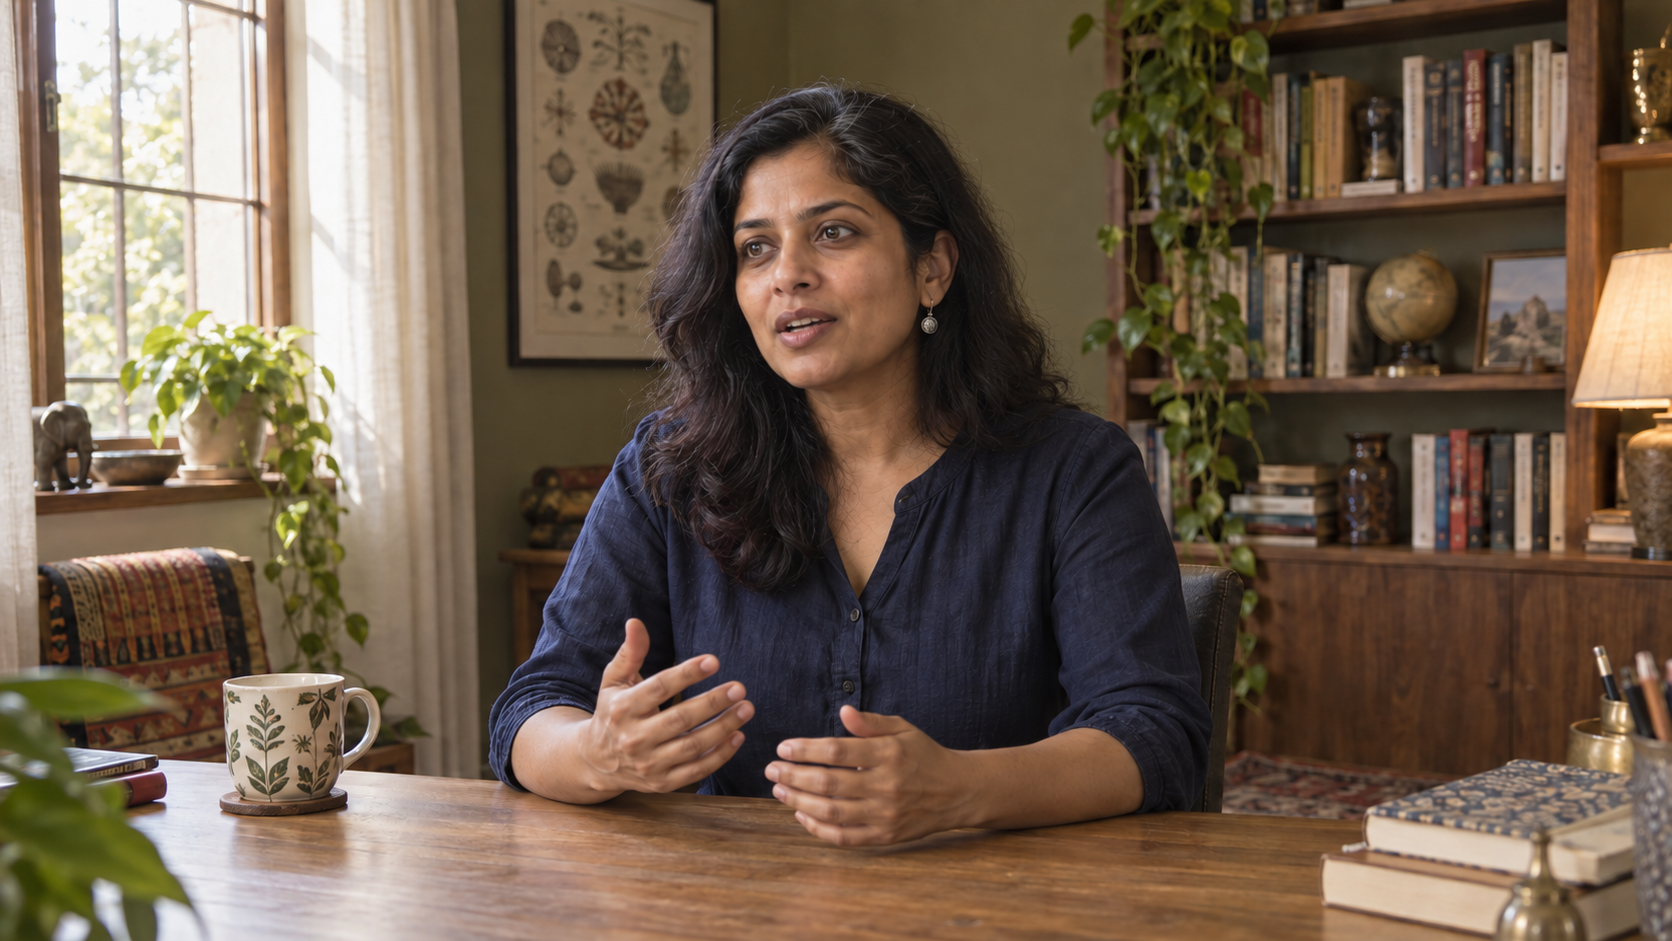
Objetivo de continuidad: la identidad y los anclajes visuales permanecen estables mientras la nueva oración comienza con un gesto de mano ligeramente distinto, aunque aún creíble.
Si persiste un salto, utilice una toma alternativa relevante durante uno o dos segundos: la libreta del orador, un objeto que menciona o una vista más amplia desde la misma habitación. No inserte imágenes de archivo aleatorias. La toma alternativa debe responder o ilustrar la frase hablada y luego regresar al mismo estado del avatar.
Revise fallos de sincronización labial, voz y continuidad
Apruebe cada clip en cinco revisiones independientes
Primero, vea el clip a velocidad normal para captar su significado y ritmo natural. Segundo, mutee el audio e inspeccione la identidad, los dientes, los labios, la mandíbula, los ojos y las manos. Tercero, escuche sin ver, prestando atención al timbre vocal, al ritmo, al tono ambiental (room tone) y a los clics. Cuarto, avance fotograma a fotograma los primeros y últimos doce fotogramas de cada segmento. Quinto, vea la secuencia ensamblada en un reproductor del tamaño de un teléfono, donde los cambios faciales mínimos pueden resultar más evidentes.
Rechace un clip cuando la boca continúe moviéndose tras detenerse la voz, los dientes cambien de forma entre fotogramas, la mandíbula se deslice lateralmente, el color de los ojos varíe, una mano pase a través del rostro o la voz cambie bruscamente de edad o distancia. No intente reparar una identidad rota mediante el uso de nitidez (sharpening). Vuelva a ejecutar únicamente el segmento fallido más pequeño, partiendo desde el último ancla aprobada.
Cuando varios fallos compartan una misma causa, simplifique antes de regenerar. Acorte la línea, elimine un gesto, fije la cámara, amplíe el rostro dentro del encuadre o reemplace una referencia ambigua. Seedance Agent resulta útil en esta etapa porque puede mantener juntos el paquete de referencias, los prompts por segmento, las salidas reales, las notas y los puntos aprobados para volver a ejecutar. Puede comparar los resultados de H3 con un flujo de trabajo controlado de referencia-a-video, en lugar de reconstruir el proyecto a partir de archivos dispersos.
Conclusión
Un avatar parlante continuo MiniMax H3 fiable se ensambla a partir de segmentos cortos de habla, revisables: cronometre el guion, mantenga una única identidad y la definición vocal S1, coloque las palabras exactas dentro de <d>, finalice cada clip sobre un ancla neutra y una los fragmentos aprobados sobre un tono ambiental continuo. Este método no promete generación infinita; ofrece, en cambio, una vía recuperable para construir explicaciones más largas sin sacrificar la coherencia facial, vocal ni la sincronización labial. Para planificar las referencias, los prompts, las salidas, las aprobaciones y las nuevas ejecuciones selectivas dentro de una sola producción, inicie un proyecto de avatar parlante con Seedance Agent.
¿Listo para probarlo tú mismo?
Pon en práctica los pasos de esta guía con Seedance y convierte prompts o imágenes en videos pulidos en minutos.
Créditos gratis al registrarte. Planes desde $20/mes.
Artículos relacionados
Más publicaciones en el mismo idioma que quizá quieras leer después.
Control de la distancia focal de la cámara MiniMax H3: aspectos gran angular, normal y teleobjetivo
Controle el aspecto aparente del objetivo en MiniMax H3 mediante el tamaño de la toma, la distancia de la cámara, el lenguaje de zoom, los fotogramas de referencia y una prueba repetible de indicaciones desde 24 mm hasta 85 mm.
Leer artículo
Flujo de trabajo para video con dos personas en MiniMax H3: mantener claros los roles, el diálogo y el movimiento
Crear una escena con dos personas en MiniMax H3 con etiquetas estables de los sujetos, bloqueo legible, diálogo asignado, transferencias limpias de objetos y un flujo de trabajo práctico para la verificación de fallos.
Leer artículo
Guía de acceso anticipado a Socialive Catalyst: Preparación de una primera prueba útil
Aprenda quién puede acceder a Socialive Catalyst, qué incluye la versión beta temprana, qué debe preparar para una demostración y cómo probar un flujo de trabajo de video empresarial con marca.
Leer artículo