
Cómo hacer que un vídeo generado por IA siga una acción de varios pasos
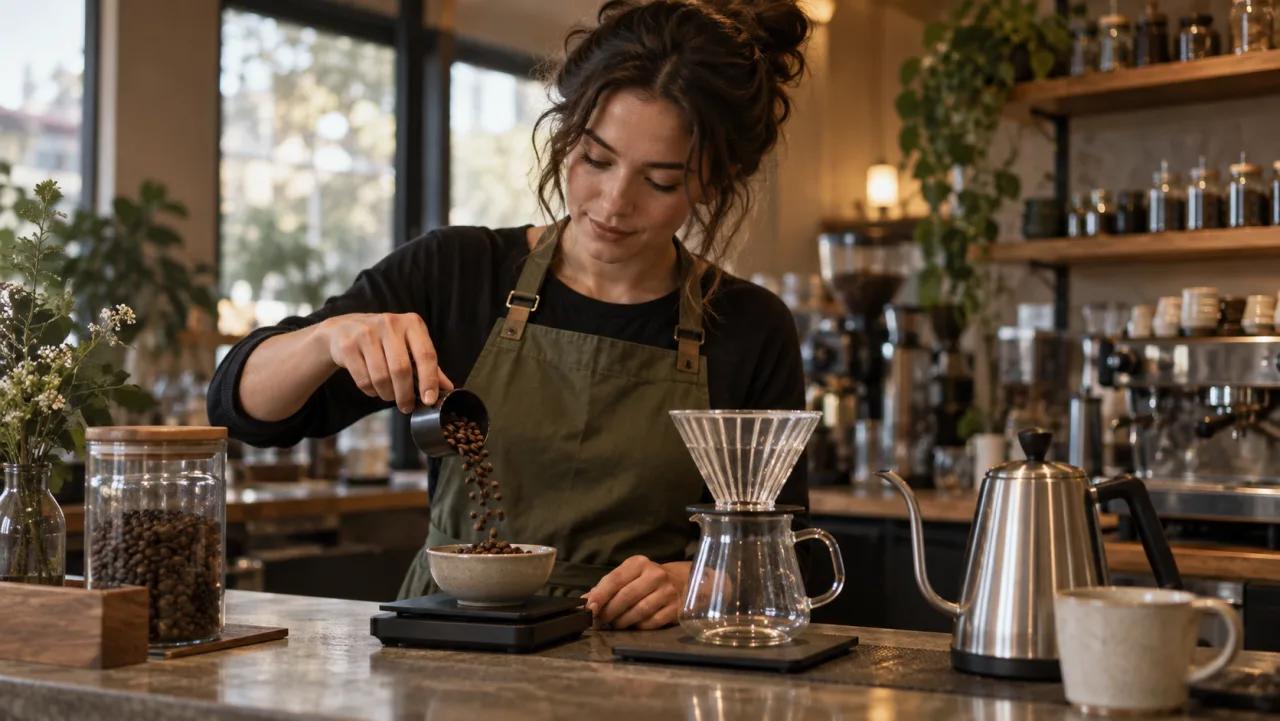
Un vídeo generado por IA suele manejar bien una acción visible, pero pierde la secuencia cuando el prompt solicita cinco pasos. Por ejemplo, el sujeto puede verter agua antes de coger la tetera, un objeto puede «reiniciarse» entre pasos o el clip puede dedicar toda su duración a la pose inicial. La solución fiable consiste en transformar la idea en cambios observables de estado, asignar a cada acción suficiente tiempo en pantalla y dividir la secuencia cuando un solo clip no pueda representarla con claridad.
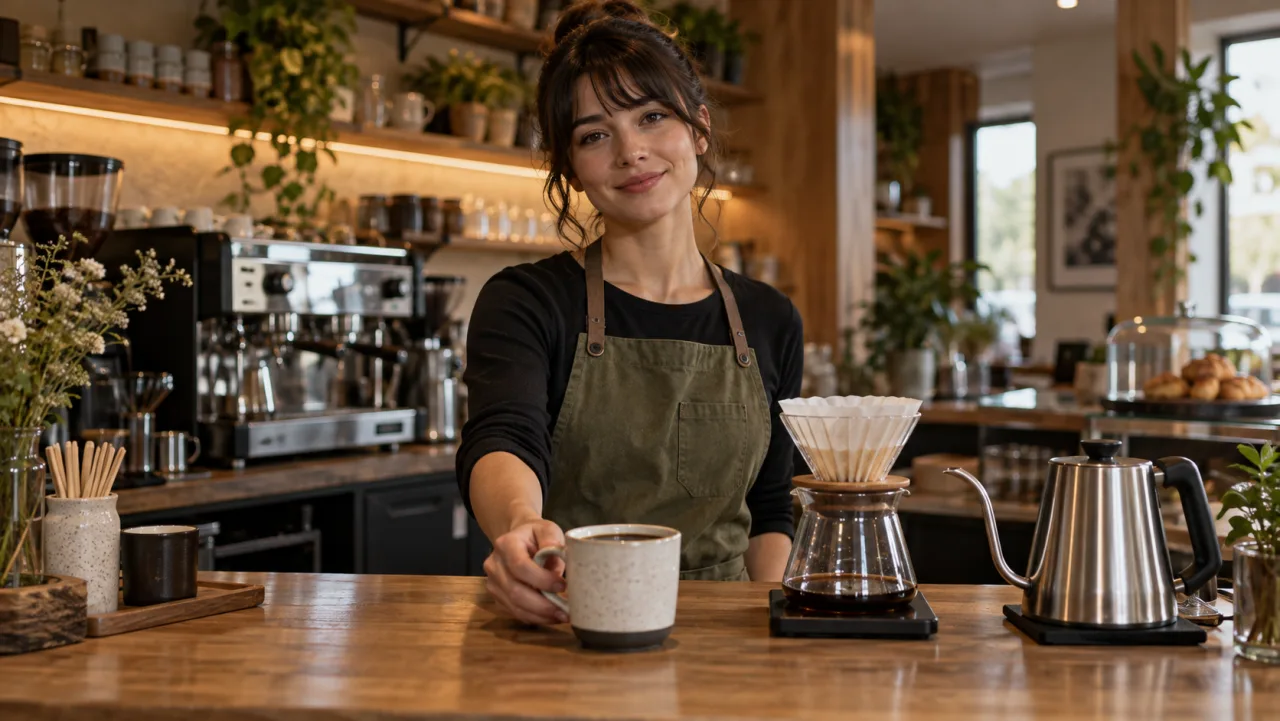
Esta guía explica cómo lograr que un vídeo generado por IA siga una acción de varios pasos sin tratar el prompt como un guion cinematográfico. El ejemplo práctico es un barista que mide los granos de café, vierte agua, retira el filtro y presenta la taza terminada. El mismo método se aplica a demostraciones de montaje, recetas, uso de productos, tutoriales artesanales y secuencias narrativas breves.
AI Overview
¿Cómo hago que un vídeo generado por IA siga los pasos en orden?
Escriba cada paso como una acción física visible, defina el estado antes y después de él, y conecte las acciones mediante palabras explícitas de orden o marcas de tiempo. Mantenga la secuencia lo suficientemente corta para ajustarse a la duración del clip.
¿Debe generarse una acción de varios pasos en un solo clip?
Use un solo clip para dos o tres acciones estrechamente vinculadas que quepan cómodamente. Divida secuencias más largas, delicadas o que impliquen cambios de estado en tomas separadas, llevando hacia adelante el último fotograma aceptado.
¿Por qué omite el modelo la acción intermedia?
Es posible que el prompt contenga demasiadas acciones para los segundos disponibles, o que el estado intermedio sea visualmente ambiguo. Asigne a ese paso una interacción concreta con un objeto, más tiempo y un resultado claro.
¿Cómo puedo mantener coherentes al sujeto y a los objetos?
Fije la imagen de referencia, la vestimenta, los accesorios, la posición de la cámara, la iluminación y el estado inicial. Reutilice un fotograma límite aceptado cuando la siguiente toma deba comenzar exactamente donde terminó la anterior.
Definir pasos atómicos y estados
Comience con un objetivo descrito en lenguaje sencillo y luego redúzcalo a acciones que una cámara pueda captar. «Preparar café» no es un plan de acción; «Ella vierte granos en la molinilla» sí lo es. Evite combinar intención, emoción, movimiento de cámara y varios cambios de objeto en una sola oración. Cada línea debe tener un único actor, un único verbo, un único objeto y un único resultado observable.
Cree una hoja de trabajo de transición de estados antes de redactar el prompt:
| Paso | Estado inicial | Acción visible | Estado final | Bloqueo de continuidad |
|---|---|---|---|---|
| 1 | Granos en la cuchara; molinilla vacía | El barista vierte granos en la molinilla | Cuchara vacía; granos en la molinilla | Mismo delantal, encimera y taza |
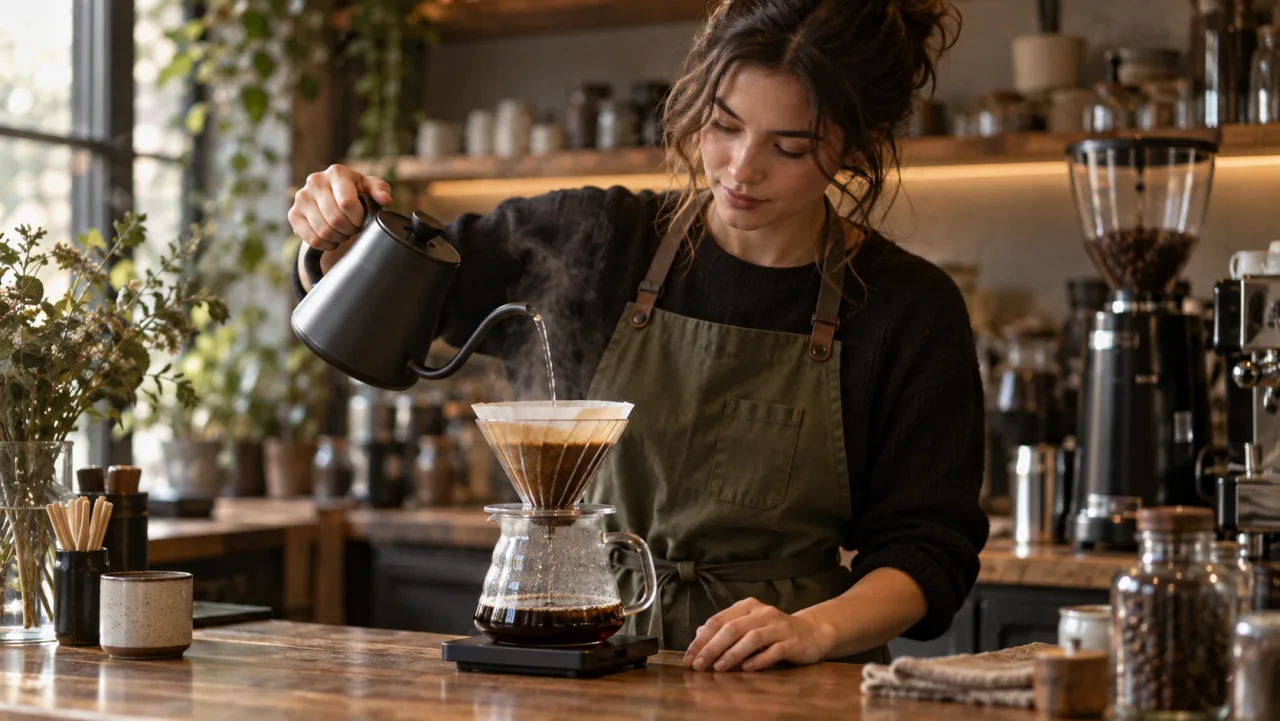
| 2 | Tetera elevada; lecho de café seco | El barista vierte en un círculo lento | Lecho de café en floración | Misma mano, tetera y cámara |
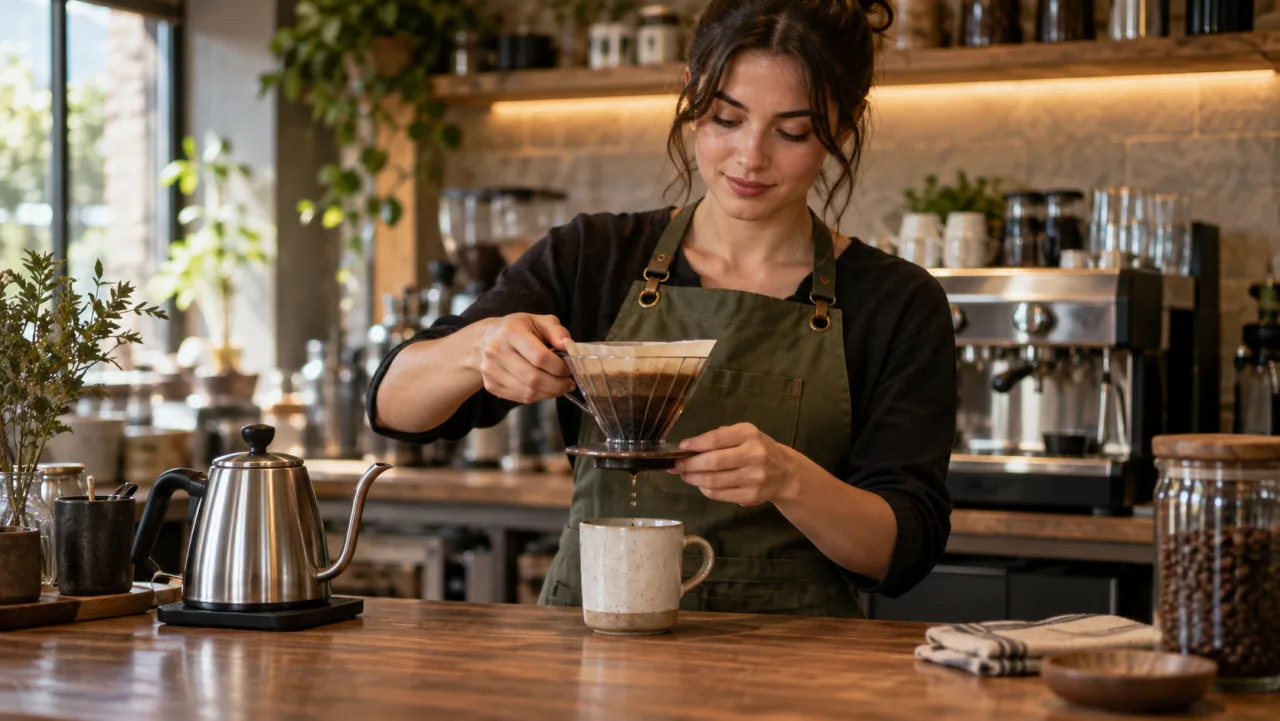
| 3 | Vertido completado; filtro sobre la jarra | El barista deja la tetera y levanta el filtro | Taza lista y llena | Nivel del líquido y posición de los accesorios |
| 4 | Taza sobre la encimera | El barista desliza la taza hacia adelante | Taza terminada presentada | Misma iluminación y fondo |
El estado final importa tanto como la acción: indica al generador qué elementos deben permanecer inalterados al comenzar la siguiente acción. Si un plato, herramienta, prenda o producto cambia de orientación, anote ese resultado. Esta disciplina también mejora un flujo de trabajo simple de texto a vídeo, ya que el prompt describe evidencia tangible, no una intención vaga.
Ajustar las acciones a la duración disponible
Una secuencia falla cuando su «presupuesto de acciones» supera su «presupuesto de tiempo». Reserve tiempo para la anticipación, la ejecución y la estabilización. La mano debe alcanzar la tetera antes de verter; la tetera debe detenerse antes de ser depositada. Estos momentos de transición son breves, pero evitan efectos de «teletransportación».
Para un clip de cinco segundos, proponga una acción principal o dos acciones simples y conectadas. En ocho a diez segundos, pueden funcionar dos o tres acciones si la cámara permanece estable y los objetos siguen siendo fáciles de identificar. Cuatro pasos deliberados suelen requerir varias tomas. Un montaje rápido puede mostrar más eventos, pero no demuestra que se haya completado una acción continua.
Asigne ventanas temporales aproximadas únicamente tras simplificar la secuencia. Por ejemplo: 0–2 segundos, levantar la tetera; 2–6 segundos, verter en un círculo lento; 6–8 segundos, devolver la tetera a la encimera. Deje un estado final de reposo limpio. Las marcas de tiempo exactas son orientativas, no órdenes de edición precisas a nivel de fotograma, así que evalúe el orden visible más que los números.
Si la duración está fija, elimine primero los movimientos decorativos. Una órbita de cámara, vapor flotante, clientes de fondo y movimientos complejos de manos compiten todos por la «capacidad de movimiento». Mantenga la cámara fija en la primera toma exitosa y, una vez consolidado el orden de las acciones, añada un acercamiento moderado.
Construir un prompt de acción secuencial
Describa la escena estable una vez, luego las acciones ordenadas y, por último, las restricciones de cámara y calidad. Esto mantiene el prompt legible y evita que un largo preámbulo estilístico oculte la tarea principal.
Use esta plantilla lista para copiar:
[Sujeto y apariencia fija] en [entorno estable].
Estado inicial: [posiciones de manos, herramientas y objetos].
Primero, [una acción visible y su resultado].
Luego, [una acción visible y su resultado].
Finalmente, [una acción visible y su estado final de reposo].
Las acciones ocurren exactamente en este orden, con contacto natural de las manos y sin reinicios de objetos.
[Encuadre y movimiento de la cámara]. [Iluminación y estilo visual].
```Para la toma del café: «Una barista con un delantal verde oliva está detrás de una barra de madera para café. Estado inicial: su mano derecha sostiene una jarra de pico de cisne sobre un lecho seco de café. Primero, comienza un vertido circular lento. Luego, el café florece mientras ella continúa el círculo controlado. Finalmente, detiene el vertido y coloca la jarra sobre la encimera. Las acciones ocurren exactamente en este orden. Toma media fija, luz natural cálida proveniente de una ventana».
Las descripciones positivas suelen funcionar mejor que una larga lista de prohibiciones. Indique «la taza permanece en el lado izquierdo de la jarra» en lugar de depender únicamente de «no mueva la taza». Si la composición inicial es importante, comience con [image-to-video](/es/image-to-video) y seleccione una referencia que ya contenga todos los elementos esenciales.
## Generar una sola toma o dividir en clips
Genere una única toma cuando el mismo sujeto realice una acción continua en un solo lugar y la cámara pueda observar todos los resultados. Divida la secuencia cuando un objeto se transforme, el sujeto cambie de posición, ingrese una nueva herramienta o un paso desaparezca repetidamente.
Una regla práctica de decisión es sencilla: si no puede describir la secuencia con tres verbos y una imagen inicial estable, use más de una toma. La toma uno puede finalizar con la jarra reposando sobre la encimera. La toma dos comienza desde ese fotograma final aceptado y muestra la retirada del filtro. Esto asigna a cada generación una tarea más pequeña, manteniendo al mismo tiempo la apariencia de un flujo de trabajo único.
No siga regenerando una indicación sobrecargada. Tras dos o tres fallos con el mismo paso omitido, acorte la unidad. El [tutorial de Pika sobre múltiples fotogramas clave](/es/blog/pika-multiple-keyframe-video-tutorial) resulta útil cuando una herramienta admite puntos de referencia visuales explícitos. Para un control más amplio de identidad y entorno, utilice los métodos descritos en la [guía de consistencia para vídeos generados por IA](/es/blog/best-ai-video-generator-for-consistency).
## Mantener la continuidad entre pasos
El límite entre clips es donde suelen fallar los flujos de trabajo de varios pasos. Guarde el último fotograma únicamente tras asegurarse de que las manos, los objetos y el sujeto estén en un estado neutro y legible. Un fotograma con desenfoque por movimiento, una herramienta parcialmente oculta o dedos cruzando un objeto dará al siguiente paso una geometría incierta.
Lleve cinco «bloqueos» a la siguiente toma: identidad del sujeto, vestimenta, objeto principal, entorno y dirección de la cámara. Asimismo, indique qué variable se permite que cambie. En el ejemplo del café, el nivel del líquido puede subir, pero el diseño de la taza, el delantal, la encimera y la dirección de la luz deben permanecer fijos.
Al usar un fotograma límite, descríbalo como estado inicial en lugar de repetir toda la acción anterior. El siguiente prompt debe decir: «La jarra reposa en el lado derecho de la encimera y el filtro lleno sigue situado sobre la jarra. La barista levanta el filtro verticalmente hacia arriba». Volver a reproducir el vertido invita al modelo a reiniciarlo.
Este ejemplo real de Seedance se incluye como referencia de movimiento independiente para evaluar el contacto, la estabilidad de la cámara y el asentamiento. No constituye evidencia de que esta secuencia exacta de café se haya generado en una sola pasada.
```official-video
src=https://r2.seedance.tv/blog/runway-failed-generation-credits-refund/seedance-coffee-motion-control-v1.mp4
poster=https://r2.seedance.tv/blog/runway-failed-generation-credits-refund/seedance-coffee-motion-control-poster-v1.jpg
label=Seedance motion-control reference for action review
Revisar y reparar la secuencia
Vea primero a velocidad normal. Confirme que las acciones ocurran en orden y que cada una produzca su estado requerido. Luego, examine fotograma por fotograma las zonas de contacto manual y los límites entre tomas. Una toma hermosa aún fracasa si la tapa se abre antes de que la mano la toque o un recipiente lleno se vacíe.
Use una lista compacta de verificación para aceptación:
- Cada acción requerida aparece una vez y en orden.
- Los estados inicial y final son visualmente legibles.
- Las manos contactan el objeto previsto sin fusionarse ni cambiar de lado.
- Los objetos no desaparecen, se duplican, se reinician ni cambian de diseño.
- La dirección de la cámara y la posición del sujeto en pantalla permanecen constantes.
- El fotograma final puede servir como punto limpio de traspaso o edición.
Repare la unidad defectuosa más pequeña. Si falta el paso dos, asígnele más tiempo o aíslelo en una nueva toma. Si la identidad se desvía, refuerce la referencia y reduzca el movimiento de la cámara. Si el objeto se transforma, elija un fotograma límite más claro y reafirme su geometría. Si la transición parece brusca, añada una pose de asentamiento de medio segundo en lugar de regenerar toda la secuencia.
Seedance Agent resulta útil cuando la tarea requiere varias generaciones: puede mantener juntos la hoja de estado, las referencias, el orden de las tomas, las notas de revisión y las regeneraciones dirigidas. Así, la aprobación se centra en transiciones observables, no en preguntar si un clip atractivo «se siente bien».
Conclusión
Para hacer que un vídeo generado por IA siga una acción de varios pasos, convierta la idea en verbos atómicos, defina cada estado inicial y final, distribuya las acciones según la duración del clip y divida la secuencia antes de que se sobrecargue. Preservar la continuidad mediante fotogramas límite limpios, bloqueos visuales estables y una lista de verificación de revisión que evalúe el orden —y no solo el estilo—. Cuando esté listo para planificar, generar, comparar y reparar una cadena de acciones más larga, construya el flujo de trabajo en Seedance Agent.
¿Listo para probarlo tú mismo?
Pon en práctica los pasos de esta guía con Seedance y convierte prompts o imágenes en videos pulidos en minutos.
Créditos gratis al registrarte. Planes desde $28/mes.
Artículos relacionados
Más publicaciones en el mismo idioma que quizá quieras leer después.
Editar video con texto en Pictory: recortar una grabación a partir de su transcripción
Sube una grabación a Pictory, verifica su transcripción, elimina texto para recortar el video, corrige cortes bruscos y subtítulos, añade imágenes B-roll y exporta una versión final limpia.
Leer artículo
Tutorial en video sobre el Cambiador de Voz de ElevenLabs: Reemplazar una voz y conservar la interpretación
Transforme el diálogo de un video con el Cambiador de Voz de ElevenLabs, conserve la emoción y la sincronización temporal, restaure la sincronización labial, solucione artefactos y finalice una mezcla coherente.
Leer artículo
Runway Aleph Green Screen: Crear un sujeto con capacidad de máscara y una placa limpia
Convierte metraje normal en un recurso de pantalla verde mediante Runway Aleph 2.0, escribe un prompt preciso, aplica la máscara cromática al resultado, corrige problemas en los bordes y crea una placa limpia.
Leer artículo