
Google Ads 将品牌套件(Brand Kits)设为 AI 输入项——于是我们用一个品牌套件测试了视频智能体(Video Agent)
AI 概览
Google 发生了什么变化?
这并非 Google 搜索排名算法更新。而是 Google Ads 内部一项创意制作层面的变更:Asset Studio 中的 Gemini Omni 现在可导入品牌规范与网址,生成视频创意方案,通过提示词细化分镜,并导出多种广告格式。
我们测试了什么?
我们为一个虚构的气泡水品牌向 Video Agent 提供三项资产:一张产品实物图、一枚透明背景 Logo,以及一份品牌规范板。它据此生成了一条 8 秒竖版产品广告;随后,我们仅修改一条提示词,构建了受控的 B 版本。
哪个版本胜出?
A 版本通过了我们的编辑审核。它完整保留了易拉罐主体、Logo、钴蓝与明黄色配色方案,且包装信息层级更清晰易读。B 版本增加了明确的安全区(safe-zone)指令,但这些额外指令并未提升最终构图质量。
实际经验教训是什么?
请将生成环节用于产品动态、光影效果、水果元素、气泡细节与镜头运动;而将确定性更强的后期编辑层(deterministic editing layer)用于像素级精准控制的 CTA、价格、法律声明及最终 Logo 定位。提示词文本越多,并不自动等同于更高控制力。
快速摘要:Video Agent 品牌套件测试一瞥
时间紧张?该智能体成功将三项彼此独立的品牌资产转化为一次受控的产品视频测试。A 版本是更优源素材(source clip);B 版本则证实:数值化布局指令不应被视作绝对可靠的定位保障。
| 维度 | A 版本 | B 版本 |
|---|---|---|
| 核心方法 | 锁定产品与包装,采用定性间距描述 | 在相同锁定基础上,增加居中包装安全区与底部 18% CTA 区域 |
| 产品锚点 | 以同一张产品实物图为第一帧 | 以同一张产品实物图为第一帧 |
| 易拉罐标识与配色 | 稳定且已选定 | 整体稳定 |
| 包装可读性 | 更一致地保持可读 | 水果与水体元素干扰了居中/底部标签文字的辨识度 |
| CTA 行为 | 出现时间稍晚;可读性强,但对比度尚有提升空间 | 出现在包装信息附近,而非停留在预设区域中 |
| 生成设置 | 9:16,720 × 1280,8.042 秒,H.264,音频关闭 | 设置完全相同 |
| 成本依据 | 审批卡片显示消耗 19 个积分 | 审批卡片显示消耗 19 个积分;实际扣费亦为 19 |
| 编辑决策 | 用作源素材(source clip) | 作为学习型变体保留;不发布上线 |
Google Ads 实际做出的变更
Google 当前发布的 Google Ads 中 Gemini Omni 的公告 描述了一个四步工作流:导入品牌规范与网址 → 基于提示词或静态资产生成创意方案 → 细化分镜、配音、节奏与画幅比例 → 将素材导出至 Google 与 YouTube 广告系列。Google 同时表示,该功能正面向全球免费上线,内置于 Google Ads 中。
真正关键的转变,并非又出现一款视频模型。品牌输入正成为生成工作流的组成部分。 营销人员面临的问题,因此从“AI 能否生成一段视频?”转变为三个更难的问题:
- 系统能否识别哪项资产才是真实性的源头(source of truth)?
- 它能否在添加动态效果的同时,保全包装结构与品牌识别?
- 它能否在不同时变动五个变量的前提下,完成变体测试?
这些问题既是智能体(Agent)层面的挑战,也是模型(model)层面的挑战。模型质量与生产工作流之间的这种区分,在我们的 Seedance 2.0 与 Higgsfield 对比分析 中同样可见。本次,我们选择用一个小规模品牌套件测试该工作流,而非评估一段精修的演示样片(demo reel)。
我们提供给 Video Agent 的内容
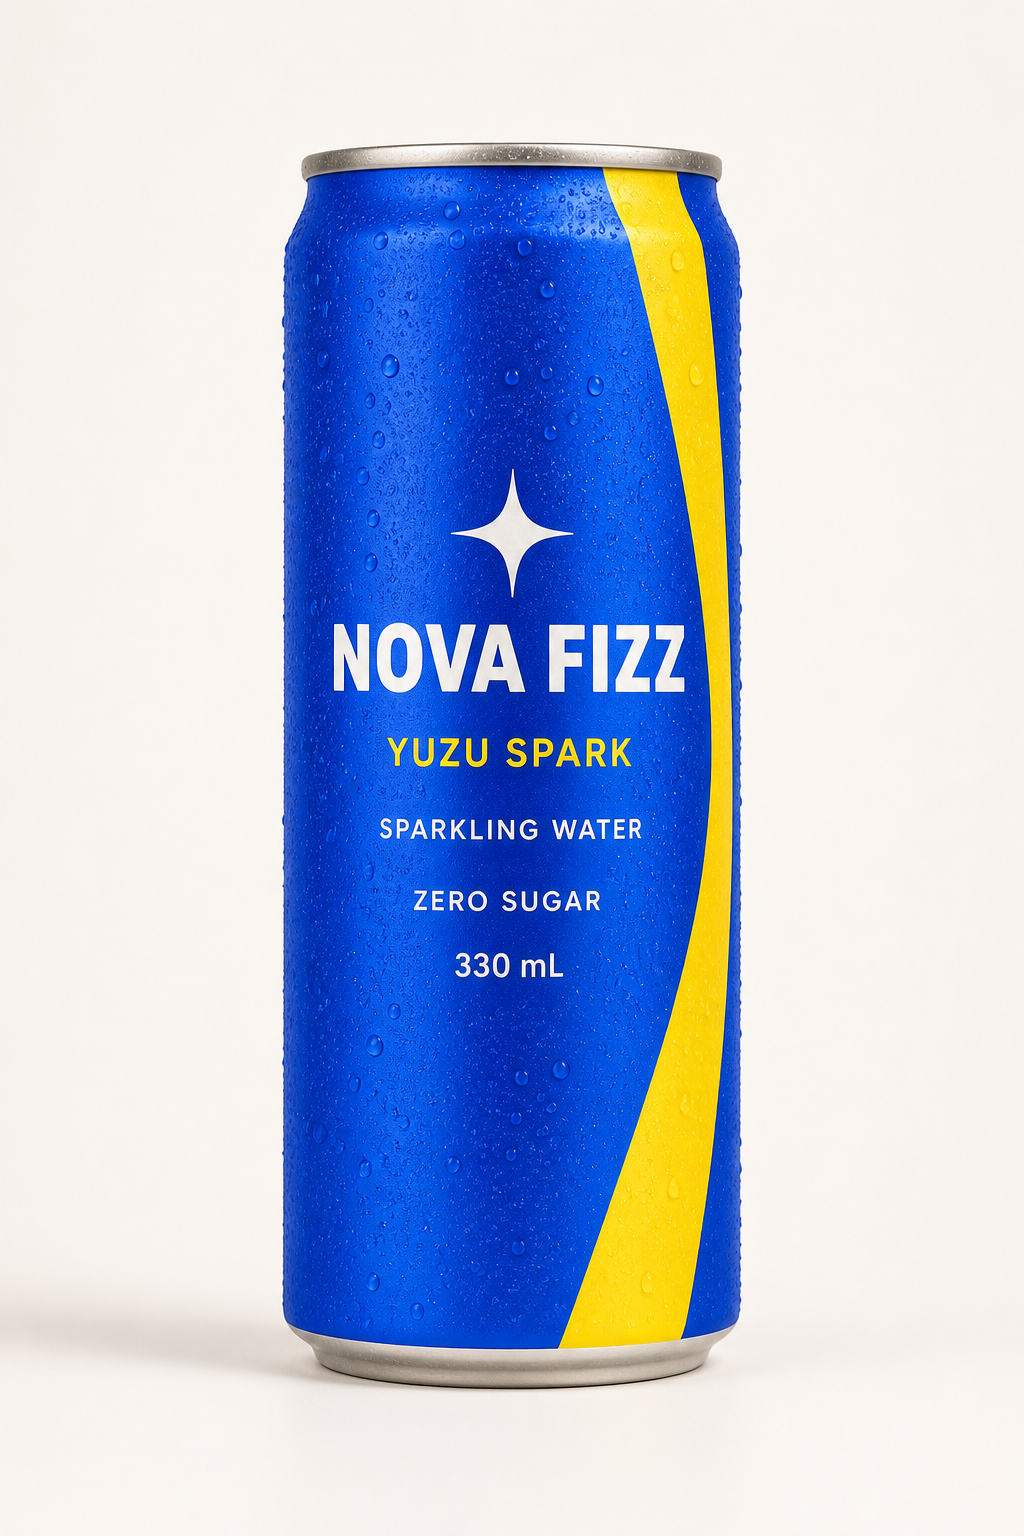
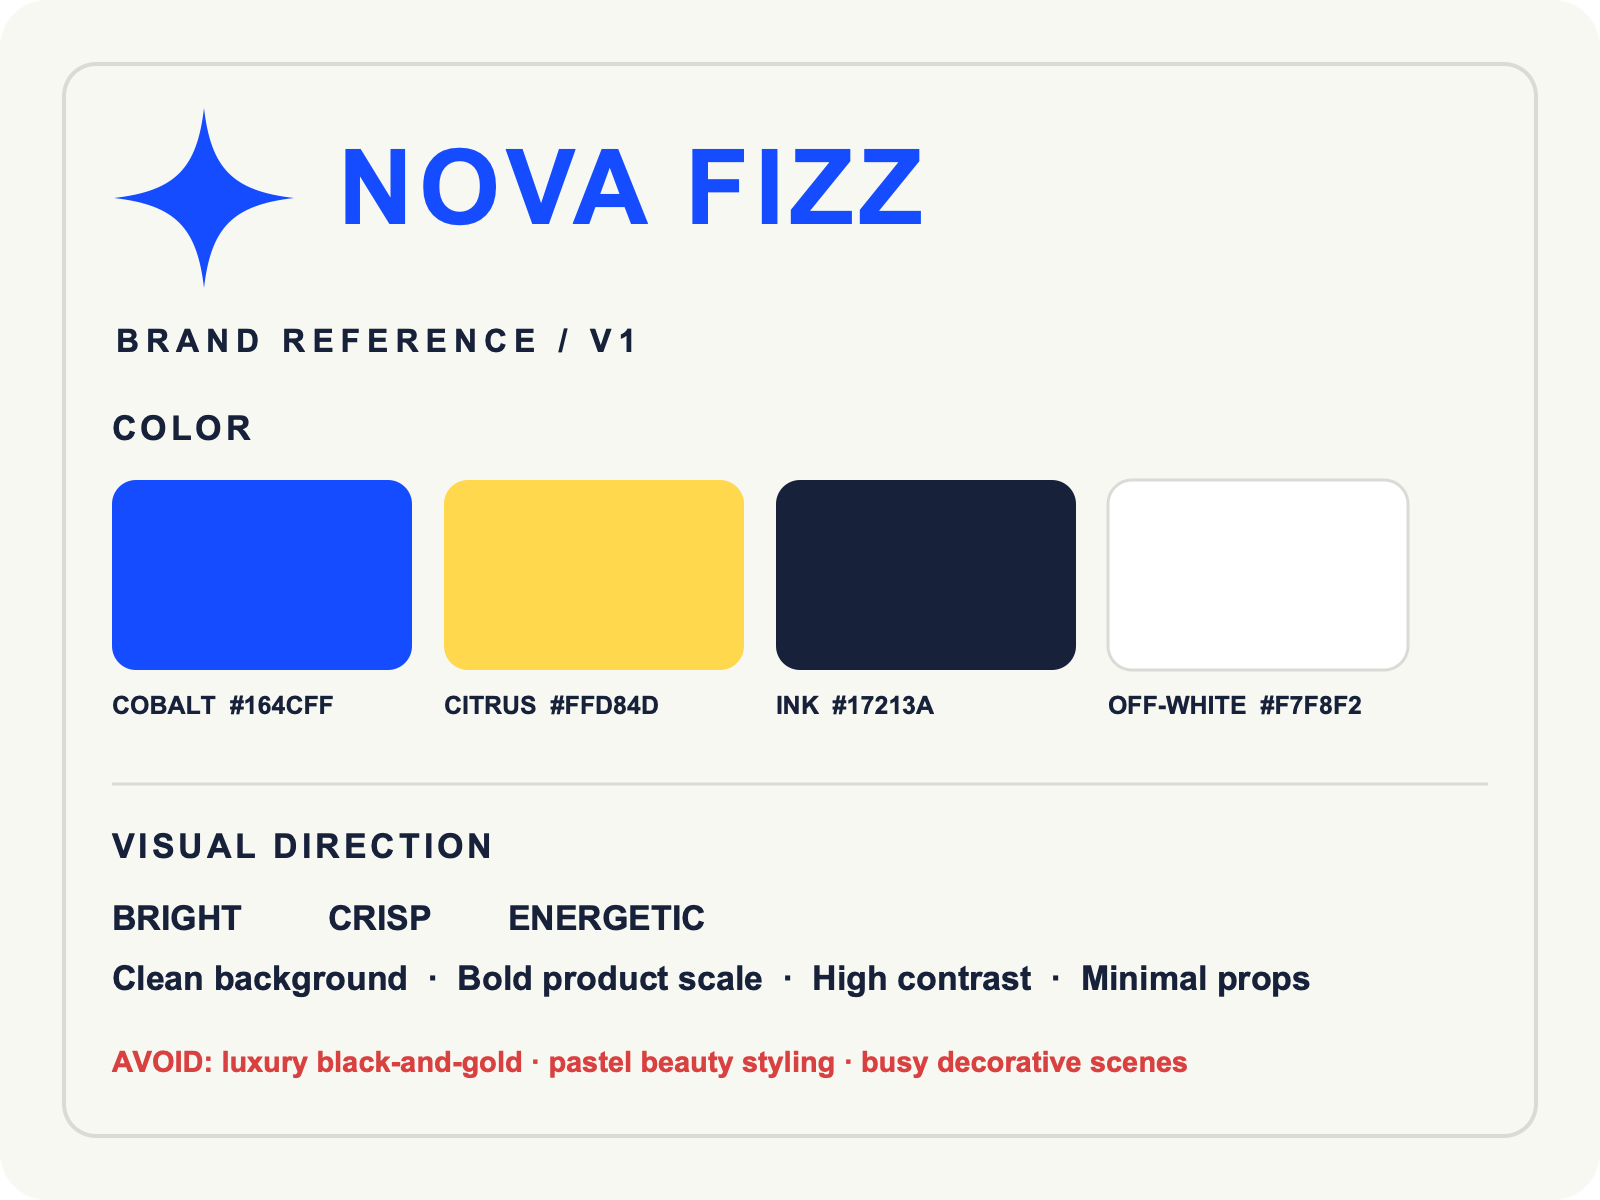
该虚构产品名为 NOVA FIZZ Yuzu Spark,是一款钴蓝色气泡水易拉罐,罐身带有明黄色对角曲线与一枚白色四芒星。我们刻意选用含多行文字的包装设计,因为标签保真度能快速暴露一个工作流是否真正具备品牌意识(brand-aware)。
| 资产 | 在工作流中的作用 | 不得发生偏移的内容 |
|---|---|---|
| 产品实物图 | 产品身份标识与首帧锚点 | 易拉罐外形、标签层级、文字、色彩、冷凝水效果 |
| 透明背景 Logo | 拼写与符号参考 | NOVA FIZZ、四芒星、比例关系 |
| 品牌规范板 | 美术指导 | 钴蓝色、柑橘黄、米白色、明亮/锐利/活力的调性 |
品牌规范板应指导美术方向,但当模型判断真实包装外观时,它不应凌驾于产品实拍图之上。
Video Agent 实际执行的操作
工作流中最有力的部分,发生在付费调用之前。
首先,该智能体将各项资产转化为一套品牌锁定(brand locks)层级结构:产品实拍图成为包装真实性来源;Logo 固定了拼写与符号形状;品牌规范板提供了色彩与视觉调性。
其次,它逐字转录了包装上所有可见文字:
NOVA FIZZYUZU SPARKSPARKLING WATERZERO SUGAR330 mL
第三,它选定产品实物图为第一帧。要求视频模型为真实包装添加动画,远比要求它仅凭文字描述重绘该包装更稳妥。最后,它将一个宽泛的请求——“制作一则明亮的垂直产品广告”——转化为一个可直接交付审批的生成结果,其中明确指定了时长、分辨率、宽高比、音频设置、行动号召(CTA)、镜头运镜方向,以及禁止修改项。我们关闭了音频以聚焦视觉一致性;若广告活动在生成阶段需要配音,则可参考当前支持原生音频的 AI 视频生成器对比。
该可复用的提示词结构如下:
PRODUCT LOCK
以首帧中的产品为唯一且精确的主体。保持易拉罐外形、四点星标、钴蓝色罐身、黄色对角弧线,以及所有包装文字线条完全不变:“NOVA FIZZ”、“YUZU SPARK”、“SPARKLING WATER”、“ZERO SUGAR”、“330 mL”。仅允许出现一罐产品,不得复制。

CHANGE CHANNEL
使用固定机位,仅执行一次轻柔的推近镜头。添加新鲜柚子切片、细腻气泡,以及一道干净向上的水花弧线,环绕易拉罐流动。

BRAND DIRECTION
纯白偏灰背景。明亮、锐利、富有活力。高对比度,极简道具。禁用黑金奢华风格、粉彩色系风格,或繁复装饰性布景。

CTA
在画面底部附近显示 “Taste the bright side.”,字体为简洁无衬线体,不得遮挡产品。

NEGATIVE LOCKS
禁止修改包装文字、虚构品牌元素、形变、融合、闪烁、水印、额外 Logo 或重复易拉罐。
真正有价值之处,并非提示词的长度,而在于其优先级顺序:身份识别第一,唯一允许的运动系统第二,艺术指导第三,负面约束最后。
正面对决:品牌保真度与包装呈现
完成 A 版本评审后,我们在同一 Canvas 中、使用相同的产品图像、模型路径、分辨率、时长、宽高比、音频设置、镜头运动及 CTA,生成了 B 版本。唯一预设变更点是引入更明确的空间语言:确保水果与水花严格位于包装文字区域之外,并将底部 18% 预留为纯净的 CTA 区域。
A 版本构图更优。NOVA FIZZ、四点星标、钴蓝罐身、黄色弧线,以及下方包装信息层级均清晰可辨,且整体可读性更稳定一致。B 版本虽整体保留了产品身份,但水果、水花与 CTA 的位置却与中下部标签区域形成视觉竞争。
结论: A 在直接可用性上胜出。B 仍具参考价值,因其严格控制了其余所有关键变量。
正面对决:提示词控制 vs 布局控制
B 版本加入了看似可量化的指令:划定中心包装安全区,以及底部 18% 的纯净 CTA 区。但最终成片并未稳定遵循该网格约束。
这并不意味着空间类提示词毫无价值,而是说明:视频生成器并非布局引擎。 “底部 18%” 这一指令,会与模型已习得的英雄构图逻辑、产品比例认知、水花动态规律及广告排版习惯发生冲突。增加更多限定条款或许有助提升效果,但无法构建像素级网格,也无法保证每一处元素的绝对定位。
此时,Agent 的价值远超单纯提示词重写器:它能锁定变量、生成有意义的变体、将成片与目标逐项比对,并精准识别出——下一步修正应交由其他生产环节完成。
结论: 使用提示词控制视觉意图与运动逻辑;使用确定性合成(deterministic composition)控制精确的字体排印与坐标定位。
正面对决:成本与生产工作流
审批卡片标注单次运行成本为 每段 8 秒 720p 视频消耗 19 点积分。实际 B 版本运行后的积分余额变动也恰好为 19 点。我们仅生成两段即停止,因对比结果已回答核心生产问题;再进行第三次全量重生成,只会增加成本,却无法解决 CTA 文字层的像素级定位问题。
我们的实证数据包含三个独立层级:
- Agent 会话完整记录计划、提示词、参数与提交动作;
- 下载的 MP4 文件证实最终交付物已生成;
- A 与 B 的取舍决策,源于人工逐帧审阅所得的编辑判断,而非自动化基准测试声明。
因此,最具成本效益的后续操作是:
- 将 A 版本作为生成源素材保留;
- 如有必要,在最终交付前移除模型自动生成的 CTA;
- 以确定性方式叠加文字 “Taste the bright side.”;
- 将价格、法律声明、URL 及最终 Logo 处理统一置于同一编辑图层;
- 首先导出 9:16 比例版本,再基于已批准创意衍生其他宽高比。如需了解以分辨率优先的终审工作流,请参阅我们的 Seedance 2.5 4K 教程。
结论: 两次受控生成 + 一次确定性后期处理,比反复付费重跑整段视频以修正单一文字层,效率更高。
你该选择哪种工作流?
✅ 请选择 Agent 主导生成,当:
- 你拥有多个品牌资产,但尚未明确定义各自角色;
- 产品身份与包装必须在动态场景中持续保持可识别性;
- 你需要可控的 A/B 变体,而非彼此无关的随机重试;
- 创意需包含镜头运动、光影、氛围、粒子、水果或液体等复杂视觉元素;
- 你希望系统能在更合适的工具成为下一步时主动中止。
✅ 请选择确定性后期处理,当:
- CTA 必须精确定位至指定坐标;
- 价格、折扣、法律声明、URL 或二维码必须逐字准确无误;
- Logo 需要像素级尺寸控制与明确留白;
- 多种宽高比需实现可预测的排版一致性;
- 源视频本身已达标,仅需修正叠加层。
谁不应继续堆砌提示词规则?当剩余问题仅涉及文字排版时,切勿持续购买完整重制(full reruns)。若产品动态、灯光效果及品牌识别度已达到可用标准,请直接将已修正的文案送入剪辑环节。Prompt C 并不天然比正确完成 Prompt A 更便宜——也不更可控。若您仍在犹豫应优先启动哪个营销活动或内容格式,这些实用的 Seedance 使用场景可为您提供一份有价值的规划地图。
结论
视频智能体(Video Agent)在制作前期最关键的部分取得了成功:它将非结构化的品牌素材包(brand kit)转化为清晰的资产角色定义;以真实包装实物为第一帧锚定画面基准;保留了品牌可识别的视觉身份;创建了受控的 A/B 对照变体;并帮助我们在测试产出明确决策后及时终止流程。
最终胜出的结果,并非规则最多的提示词(prompt),而是让所有规则均可被验证的协作流程。对于批量制作产品广告的团队而言,这正是智能体(Agent)的实际优势所在:模糊交接更少、不可控重制更少,且从品牌资产到获批成片的路径更加清晰。
准备好创作自己的 AI 视频了吗?
使用 Seedance 将创意、文字提示和图片变成精致视频。如果本文对你有帮助,下一步就是亲自试用产品。
注册即送免费积分,套餐每月 $28 起。
Kling 4.0 对比 Seedance 2.5:全面深度评测
Kling 4.0 与 Seedance 2.5 按参数逐项对比:时长、10 个关键帧对 50 个参考素材、音频、4K 与 10-bit 色彩、编辑能力,按用途给出选择建议。
阅读文章
Kling 4.0 关键帧与 Omni Reference 使用指南
讲清 Kling 4.0 的 10 个关键帧和 15 个 Omni Reference 素材怎么规划 30 秒视频,附 3 套实操方案、常见错误和 Seedance 2.5 的对照用法。
阅读文章
Kling 4.0 Flash vs Kling 4.0:核心区别对比
Kling 4.0 Flash 与完整版有何不同?对比时长、分辨率、色彩和关键帧,说明 Flash 何时够用,以及“Flash 出草稿、完整版出成片”的流程。
阅读文章