AI 概览
什么是支持原生音频的 AI 视频生成器?
它在同一生成过程中同步创建动态画面与音轨。因此,对话、环境音、音乐和物理音效可随画面动作自然呈现,而非后期添加至静音片段。
哪些 AI 视频生成器能同步生成音频与视频?
当前可选方案包括 Seedance 2.0、Veo 3.1、Kling 3.0 Omni 和 MiniMax H3。Sora 2 仍具重要参考价值,但该产品已于 2026 年 4 月停运。
是否存在免费的支持音频的 AI 视频生成器?
存在,但“免费”通常指提供入门积分、模型功能受限、排队速度较慢,或导出视频带水印。生成前请确认所选路径支持音频功能,再消耗积分。
如何提升对话与声音的同步效果?
仅使用一位可见说话人,精确引用简短台词,为每个动作指定一种音效,并将背景音乐音量控制在人声之下。建议先测试 6–8 秒片段,再尝试更长镜头。
什么是支持原生音频的 AI 视频生成器?
支持原生音频的 AI 视频生成器 将声音视为场景固有组成部分,而非独立附加项。例如,镜头平移时可伴随接触摩擦的嘶嘶声,演讲者口型可与生成语音精准匹配。这不同于后期为静音画面添加音乐、文本转语音(TTS)或自动唇形同步(lip sync)。
原生音频 vs. 后期配音
后期配音通常更清晰且易于修改,而原生生成则能将语音、脚步声、雨声、环境底噪及音乐与画面演进深度绑定。当时间节奏决定产品演示、对话场景、社交广告或故事短片成败时,此能力尤为关键。
原生不等于完成。发布前请务必复核发音准确性、说话人身份、音乐版权合规性、响度水平、字幕内容及背景噪声。模型可能生成逼真的环境音,却遗漏某个关键单词。
成品视频中可包含哪些声音?
原生音轨可包含人声、门声、引擎声、人群声、撞击声、配乐及旁白。优质提示词需明确优先级:对话优先,其次是一至两种与动作强关联的音效,环境音作为底层铺垫,音乐仅在能提升场景表现力时加入。
原生音频功能核查清单
请确认该工具是否具备以下能力:随画面帧同步生成声音、支持引用式对话输入、兼容您的目标语言、导出视频时同步包含音频文件。此外,还需核查生成时长限制、宽高比、分辨率、参考素材支持、水印策略,以及启用音频功能后重试所需的积分成本。
2026 年最佳支持原生音频的 AI 视频生成器
最优模型取决于具体镜头需求:Seedance 适用于产品类与社交类内容;Veo 3.1 侧重电影级画质;Kling 3.0 Omni 擅长多语种角色表现;MiniMax H3 则融合立体声音频与灵活参考机制。
快速对比表
| 模型 | 原生音频优势 | 最佳适用场景 | 主要注意事项 |
|---|---|---|---|
| Seedance 2.0 | 对话、环境音、音效、音乐、多参考控制 | 产品广告、创作者短视频、短篇故事 | 短片段中请保持混音简洁 |
| Veo 3.1 | 自然对话、分层环境音、精准音效 | 电影级主视觉镜头与叙事场景 | 短句仍可能出现听辨不清 |
| Kling 3.0 Omni | 多语种语音、口音模拟、角色化演绎 | 用户生成内容(UGC)、区域化营销、对话主导型视频 | 启用音频的生成消耗更多积分 |
| MiniMax H3 | 原生立体声、多模态上下文理解、音乐感知型运镜 | 环境氛围类场景与灵活工作流 | 不同部署路径(托管版 vs. 本地版)功能存在差异 |
| Sora 2 | 历史性优异的同步对话与音效表现 | 仅作基准参考 | 产品已于 2026 年 4 月停运 |
对话与唇形同步最佳选择
Veo 3.1 与 Kling 3.0 Omni 在人脸与语音共同驱动场景时表现突出。若任务还需整合产品或角色参考,则 Seedance 更为实用。请保持台词简短、完整呈现说话人面部、分隔不同发言段落,且勿遮挡口部。
本指南全新生成。请观看完整对话:女性发言,男性倾听,杯具声响应在台词结束后准确出现。
如需更深入的双人对话工作流,请参阅 多角色对话指南。
动作-声音时序测试
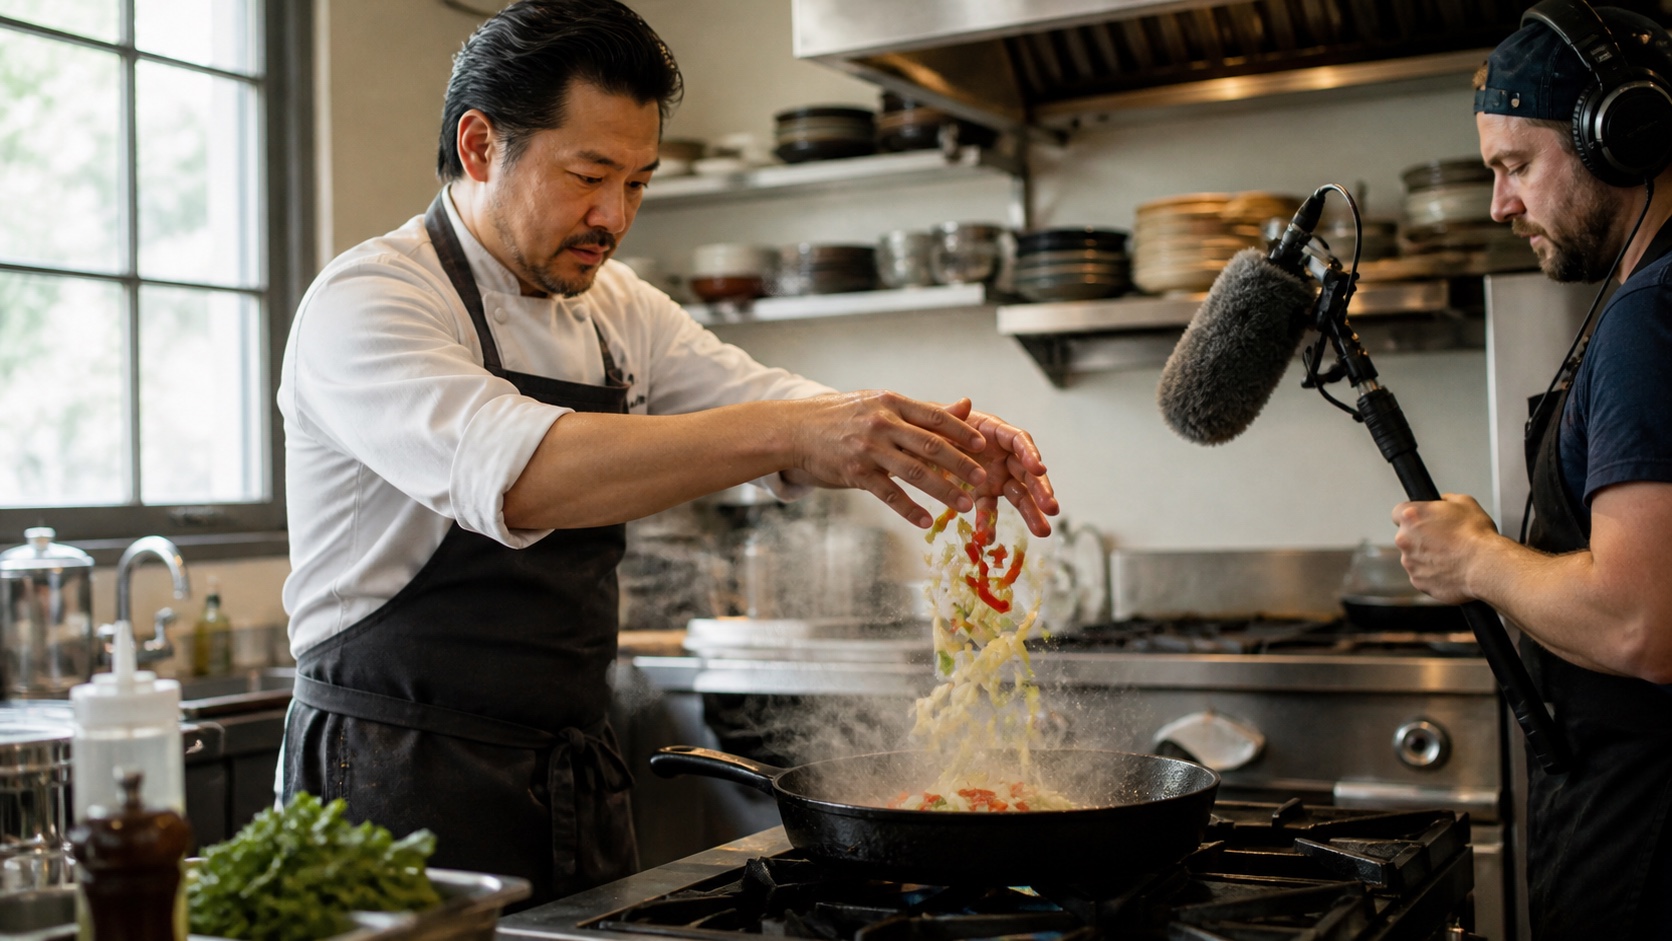
选定一个清晰可见的接触事件。嘶嘶声(hiss)应始于锅具接触瞬间——既不能早于蔬菜下落,也不能晚于镜头已移开之后。
在接触点附近逐帧拖动回放,并用手机扬声器重听。一个恰准落在动作上的轻量级音效,远胜于一个虽戏剧性强却严重延迟的音效。
环境氛围与音乐连贯性测试
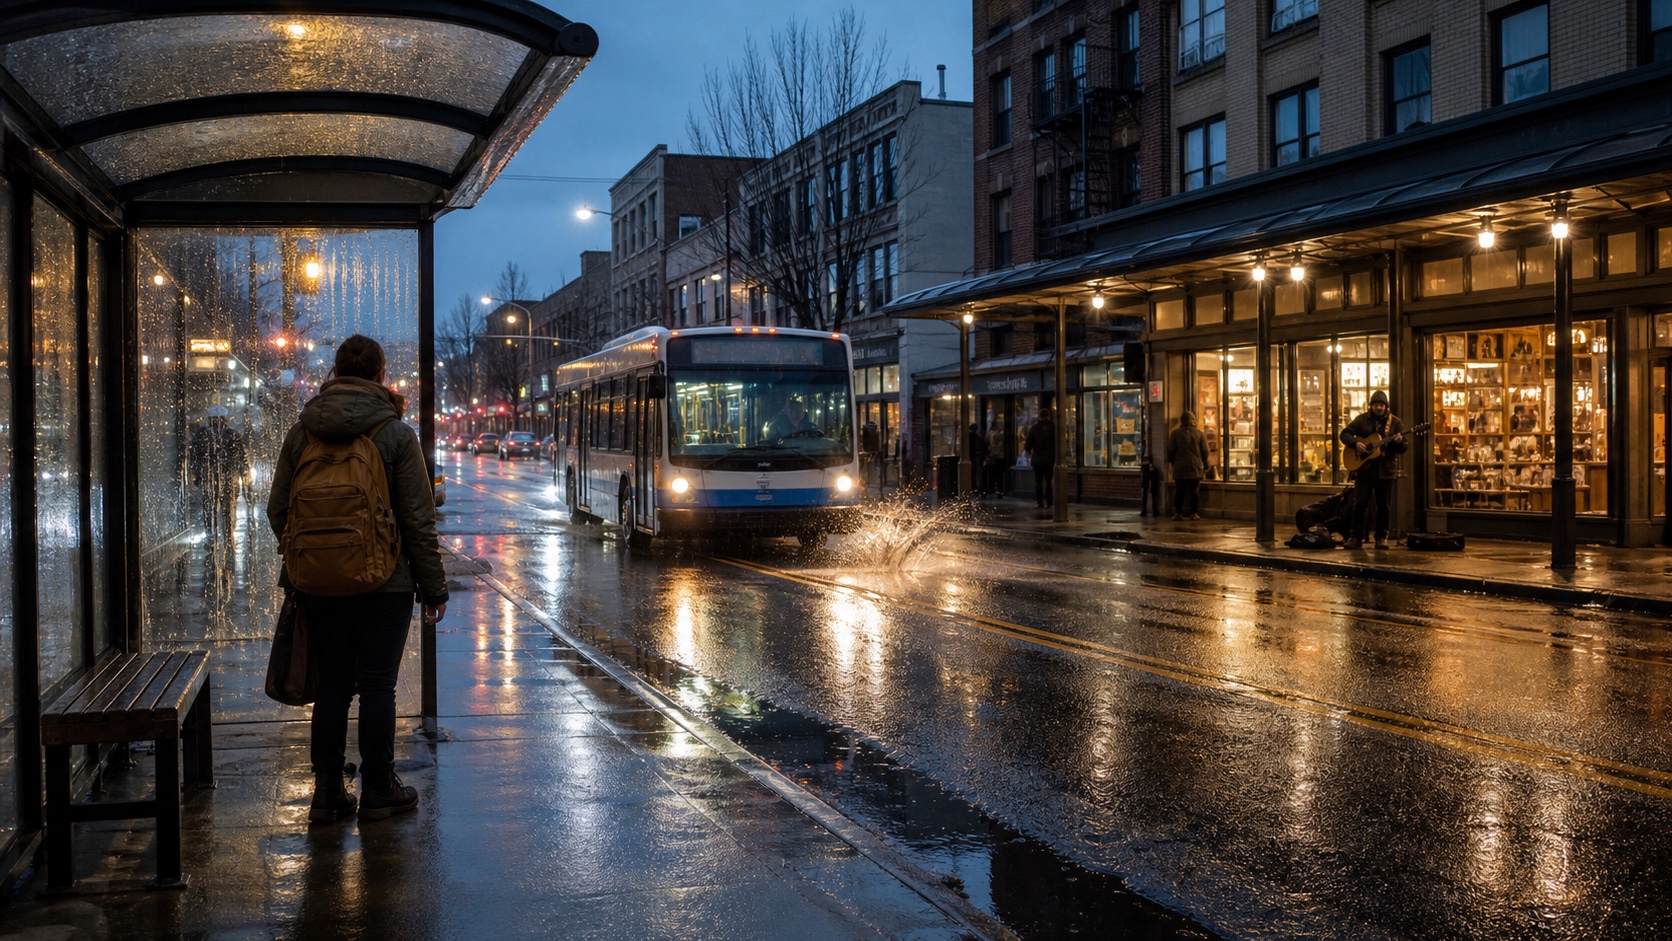
优质混音应清晰区分近处雨声、轮胎溅水声、候车者、远处交通声与音乐,且各层音量无需均等。
注意监听摄像机运动过程中环境底噪是否突兀重置。音乐不应在无视觉依据的情况下发生改变,且随着环境愈发嘈杂,对白仍须保持可懂度。
如何生成带原生音频的文生视频 AI 内容
选择合适的模型与音频模式
首先进入 文生视频 页面,选择明确支持原生音频的生成路径,设定较短时长,并在生成前确认音频开关已启用。若已有关键视觉参考图,则改用 图生视频,使模型减少构图创造负担,转而更专注执行运镜与音频指令。
采用“视觉+音频”复合提示词结构
先撰写画面描述:主体、动作、地点、景别、光线与运镜。再补充说话人、精确台词、音效、环境氛围、背景音乐及排除项。使用“exactly as”(完全同步于)、“after”(紧随……之后)或“throughout”(贯穿全程)等短语,将声音精准锚定至对应事件。
可直接复用的原生音频提示词范例
八秒生活方式类产品视频,场景为阳光充足的公寓。一位创作者打开一款无品牌旅行杯,注入咖啡,直视镜头并说道:“比你更快准备就绪。” 镜头缓慢横移,手部动作自然。音频:声音清晰温暖,晨间安静环境底噪,开盖瞬间发出清脆“咔嗒”声,倾倒声持续时间为 00:02 至 00:04,远处城市鸟鸣,无音乐,无字幕,无额外人声。
首次尝试时,建议将对白控制在约十个单词以内。若结果不理想,请每次仅调整一个变量:缩短台词、减少音效、移除音乐、放慢动作节奏,或让面部更靠近镜头。
带音频的图生视频工作流
选用一张干净的源图像,确保手部、口型、道具及环境上下文清晰可见。重点描述运动过程,而非重复所有视觉细节。明确指出每个声音由哪个对象发出,然后检查输出是否存在身份漂移(identity drift)。更多对白与混音模式,请参阅 Seedance 音频提示词指南。
请佩戴耳机,细致检查立体声声场定位、人声清晰度,以及咖啡馆环境音是否在整个镜头中保持稳定。
免费 AI 视频生成器(含音频):定价、积分与水印说明
“免费”究竟意味着什么一款**免费的 AI 视频生成器(含音频)**通常提供初始积分,而非无限生成。它可能不支持最新模型、降低输出分辨率、添加水印、限制下载权限,或使用更慢的排队队列。请在制定预算前,先查看实时生成面板。
免费方案对比表
| 方式 | 生成前需验证的内容 | 最佳免费测试用例 |
|---|---|---|
| Seedance | 注册赠送积分、所选模型、音频开关、导出分辨率 | 一个产品动作 + 一句五词台词 |
| Veo 访问权限 | 试用资格、所在地区、配额、所选 Veo 版本 | 一段含一种环境音效的对话 |
| Kling 访问权限 | 每日积分、原生音频费用、水印、支持语言 | 一位可见说话人 + 一种道具音效 |
| MiniMax H3 访问权限 | 托管配额 vs 本地部署、时长、2K 重生成能力 | 立体声环境音 + 一个前景提示音 |
每条可用视频的实际成本
记录所耗积分、渲染时长、重试次数及可用秒数。一次看似便宜但需六次重跑且需语音修复的尝试,其总成本可能高于一次优质尝试——后者仅需一半时间即通过。
如何选择合适的原生音频工作流
按使用场景决策指南
- 选用 Seedance 快速制作产品类、社交类及参考驱动型内容;
- 选用 Veo 3.1 制作电影级主角镜头;
- 选用 Kling 3.0 Omni 处理多语种角色场景;
- 选用 MiniMax H3 实现原生立体声或开放、多模态工作流。
常见原生音频失败情形与修复方法
- 说话人错位:为每位人物明确标识,并分隔发言轮次;
- 口型同步弱:缩短台词长度,并确保面部清晰可见;
- 音效延迟:仅使用一个接触事件触发;
- 意外出现音乐:在音频块中重复输入“no music”,并在排除项中再次声明;
- 对话背景嘈杂:减少环境音层数。
何时更适合采用分离式音频工作流
当以下任一因素比“单次生成速度”更重要时,请采用分离式音频工作流:品牌专属人声、音乐版权许可、长格式内容连贯性、本地化适配,或帧级精准控制。原生音频非常适合短片段,但高风险音轨仍需专业混音。
导出前最终检查清单
- 分别用耳机和手机各听一遍;
- 确认:对话词句准确、说话人身份无误、唇部闭合自然、音效时机恰当、环境音连续、音乐电平合理、结尾干净利落、字幕完整、使用权利清晰;
- 在编辑前先导出原始生成版本,以便每次修改均可追溯至对应提示词与设置。
结论
最佳的带原生音频的 AI 视频生成器,是能以最少重跑次数,将你真实需求转化为可用画面与声音的那一个。
- Seedance 是产品、社交及参考驱动型工作的实用起点;
- Veo 3.1 在追求画质优先的电影级测试中领先;
- Kling 3.0 Omni 适用于多语种角色场景;
- MiniMax H3 提供原生立体声灵活性与开放多模态能力。
运行一条简短且匹配度高的提示词,评估其对话表现、音效、环境音、音乐及整体修复成本,然后 使用 Seedance 创建你的首个原生音频视频。