
AI Overview
MiniMax H3 能否在单个视频中生成两个人物?
可以。H3 可以呈现多个角色,但每位人物需具备明确的身份标识、空间位置、动作行为及对白职责。一段仅含一次互动的简短场景,比在提示词中堆砌多个同步动作更可靠。
如何防止两位角色互换身份?
为角色分配稳定标签(如 Subject 1 和 Subject 2),分别为其设定独特着装与屏幕位置,并仅重复那些必须持续保留的特征。当身份准确性至关重要时,请使用独立的参考图像。
在 MiniMax H3 中,双人对白应如何编写?
为说话者指定稳定 ID(例如 S1 和 S2),在每句台词前标明说话人,并将仅且仅有实际说出的词语置于对话标签内。同时需明确说明倾听者的口部保持闭合状态。
哪种 H3 模式最适合双角色场景?
- 对于纯虚构的简单场景,使用文本模式或首帧模式;
- 若需控制单一过渡动作(如起始到结束的转变),选用首尾帧模式;
- 当两位人物需分别由独立图像、动作或语音素材定义时,则采用全参考模式。
为双人场景选择合适的 H3 模式
让最严格的约束条件决定输入模式
MiniMax H3 双人视频工作流始于提示词撰写之前。首先明确哪些要素必须受控:
- 若两位角色均可自由创作,则文本→音频→视频模式已足够;
- 若开场构图、着装与相对位置已预先确定,则提供一张首帧图像即可;
- 若某次互动必须精准落于已知终点(例如一人将箱子移交另一人),则首尾帧模式更为适用。
当角色 A 与角色 B 来源于不同身份图像、需借助独立视频提供肢体动作,或语音参考至关重要时,全参考模式是更优选择。MiniMax 支持最多九张参考图像、三段视频及三段音频,总计最多 12 个参考文件。注意:参考音频不可作为唯一输入,必须搭配图像或视频共同提交。请勿将帧控制类任务与全参考类任务合并至同一请求中。
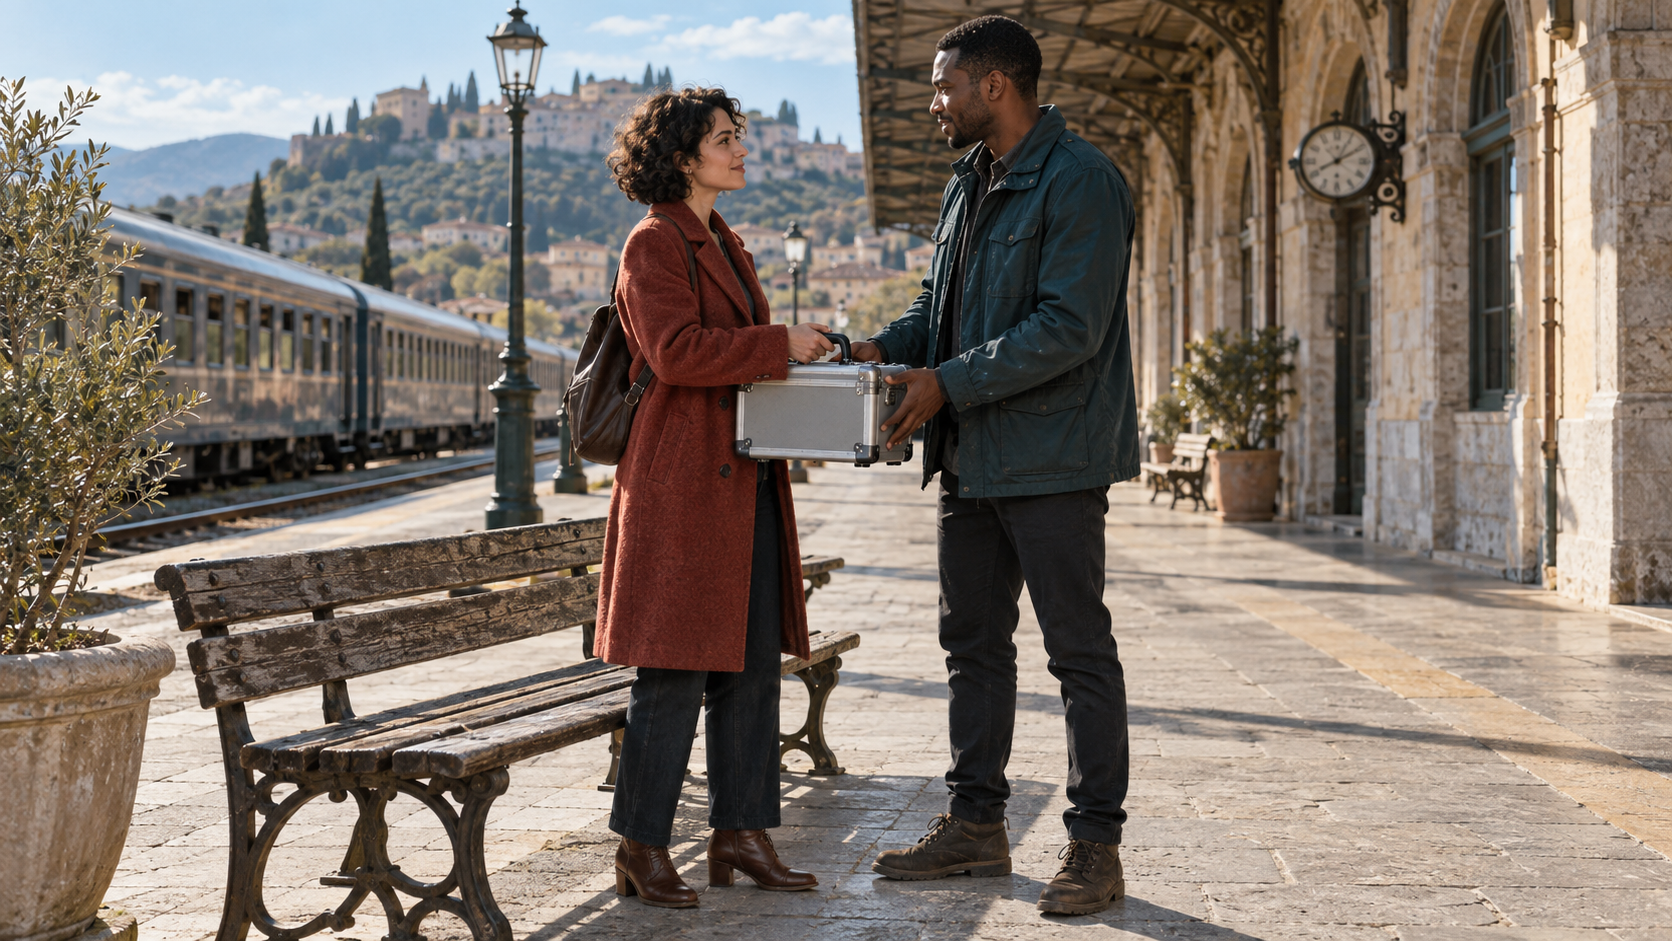
示意性生成参考帧:两件风格迥异的外套、彼此分离的剪影、固定的站台背景,以及一件共持道具,共同构成可识别的连贯性锚点。
将视频时长视作“动作预算”。H3 支持 4–15 秒时长,但 15 秒并非允许塞入更多情节的许可。为两位人物分配一个因果性节奏单元:接近→交接→定格;提问→回答→反应;或入场→察觉→离场。若场景需切换第二地点或引入另一重大动作,请另起新片段,并通过可续接的多镜头工作流衔接。
定义 Subject 1 和 Subject 2
创建简洁的角色身份与调度卡片
在编写时间线前,先将两位角色分别整理为独立的制作记录。每张卡片需包含:可视身份、着装、初始位置、道具归属、动作限制、说话人 ID 及参考来源。差异应一目了然;“两个穿深色夹克的人”易引发歧义。
| 控制项 | Subject 1 | Subject 2 |
|---|---|---|
| 身份 | 女性,30 岁出头,黑色短卷发 | 男性,30 多岁,极短平头 |
| 着装 | 锈红色羊毛大衣,棕色靴子 | 深青色工装夹克,黑色靴子 |
| 起始位置 | 屏幕左侧,靠坐长椅旁 | 屏幕右侧,靠近车站墙边 |
| 道具状态 | 握持箱体提手 | 托住箱体主体 |
| 说话人 ID | S1 | S2 |
| 动作限制 | 向前迈一步,松开提手 | 接过箱体,向后退步 |
在全参考模式下,需明确定义每个资产所承担的作用。Subject 标签代表可复用的视觉内容,而 Picture、Video 和 Audio 标签则用于标识源媒体或结构化参考。若首张图像中已包含两人及场景,请勿将整张图统称为 Subject 1;而应声明:Subject 1 是来自 Picture 1 的女性,Subject 2 是来自 Picture 2 的男性;仅当平台本身需被主动复用时,才单独为其定义。
subject_definitions:
<Subject 1> 是 <Picture 1> 中的女性,保留其黑色短卷发、锈红色大衣、面部特征及棕色靴子。
<Subject 2> 是 <Picture 2> 中的男性,保留其极短平头、深青色夹克、面部特征及黑色靴子。
<Subject 3> 是 <Picture 3> 中所示的小型银色设备箱,保留其尺寸、提手、卡扣及拉丝金属表面质感。
避免在后续镜头中对任一人物面部进行不同描述。稳定的标签可降低形容词与参考素材之间的语义竞争。对于需在视角变化中持续存在的场景锚点,请参阅 MiniMax H3 环境一致性指南,了解如何命名建筑结构、光线方向、家具及背景物体,而不致将提示词变成物品目录。
调度互动与道具交接过程
描述状态变化,而非仅表达意图
“他们自然地交换箱子”掩盖了最难生成的关键帧。请按播放顺序描述道具状态:Subject 1 握持提手;Subject 2 将双手置于箱体下方;双方短暂共同承托;Subject 1 张开手指并撤回;Subject 2 持箱后退;双方最终静止。如此,模型获得的是可观测的动作路径,而非模糊的社会行为描述。
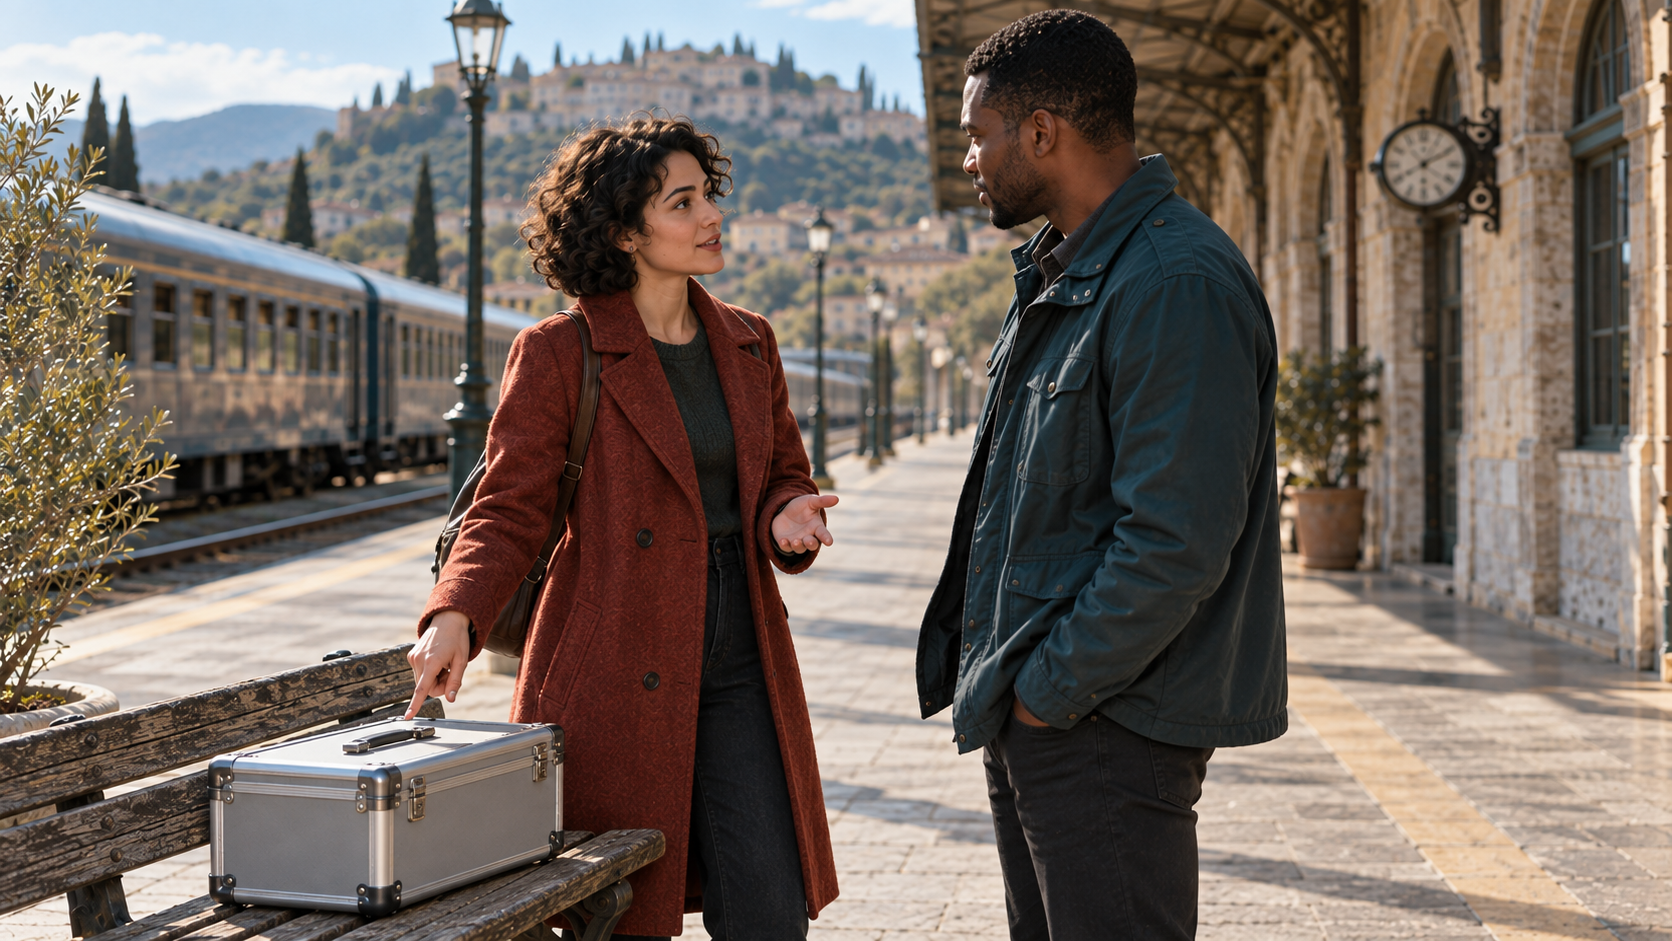
示意性生成的构图帧:讲话者做出手势,倾听者视线清晰,公文箱稳定置于交接前的位置。
保持空间描述的一致性。“画面左侧”和“画面右侧”是相对于摄像机而言;而“靠近轨道”和“靠近站台墙”等表述在镜头反打(reverse angle)时更具鲁棒性。当一次剪辑改变人物朝向时,须在下一个动作开始前重新确立两人的位置与朝向。每次仅使用一种镜头运动——例如缓慢推进至两人——避免同时叠加弧形运镜、变焦、摇摄及手持抖动。
双手交互失败常出现在两人手臂相互穿插,或提示词跳过了接触阶段。需确保公文箱尺寸足够容纳两个清晰可辨的握持姿态,防止任一身体越过另一人中线,并让交接过程持续数秒。收尾须干净利落:明确公文箱归属方、双方站立位置、视线方向,以及任一人口部是否仍在运动。
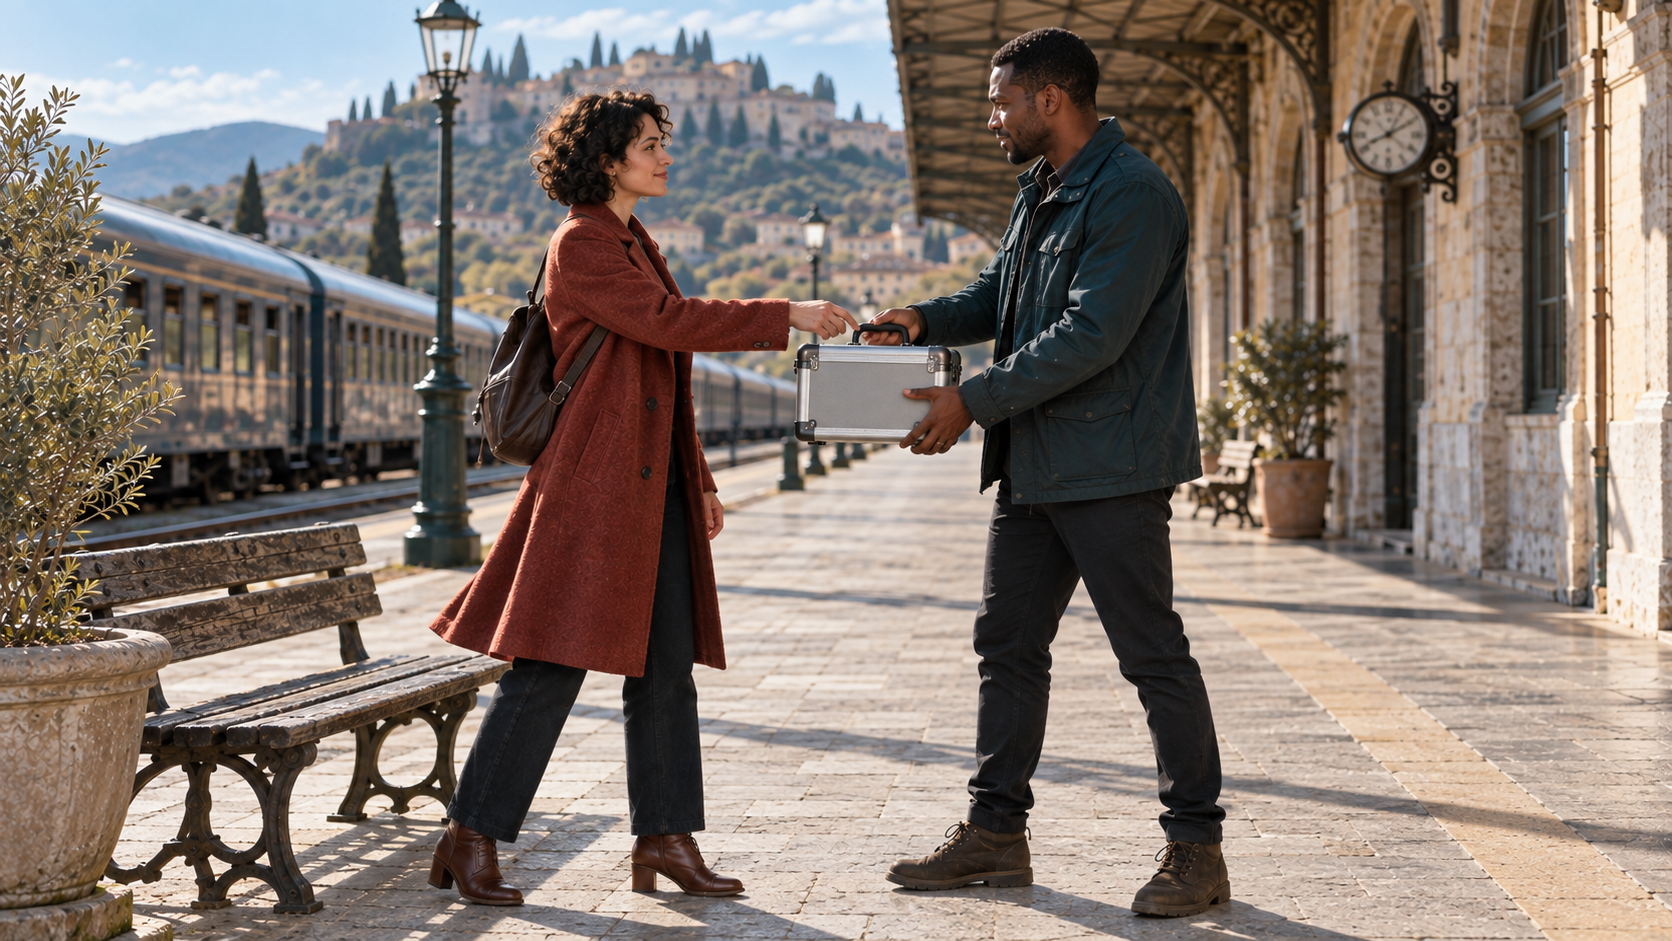
示意性生成的动作帧:检查手部间距、道具几何形态、外套连贯性,以及共享接触期间是否出现多余手臂。
控制双人对话与声音
为每句台词与每个倾听节拍分配明确标识
MiniMax 的官方基础指南采用稳定的说话人 ID,例如 S1 和 S2。将识别短语、说话人 ID、语气表达与动作说明置于对话标签之外;仅将语言标签与确切说出的内容保留在 <d>...</d> 标签内部。当两人同步发言时,支持复合 ID(如 S1,S2),但重叠对白比交替发言更难实现,应作为进阶测试。
身穿铁锈红外套的女性(S1)注视着公文箱,轻声说道:<d>[English] Keep this with you until the next stop.</d> Subject 2 倾听,双唇紧闭。
身穿青绿色夹克的男性(S2)接过公文箱,与她目光交汇,回应道:<d>[English] I understand.</d> Subject 1 倾听,双唇紧闭。
使用适配当前可见镜头的简短台词。明确标出语音结束时刻、下颌闭合时刻,以及倾听者的反应时机。将平台环境音、脚步声、公文箱搭扣咔嗒声、衣物摩擦声等纳入整体音景(soundscape),而非重复列为对话内容。仅面向观众的音乐应填入“非叙事性音乐(non-diegetic music)”字段。若画外音(voiceover)确属画外,须显式标注为“画外音”,并确保画内角色口型保持闭合。
实际 Seedance 输出,非 MiniMax H3 结果:在评估更复杂的双人对白前,先以受控的单人片段作为口型、节奏与环境底噪(room-tone)的基准。
对于跨多个片段重复出现的人声,可参考 Seedance 声音一致性指南,该指南提供针对音色、语速、响度、环境底噪及说话人间分离度的听觉校验流程。
构建三镜头连续性方案
确保每次剪辑均继承锁定状态
多数双人场景仅需三个短镜头即可完成。镜头 1 建立两位主体、所处平台及公文箱初始归属;镜头 2 拉近呈现交接过程,并各包含一句台词;镜头 3 确认道具新归属方,并给予双方安静的反应时刻。为每个镜头定义起始状态、动作、摄像机行为、声音设计及锁定的结束状态。
镜头 1 的结束状态必须与镜头 2 的起始状态完全一致。若剪辑点处公文箱位于长椅上,则下一帧中它不可突然出现在 Subject 2 手中,除非有可见的拾取动作。若 Subject 1 起初站在轨道旁,则不得在未通过剪辑与摄像机朝向明确交代的前提下,将其反转至站台墙边。MiniMax H3 多关键帧工作流 展示了如何将有序帧分配至主时间轴,而非将其当作垂直排列的故事板拼贴处理。
H3 的基础指南允许在镜头 1 后精确指定剪辑时间点。仅在有助于叙事时使用该功能,并确保时间间隔连续。一个实用的 12 秒方案为:0–4 秒用于建立场景,4–9 秒用于交接过程,9–12 秒用于结尾定格。最后两秒不应引入全新动作。
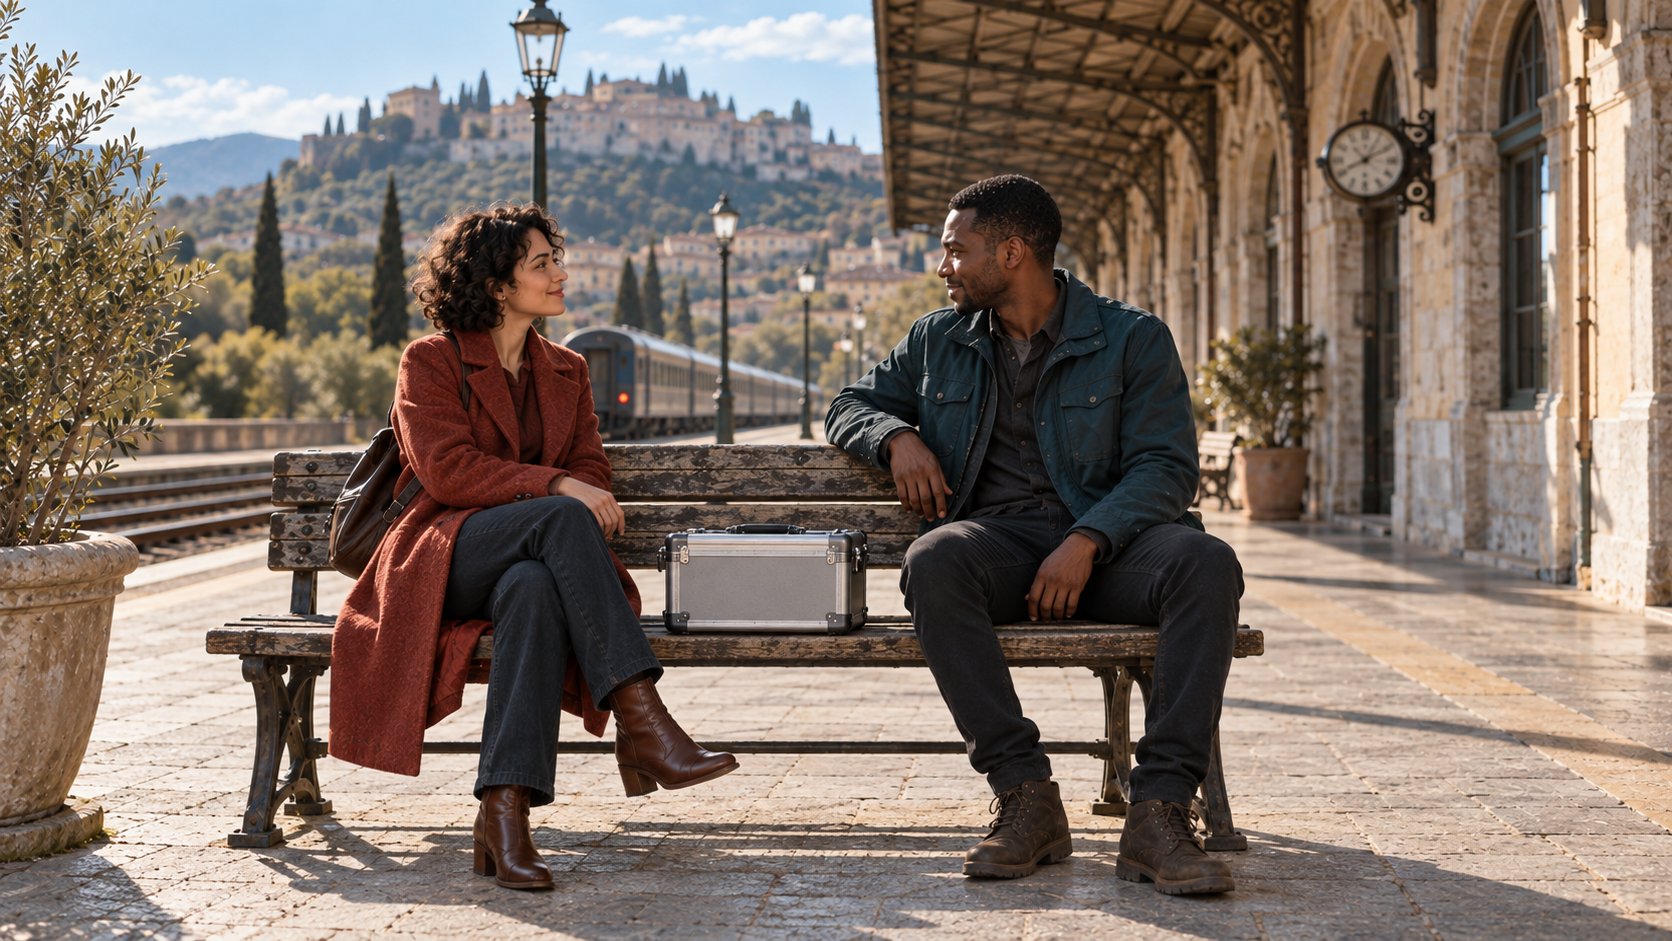
示意性生成的结尾帧:相同面容、外套、长椅、站台、公文箱与光照,使连续性偏移易于察觉。
复盘失败原因并重跑最小改动单元
将每一处可见失败精准对应至单一提示词修改
以正常速度完整回看成片,再以半速重点检查交接与对白段落。若人物身份发生错乱,需强化主体与参照物之间的映射关系,并简化剪辑逻辑。若广角镜头中面部融合,应增大主体间距,或将对白移至中景双人镜头;远距离面部修复指南 提供了针对该问题的构图与参照选择建议。| 失败现象 | 可能原因 | 最小且有效的修正措施 | | --- | --- | --- | | 角色间动作错位(如角色互换行为) | 服装相似或标签模糊不清 | 恢复清晰可辨的标签、服饰、站位及说话人 ID | | 两人嘴唇同时运动 | 听者行为未明确指定 | 在每句台词后添加“倾听,双唇保持闭合” | | 额外手臂出现 | 交接过程跳过了接触状态 | 扩展共持(shared-support)与释放(release)阶段 | | 道具形状改变 | 动作过多或道具定义薄弱 | 锁定道具的尺寸、握持点、表面处理方式及最终持有者 | | 切镜后视线方向断裂 | 角色位置未在新镜头中重新确立 | 在新视角下重申双方位置及凝视方向 | | 环境重置(丢失场景连续性) | 场景锚点为隐式设定 | 重复声明平台、长椅、列车、光照方向及时间 |
切勿因单个交接帧失败而重新生成整个优质建置(establishment)。请保存已通过的角色参考、提示词版本、随机种子(seed)或任务记录(如可用)、输出结果及失败说明。随后仅以最小粒度重跑该片段,并施加一项纠正性修改。Seedance Agent 可组织上述参考信息、比对候选方案、保留审批状态,并仅将失败片段送入 reference-to-video 工作流。
结论
一套可靠的 MiniMax H3 双人视频工作流,需采用恰当的输入模式、两个毫无歧义的主体记录、稳定的 S1 与 S2 说话人 ID、一次因果明确的互动、显式声明的道具状态变更,以及一份剪辑计划——其结尾状态须与下一镜头的起始状态精确匹配。应分别审查身份、嘴部归属、手部动作、视线方向、道具几何形态、环境及声音;仅重跑失败的节拍(beat)。为将参考素材、镜头、审批状态与定向修订统一管理,请使用 Seedance Agent 构建双角色序列。
Socialive Catalyst 早期访问指南:准备一次富有成效的首次试点
了解谁可以访问 Socialive Catalyst、早期测试版包含哪些内容、为演示需要做哪些准备,以及如何测试一个品牌化的企业视频工作流。
阅读文章
FramePack Torch CUDA 未启用:诊断并修复正确的环境
通过检查确切的 Python 运行时、替换仅支持 CPU 的 wheel 包、处理驱动程序或 RTX 兼容性问题,并验证修复效果,来解决 FramePack 中 Torch 缺少 CUDA 支持的问题。
阅读文章
Google Vids 个人虚拟形象教程:录制、提示与修复
创建 Google Vids 个人虚拟形象,完成面部与声音采集,编写实用的 Gemini Omni 提示词,修复访问权限缺失问题,并管理您的录制内容。
阅读文章