
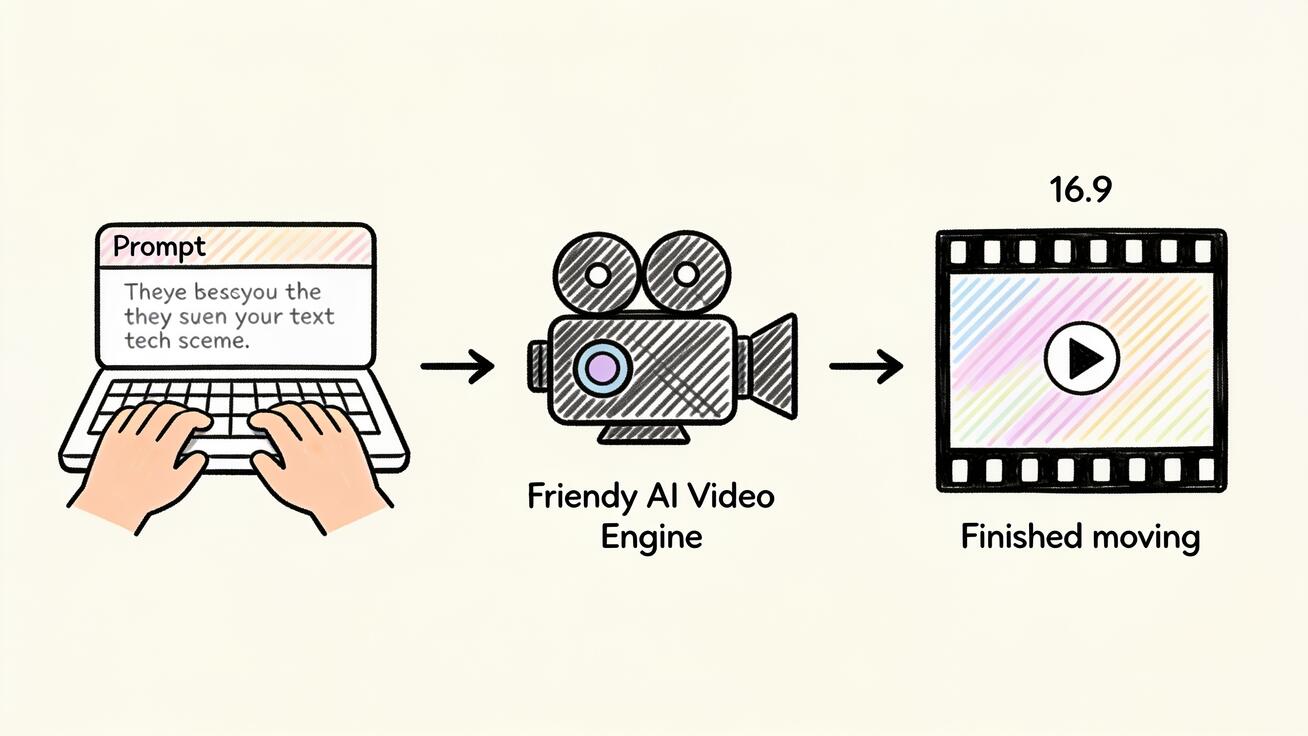
如果你想学习如何使用 Seedance 2.5,简要版操作流程如下:你输入一段提示词(prompt)或上传一张图片,选择各项参数设置,模型便会返回一段带同步音频的、连续完整的视频片段。这就是整个生成闭环。但要产出真正可用于发布的视频片段——逻辑连贯、画面锐利、主题明确——仅靠“输入文字,点击生成”是远远不够的,还需更精准的引导。本指南将逐步详解完整的 Seedance 2.5 工作流,涵盖文本生成视频(text-to-video)与图像生成视频(image-to-video)、参考图系统(reference-image system)、提示词结构、音频处理,以及区分可用镜头与视觉混乱片段的关键 QA 校验环节。
Seedance 2.5 是 ByteDance 推出的新一代视频生成模型,于 2026 年 7 月 31 日正式发布。其核心升级在于生成时长:单次提示即可输出最长 30 秒的连续视频片段,音频在同一次推理过程中同步生成,并支持丰富的多模态参考输入。如果你曾使用过早期版本(通常上限为 15–20 秒),并需手动拼接多个短片段来构建完整序列,那么 Seedance 2.5 将彻底改变你的工作方式。下面我们深入展开。
Seedance 2.5 何时发布?可在哪些平台使用?
ByteDance 于 2026 年 7 月 31 日正式发布 Seedance 2.5。其发布声明指出,该模型已陆续上线 Jimeng AI、Doubao Pro 及其他平台;而通过 BytePlus ModelArk 提供的 API 接入方式则仍标注为“即将推出”。这一区别至关重要:7 月 31 日是确认的模型发布日期,但具体可用时间仍因产品形态、地域及账户权限而异。
若你希望立即开始创作,而非持续追踪各平台独立的上线进度,请直接打开 Seedance AI 视频工作区,检查模型选择器中是否已提供 Seedance 2.5。随后,使用下方工作流,以一个真实素材为基础、构建完整场景起承转合,生成两个变体版本,并在将广告活动或客户视频迁移至 2.5 版本前,对比评估主体一致性、运镜流畅度与音频同步精度。
快速入门:五步上手 Seedance 2.5
仅需掌握核心流程、无需了解背景知识的用户可直接参考以下步骤:
- 打开 Seedance,选择模式——Text-to-Video(从提示词开始)或 Image-to-Video(从静态图像开始)。
- 撰写提示词。 描述主体、动作、镜头运动、场景环境与整体氛围。务必具体;Seedance 2.5 具备强提示词遵循能力,细节越丰富,结果越精准。
- 如有参考素材,请一并添加。 可上传一张图像锚定视觉风格,或最多附加 50 张参考图,以确保人物形象、产品外观或整体视觉风格在多次生成中保持一致。
- 执行生成。 Seedance 2.5 将返回一段最长 30 秒的连续视频片段,格式为 4K,且音频已与画面严格同步。
- 审阅并导出。 检查人物/主体一致性、运动连贯性及音画同步效果,随后下载成品,或基于微调后的提示词重新生成。
以上即为核心生成闭环。本指南其余部分旨在让每一步操作都稳定可靠,助你避免因盲目尝试而浪费生成额度。若你是 AI 视频领域的新手,希望先获得更平缓的入门体验,可参阅 Seedance 2.5 模型介绍页,该页面以概览形式清晰列出了全部功能特性。
Seedance 2.5 的新增特性(及其对工作流的影响)
在进入具体操作步骤前,有必要先了解该模型究竟有哪些实质性差异——因为这些新能力,直接决定了你应如何构建提示词。
- 单次生成最长 30 秒的连续视频片段。 不再需要生成多个短片段后手动剪辑拼接,你只需完整描述一个场景,Seedance 2.5 即可将其渲染为一段逻辑自洽的单一长镜头——其长度约为当前多数竞品单次生成能力的两倍。整段视频内的一致性得以保障,人物或产品形象将从第一秒到最后一秒始终如一。
- 原生支持 4K 格式与 10-bit 色深。 输出为 4K 格式,色深达 10-bit,相较传统 720p/1080p 时代实现显著跃升。这意味着渐变过渡更平滑、天空与阴影中色带(banding)更少,成片在大屏幕上亦能保持高画质表现。
- 音频与画面同步生成,一步到位。 声音并非后期硬加,而是与画面共同推理生成。环境音效、音效设计与节奏时序均与视觉内容实时协同产出。
- 最多支持 50 张多模态参考图。 你可向模型批量输入参考图像,用以锁定特定人物面部特征、产品工业设计或跨生成任务的统一视觉风格。
- 强提示词遵循能力。 模型能高度忠实执行详尽指令,因此精准的提示词将带来优异结果,而模糊笼统的提示则易导致偏差。
此外,还有一款轻量级衍生模型:Seedance 2 Mini,专为速度与成本优化而生——每秒消耗 3 点积分,生成时长为 4–15 秒,输出分辨率为 480p 或 720p,并含同步音频。当项目对时长、分辨率与保真度有严苛要求时,请选用完整版 2.5;若需快速迭代或批量生成大量短视频,则 Mini 版本更为合适。
实际启示在于:由于单次提示即可驱动一段长时长、高连贯、带音频的视频生成,你的提示词必须承载比以往更丰富的信息量。你不再只是描述一个两秒的瞬间,而是在导演一场具备起、承、转、合的完整场景。
如何使用 Seedance 2.5 进行 Text-to-Video
文本生成视频(text-to-video)是最快上手的方式,因为你无需准备任何素材——仅需一段清晰准确的描述。以下是详细操作步骤。
步骤 1:选择 Text-to-Video 模式
打开 Seedance,选择 Text-to-Video 选项。此举将告知模型:整个场景完全由你的文字描述驱动,不依赖任何源图像来约束构图。
步骤 2:构建提示词结构
低效的提示词仅简单命名对象;高效的提示词则能精准指导镜头语言。请围绕以下五个要素构建你的提示词:- 主体——画面中的人物或物体,需具体描述。
- 动作——其行为,包括该行为在视频片段中如何随时间变化。
- 镜头——景别与运镜方式(固定镜头、缓慢推进、跟拍、环绕、升降)。
- 场景——地点、一天中的时段、光线条件。
- 情绪 / 风格——情感基调与视觉处理方式(电影感、纪实风、温暖、阴郁等)。
由于 Seedance 2.5 最长可生成 30 秒的视频,你还可以描述一个微小的叙事弧线——即起始状态、中间变化与最终落点——而不仅限于一个静止瞬间。
第三步:撰写完整提示词
以下是一个完整、可直接复制使用的示例,供你参考调整:
清晨时分,一家小型精品咖啡馆内,一位独自工作的咖啡师。温暖的晨光透过窗户洒在吧台上。她先蒸奶,再缓缓将奶泡倾注入一杯平白咖啡,拉出一朵精致的羽落图案。镜头起始于杯体的特写,随后平稳后拉并微微上升,逐渐展现温馨的店内环境及几位安静的顾客。电影感画风,浅景深,柔和暖色调调色,背景伴有轻柔的咖啡馆环境音。
注意其中如何明确指出了主体、按顺序展开动作(蒸奶 → 拉花)、指定了两个清晰的镜头运动(后拉 + 上升)、锁定了场景与光线,并设定了整体情绪。这种程度的具体性,正是模型强大提示词遵循能力所奖励的方向。
第四步:设置分辨率与时长
若目标用途为网站首屏大图、大型显示屏,或后续需放大展示的场景,请选择 4K。时长可设为最长 30 秒。更长的视频为模型提供了更大空间来实现你设定的叙事弧线;但同时,它也要求整个场景必须由单条提示词完整覆盖——因此请确保你的提示词真正“填满”全部时长,而非留下长达 20 秒的空白。
第五步:生成并审阅
运行生成后,请完整观看整段视频——而不仅限于第一秒。检查动作是否按序发生、镜头运动是否符合预期、音频是否与画面匹配。若结果有偏差,请每次仅调整一个变量(参见下方故障排查部分),而非重写整条提示词。
如需更丰富的提示词模板库(涵盖电影感、产品展示、社交媒体、角色一致性等方向),可参考 最佳 Seedance 2.0 提示词指南 —— 其内容几乎完全适用于 2.5 版本;相同的提示词规范依然有效,只是你现在拥有更多秒数来填充细节。
如何使用 Seedance 2.5 实现 Image-to-Video
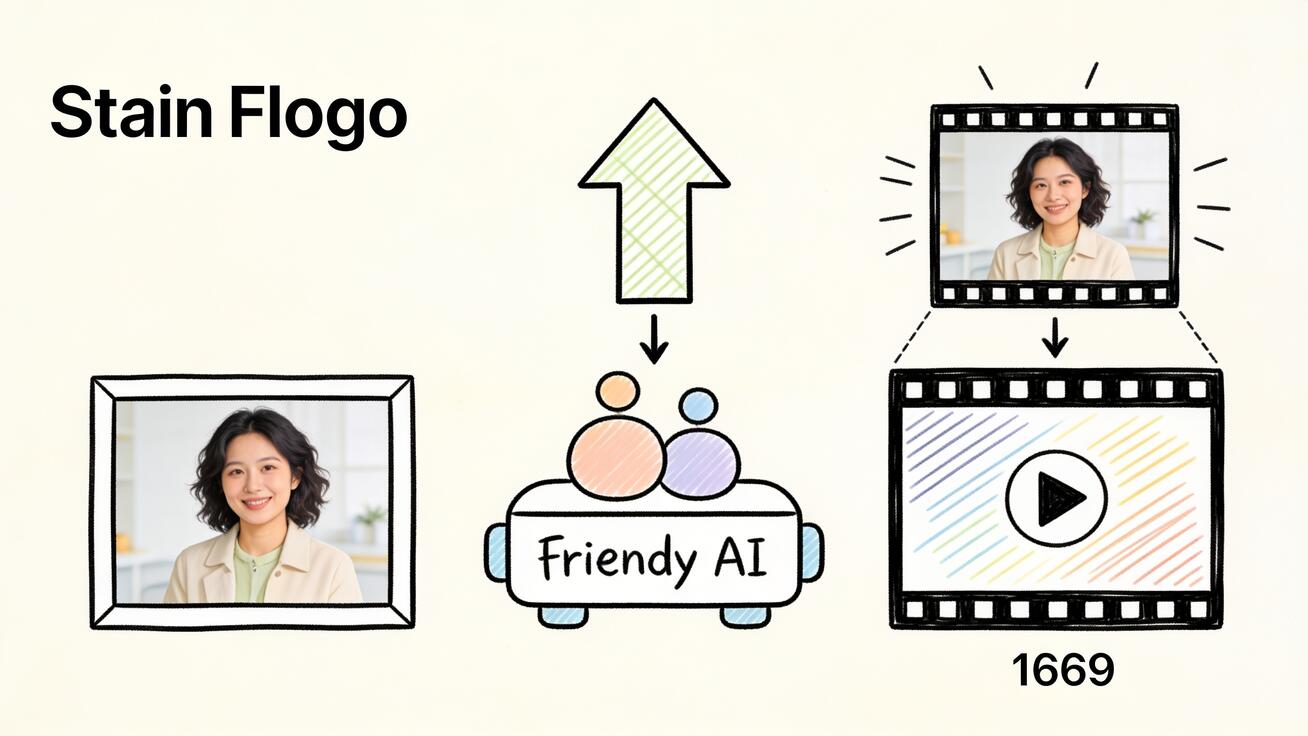
图像转视频(Image-to-video)以你已有的静态图像为起点——例如产品照片、角色渲染图、品牌定帧画面或一幅艺术作品——并为其赋予动态生命。当你需要输出结果与现有资产严格一致时,应采用此工作流。
第一步:准备源图像
Seedance 2.5 支持 JPG、PNG 和 WEBP 格式,文件大小上限为 10MB,最小宽高均为 300 像素。为获得最佳效果:
- 使用你所拥有的最高分辨率版本图像。模型只能对图像中实际存在的细节进行动画化。
- 确保主体清晰、光照充足。模糊、低对比度的源图会导致运动效果浑浊不清。
- 裁剪至你希望作为起始帧的构图——模型将以此为基础向外生成动态。
第二步:选择 Image-to-Video 模式并上传
选择 Image-to-Video 模式,然后上传已准备好的图像文件。该图像将成为锚点:即模型启动动画的初始构图。
第三步:描述你期望的运动效果
这是人们最容易跳过的步骤,却恰恰是最关键的一环。图像告诉 Seedance “场景是什么”;而你的提示词则告诉它“什么该动、如何动”。若缺少运动提示词,结果将不可预测,甚至接近静止。
一条可直接复制使用的图像转视频提示词示例:
产品与背景须完全保持原图所示。瓶身缓慢旋转 30 度以展现标签,同时一道柔和高光沿玻璃表面扫过。镜头轻微前推。氛围为细腻的影棚环境音。写实风格,产品外形不得发生任何形变。
短语“产品须完全保持原图所示”至关重要:它明确指示模型在保留原始资产的前提下,仅添加你所描述的运动。这正是实现精准动画、而非让模型重新设计产品的关键所在。
第四步:生成后核查与源图的一致性
生成完成后,请将输出结果与原始图像逐帧比对。在图像转视频任务中,需特别关注两点:主体形变(产品或人脸在运动过程中是否扭曲?)与身份漂移(视频结束时,主体是否仍与源图保持一致?)。若任一问题出现,请在提示词中强化“保留”类表述,并减少所请求的运动幅度。
如需深入掌握该模式——包括更多提示词模板与针对性修复策略——请参阅完整指南:Seedance 图像转视频转换全流程指南(2026)。
使用参考图像保障一致性
参考图像系统是 Seedance 2.5 在重复性工作中真正发挥强大能力的核心机制。你最多可附加 50 张多模态参考图像,用以引导单次生成,从而解决 AI 视频领域最棘手的难题:在多个视频片段中持续保持同一角色、同一产品或统一视觉风格的一致性。
当以下情况出现时,请启用参考图像:- 角色一致性 — 同一人物的面部与服饰在一系列视频片段中保持一致。请提供该角色多张清晰、不同角度的照片。
- 产品一致性 — 广告系列中每个镜头里的产品外观必须完全相同。请提供多张产品图像:正面、侧面、细节特写。
- 风格一致性 — 整个内容系列呈现统一的视觉风格。请提供参考帧,确保其共享您希望复现的调色、布光与构图。
分步参考工作流
- 收集您的参考素材。 汇集清晰、高画质的图像,涵盖您关注的角度与拍摄条件。多样性有助于模型泛化;模糊与杂乱则会削弱效果。
- 将参考素材附加至生成任务中。 在提示词旁一并上传您的参考图像。
- 在提示词中明确引用这些参考素材。 用文字描述主体(例如:“穿红色夹克、留齐耳黑发的女性”),使文本与图像相互强化。
- 生成一个片段并锁定您的参考集。 当某组参考素材产出理想结果后,请在该系列所有片段中重复使用同一组参考,以确保视觉风格持续统一。
这正是单条片段与连贯内容体之间的分水岭。广告活动、讲解视频系列或反复出现的品牌角色,全都依赖于此。
精准把控音频
由于 Seedance 2.5 是画面与音频协同生成,您可直接在提示词中塑造声音,而无需后期添加。以下是一些实用技巧:
- 命名声景。 使用“轻柔的咖啡馆环境音”“安静房间底噪”“微风与远处海浪声”或“细微的录音棚嗡鸣”等表述,可有效引导音频朝向预期方向。
- 让音频匹配动作。 若提示词中按顺序描述了动作(如倾倒液体、脚步声、开门),同步生成的音频通常能精准跟随。请清晰描述动作,声音往往随之自然呈现。
- B-roll 音频宜克制。 若画面最终将叠加旁白或配乐,请提示生成低调的环境音,避免与成片音轨冲突。
- 务必开启音频审阅。 始终在开启音频状态下检查片段。视觉上看似正常的内容,音频可能严重错位——唯有亲耳聆听才能发现。
若您最终成品需嵌入特定授权音乐或录制好的旁白,请将生成音频视作参考音轨,在剪辑软件中替换即可;但对氛围类或音效驱动型片段而言,协同生成的音频常可直接交付使用。
Seedance 2.5 的最佳适用场景
30 秒时长、4K 分辨率与同步音频在此类用例中真正发挥价值:
- 网站首屏视频(Hero Video)。 单条连续的 4K 视频片段,恰好契合落地页首屏需求——足够长以实现自然循环,分辨率足够高以适配大屏显示。
- 产品演示与广告。 由产品照片生成视频,并辅以参考图像确保全系列中产品外观完全一致,助您获得干净专业的商用影像。
- 社交媒体内容。 Mini 模型适合快速批量产出短格式内容;完整版模型则适用于您希望呈现高端质感的核心作品。
- 讲解类与教育类系列视频。 基于参考图像的角色一致性,可跨多个片段构建反复出现的讲解人或品牌吉祥物。
- 电影感 B-roll 与情绪化短片。 长时长、连贯且带音频的镜头,特别适合营造氛围的影像——这是早期仅支持短片段的模型所无法持续实现的。
共通要点:当长度、分辨率与一致性至关重要时,请选用完整版模型;当速度与产出量比精修程度更关键时,则选择 Mini 模型。
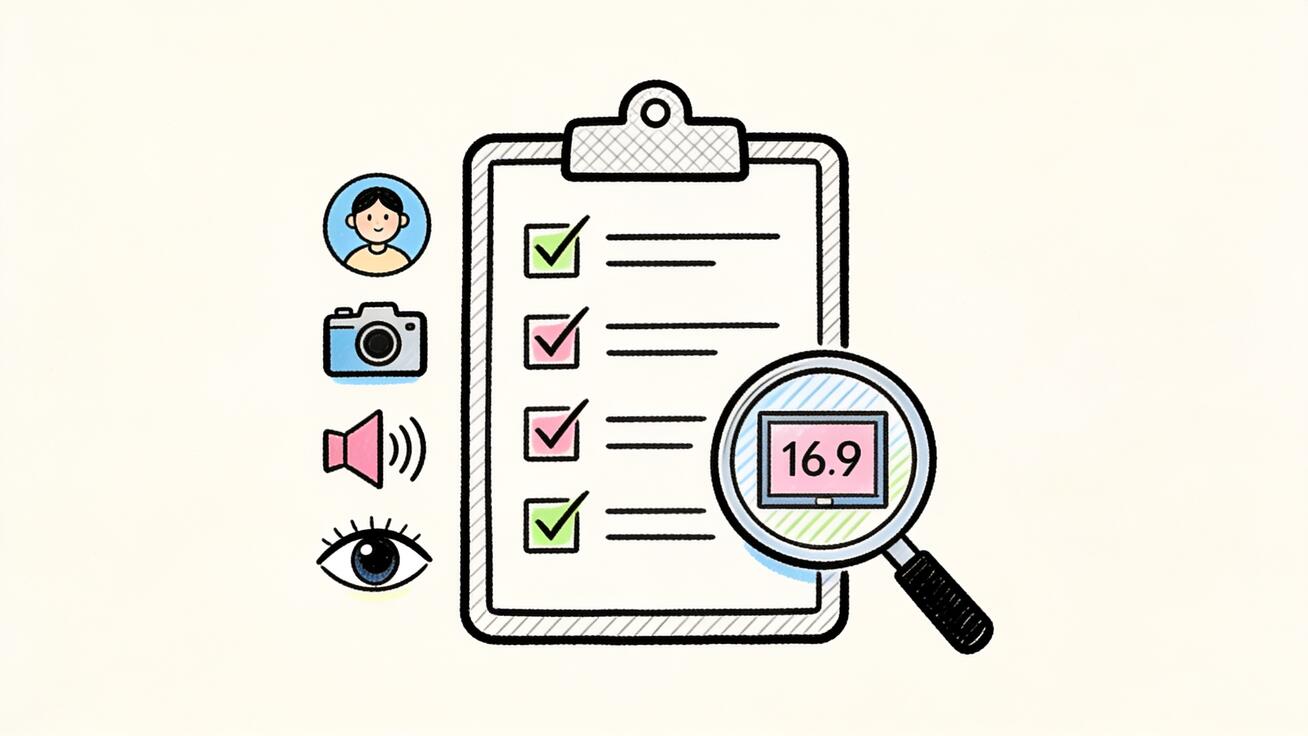
故障排查与 QA 核查清单
多数“质量不佳”的 AI 视频并非模型失效所致,而是提示词设计或审核环节存在疏漏。以下是常见问题诊断方法,以及发布前必执行的核查清单。
常见问题与解决方案
- 镜头运动偏离您的意图。 请明确表达,并仅使用一条清晰的运镜指令。“缓慢推进”优于堆砌多种运动描述。若同时指定三项运镜,模型可能将其平均化,导致运动模糊不清。
- 主体在片段中发生变化。 对文生视频任务,请加强文字描述锚点;对图生视频或系列任务,请改用参考图像,并全程复用同一组参考。
- 产品或人脸发生形变。 减少所请求的运动幅度,并明确加入“保持原有形状,禁止形变”等指令。大幅、快速运动最易引发扭曲。
- 动作未按顺序发生。 在提示词中平实陈述动作序列(例如:“她先蒸奶,再倾倒”),为模型提供明确的时间线,以支撑更长片段的逻辑连贯性。
- 音频效果欠佳。 用更直白的语言重写声景提示,或计划在剪辑阶段替换音频。
- 画面显得模糊。 请确认生成分辨率为 4K;对于图生视频,请从您所能获取的最高分辨率源图开始。
发布前 QA 核查清单
每次导出前均须执行以下检查:
- [ ] 完整观看整段视频,从头至尾,而非仅看开头。
- [ ] 角色 / 产品一致性 从第一帧到最后一帧均保持稳定。
- [ ] 镜头运动 与您所要求的一致。
- [ ] 动作序列 按正确顺序发生。
- [ ] 无任何形变 —— 人脸、双手、产品或文字均未失真。
- [ ] 音频同步 —— 开启音频检查;若与最终成片音轨冲突,请及时替换。
- [ ] 分辨率 符合目标平台要求(如用于首屏/大屏展示,则应为 4K)。
- [ ] 品牌安全 —— 画面中未混入任何意外元素或偏离品牌信息的内容。
将 QA 视为必要步骤而非事后补救,方能使输出成果达到可直接发布的可靠水准。
常见问题解答(FAQ)
Seedance 2.5 最长能生成多长的视频?
单次提示可生成一段最长 30 秒的连续视频片段,以一次连贯拍摄方式生成,无需拼接——长度约为当前多数竞品模型单次生成视频长度的两倍。
Seedance 2.5 的输出分辨率为多少?
原生 4K 分辨率,支持 10 位色深,较早期模型的 720p/1080p 有所提升。
Seedance 2.5 是否生成音频?
是。音频与画面同步生成,且在同一次推理过程中共同产出,无需后期单独添加。
图像转视频功能支持上传哪些图片格式?
支持 JPG、PNG 和 WEBP 格式,单文件大小不超过 10MB,最小宽高均为 300 像素。
我何时可以使用 Seedance 2.5?
Seedance 2.5 于 2026 年 7 月 31 日正式发布。首发采用平台分阶段上线策略,因此当前可用性仍因产品、地区及账户而异;在围绕该模型规划完整营销工作流前,请务必查看 Seedance 模型选择器。
Seedance 2.5 与 Seedance 2 Mini 有何区别?
完整版 2.5 模型专为长时长、4K 分辨率与高保真度而设计。Seedance 2 Mini 则是轻量、快速的选项:每秒消耗 3 点积分,生成 4–15 秒片段,输出分辨率为 480p 或 720p,并内置音频。旗舰级内容请使用完整模型,高频短片则推荐使用 Mini 版本。
结论
掌握 Seedance 2.5 的使用方法,关键在于养成三个习惯:撰写提示词时聚焦于引导完整场景,而非仅命名某个瞬间;在需要保持一致性时,始终使用参考图像;发布前务必执行一次真实的 QA 推理验证。该模型可一次性输出一段 30 秒的连续视频,分辨率为 4K,并自带同步音频——但这一能力只有在提示词足够具体、足以填满全部时长,且审核足够严格、足以发现瑕疵时,才能真正发挥价值。建议从一个文生视频和一个图生视频开始尝试,对比两种模式在您提示词下的实际表现,再逐步深入。准备就绪后,请访问 Seedance 2.5 模型页面,生成您的首个视频片段。
VEED 自动字幕免费版:一份可直接发布的字幕实用指南
在免费计划中使用 VEED 自动字幕,校正字幕时间轴与样式,了解水印及 SRT 文件限制,并借助 Seedance 准备支持字幕的视频。
阅读文章
Firefly 视频透明背景教程:生成、导出与合成干净的叠加层
在 Adobe Firefly 中生成带透明背景的视频,理解其前景文件与 Alpha 通道文件,测试边缘质量,并合成可用的叠加层。
阅读文章
Firefly 相机运动参考教程:拍摄、上传并审阅五秒运动
学习如何为 Adobe Firefly 视频准备一段简短的相机运动参考,上传该参考,编写聚焦明确的提示词,并在交付前检查生成的运动效果。
阅读文章