AI 视频通常能很好地处理一个可见动作,但当提示要求执行五个步骤时便容易丢失情节逻辑:主体可能在拿起水壶前就已开始倒水,物体可能在步骤间重置,或整个视频时长都停留在起始姿态上。可靠的解决方法是将想法转化为可观测的状态变化,为每个动作分配充足的屏幕时间,并在单个视频片段无法清晰承载全部步骤时将其拆分为多个片段。
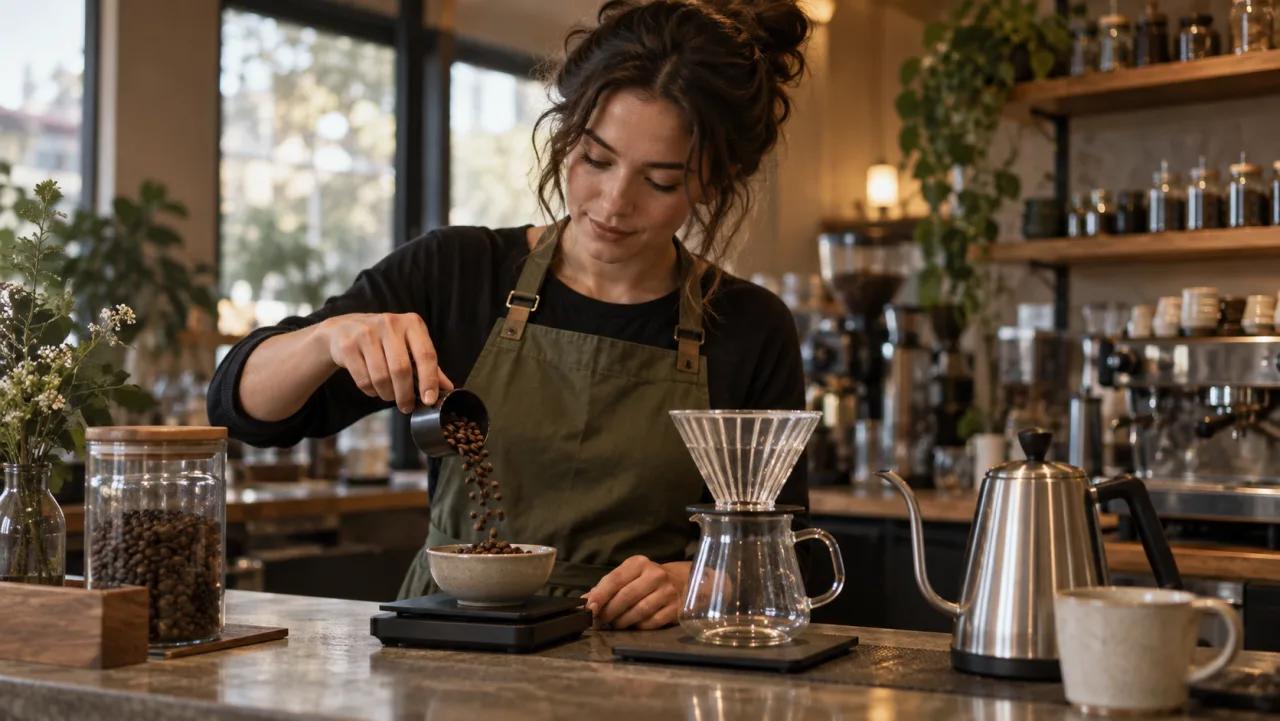
本指南介绍如何让 AI 视频遵循多步骤动作,而不将提示当作剧本处理。示例场景为一位咖啡师:称量咖啡豆、注水萃取、移除滤杯、呈递完成的咖啡杯。该方法同样适用于装配演示、食谱教学、产品使用说明、手工艺教程及简短叙事片段。
AI Overview
如何让 AI 视频按顺序执行各步骤?
将每一步写作一个可见的物理动作,明确定义其前后状态,并用明确的顺序词(如“首先”“接着”)或时间戳连接各动作。确保整个序列长度适配视频片段时长。
多步骤动作是否应在单个片段中生成?
若两至三个动作紧密关联且能自然容纳于时长内,可用单个片段;否则,对更长、更精细或涉及显著状态变化的序列,应拆分为独立镜头,并将上一镜头最终被接受的帧作为下一镜头的起始帧。
为何模型会跳过中间动作?
提示中动作数量可能超出可用秒数,或中间状态在视觉上不够明确。请为该步骤指定具体的物体交互、分配更多时间,并明确呈现其结果。
如何保持主体与物体的一致性?
锁定参考图像、服饰、道具、摄像机位置、布光及起始状态;当下一镜头必须严格承接上一镜头结束画面时,复用已被接受的边界帧。
定义原子级步骤与状态
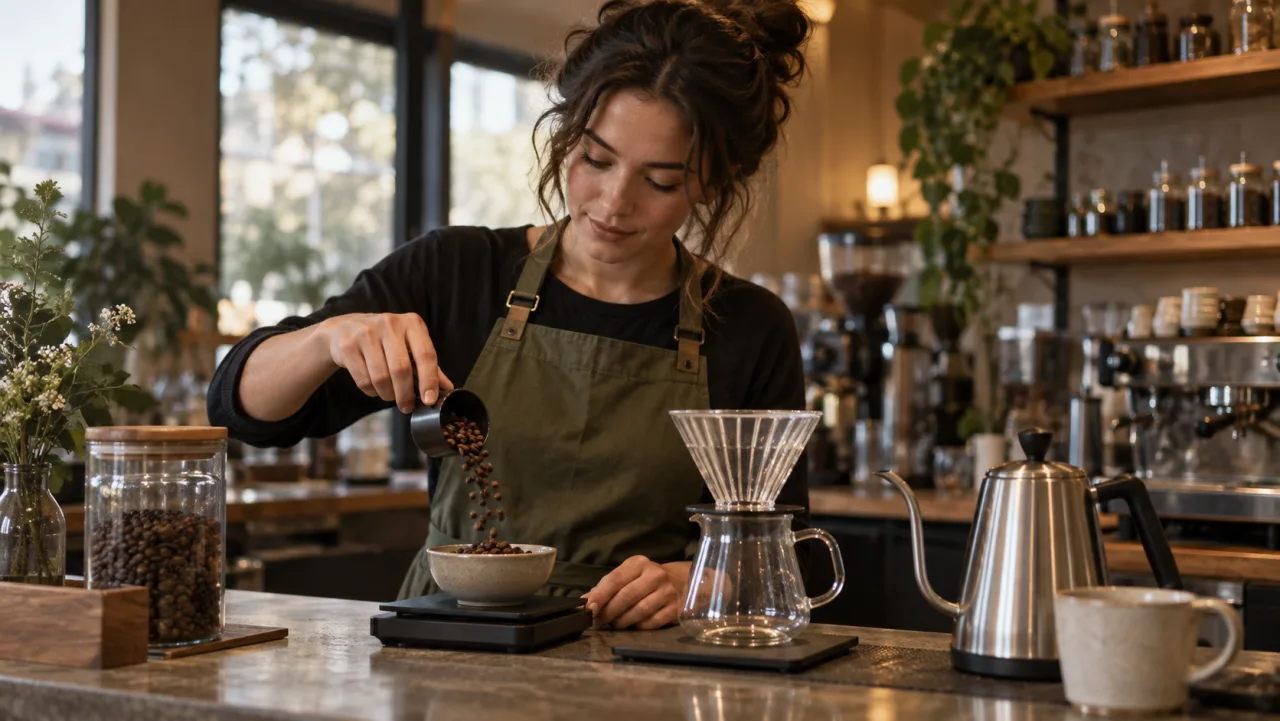
从通俗语言描述的目标出发,将其精简为摄像机可捕捉的动作。“制作咖啡”不是可执行的动作方案,“她将咖啡豆倒入磨豆机”才是。避免在单句中混入意图、情绪、镜头运动及多个物体状态变化。每句话应仅含一个主体、一个动词、一个宾语和一个可见结果。
编写提示前,先创建状态转换工作表:
| 步骤 | 起始状态 | 可见动作 | 结束状态 | 连贯性锁定项 |
|---|---|---|---|---|
| 1 | 咖啡豆在量勺中;磨豆机空置 | 咖啡师将豆子倒入磨豆机 | 量勺清空;豆子进入磨豆机 | 同一件围裙、操作台、杯子 |
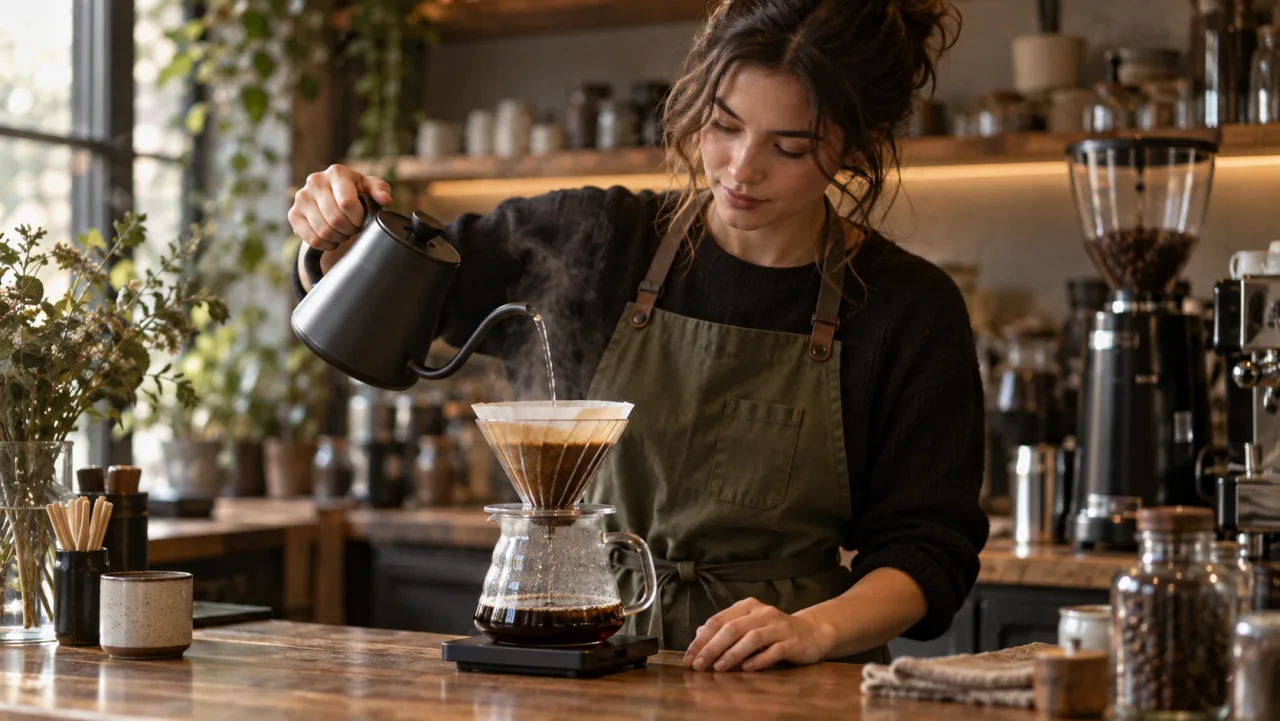
| 2 | 水壶抬起;咖啡粉床干燥 | 咖啡师以缓慢圆周方式注水 | 咖啡粉床鼓胀(闷蒸) | 同一只手、同一水壶、相同机位 |
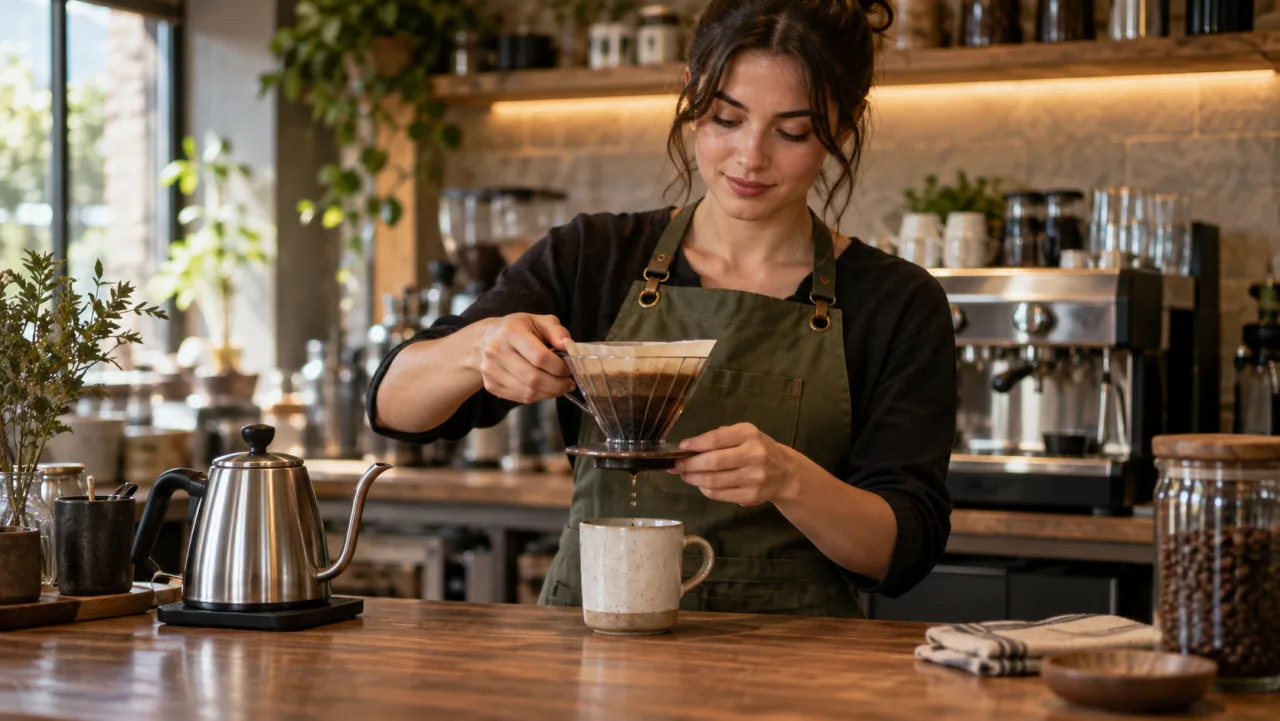
| 3 | 注水完成;滤杯置于分享壶上 | 咖啡师放下水壶并提起滤杯 | 已萃取完成的咖啡杯就绪 | 液面高度与道具位置不变 |
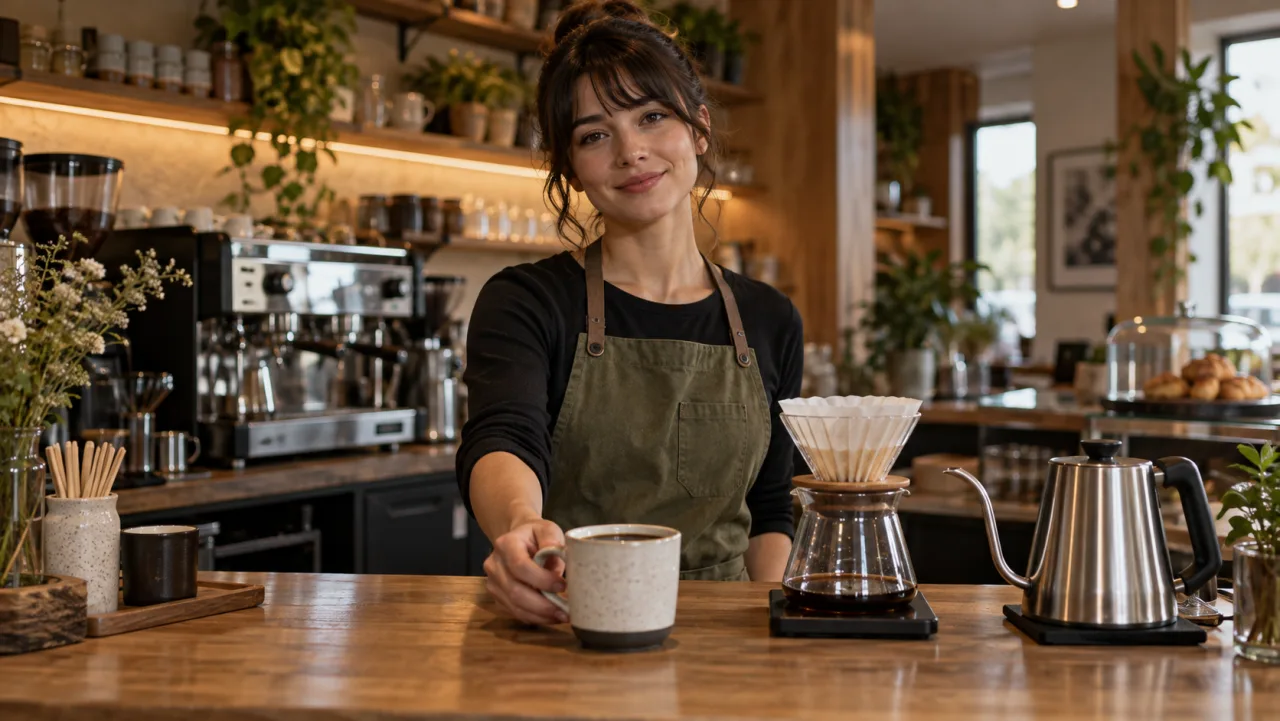
| 4 | 杯子置于操作台上 | 咖啡师将杯子向前滑出 | 成品咖啡杯呈递到位 | 光线与背景一致 |
结束状态与动作本身同等重要——它告诉生成器:下一动作开始时,哪些要素必须保持不变。若盘子、工具、衣物或产品发生朝向变化,请明确记录该结果。这种严谨性亦能提升基础的 文生视频工作流 效果,因提示描述的是可验证的视觉证据,而非模糊意图。
将动作适配可用时长
当动作预算超出时间预算时,序列即告失败。需为预判、执行与稳定收尾预留时间:手须先伸向水壶才能开始倒水;水壶须完全停止后才可放下。这些过渡节奏虽短,却可防止物体“瞬移”。
五秒片段建议仅包含一个主动作,或两个简单关联动作;八至十秒内,若摄像机保持稳定且物体清晰易辨,可容纳两至三个动作;四个审慎设计的步骤通常需分镜呈现。快切蒙太奇可展示更多事件,但无法证明单次连续动作已完整执行。
仅在简化序列后才粗略分配时间段。例如:0–2 秒,提起水壶;2–6 秒,以缓慢圆周方式注水;6–8 秒,将水壶放回操作台。结尾须呈现干净的静止状态。精确时间戳仅为指导性参考,非逐帧剪辑指令,因此应以可视化的动作顺序为准,而非数字本身。
若时长固定,优先移除装饰性运动:镜头环绕、飘散蒸汽、背景顾客走动及复杂手势均会挤占运动容量。首次成功生成时保持摄像机锁定;待动作顺序稳定后,再谨慎添加小幅推进镜头。
构建顺序化动作提示词
先一次性描述稳定场景,再按序列出动作,最后说明摄像机与画质约束。此举确保提示词可读性强,并避免冗长风格前置描述掩盖核心任务。
使用以下可直接复制的模板:
[主体及固定外观] 位于 [稳定环境] 中。
起始状态:[手、工具及物体的位置]。
首先,[一个可见动作及其结果]。
接着,[一个可见动作及其结果]。
最后,[一个可见动作及最终静止状态]。
所有动作须严格按此顺序发生,具备自然的手部接触,且无任何物体重置。
[摄像机构图与运动方式]。[布光与视觉风格]。
```咖啡特写镜头:“一位身穿橄榄色围裙的咖啡师站在木质咖啡吧台后。起始状态:她的右手持鹅颈壶,悬于干燥的咖啡粉床正上方。首先,她开始缓慢画圆注水;接着,咖啡粉‘绽放’,她继续以受控方式保持圆形注水;最后,她停止注水,并将鹅颈壶置于操作台面。所有动作须严格按此顺序发生。固定中景构图,暖调自然窗光。”
正面描述通常比冗长的禁令列表更有效。例如,应表述为“杯体始终位于分享壶左侧”,而非仅依赖“不要移动杯子”。若起始构图至关重要,可先使用[image-to-video](/zh/image-to-video),并选取一张已包含全部关键道具的参考图。
## 生成单个镜头,或拆分为多个片段
当同一主体在固定位置执行连续动作,且摄像机可完整捕捉全部结果时,宜生成单个镜头。若出现物体形态变化、主体位移、新工具介入,或某一步骤反复消失,则应将序列拆分。
一个实用的判断规则很简单:若无法用三个动词加一个稳定起始画面来描述整个序列,则需使用多个镜头。例如,镜头一可在鹅颈壶静置台面时结束;镜头二则从此被接受的终帧开始,展示滤杯被取下。此举既减轻每次生成的负担,又维持了整体工作流的连贯观感。
切勿反复重试一个负载过重的提示词。若连续两至三次均缺失同一关键步骤,应缩短单次生成单元。当工具支持显式视觉关键帧时,可参考[Pika 多关键帧教程](/zh/blog/pika-multiple-keyframe-video-tutorial);如需更广义的身份与环境一致性控制,则参阅[AI 视频一致性指南](/zh/blog/best-ai-video-generator-for-consistency)。
## 在各步骤间保持连贯性
片段之间的边界,恰是多步骤工作流最易断裂之处。仅当双手、道具及主体均处于中性、可辨识的状态时,才保存最后一帧。含运动模糊、工具半遮挡,或手指横跨物体的画面,会使后续生成面临几何结构不确定的风险。
需将五项锁定要素带入下一镜头:主体身份、服饰、核心道具、环境及摄像机朝向。同时明确注明允许变动的变量。在本咖啡示例中,液面高度可上升,但杯型设计、围裙、台面及光线方向必须保持恒定。
若采用边界帧作为输入,应在提示词中将其描述为起始状态,而非重复前序全部动作。下一提示词应写作:“鹅颈壶静置于台面右侧,注满液体的滤杯仍悬于分享壶上方;咖啡师垂直向上提起滤杯。”重复描述注水过程,会诱使模型重新启动该动作。
本真实 Seedance 示例作为独立运动参考,用于评估接触点、摄像机稳定性及动作沉降效果。它并非证明该咖啡序列曾一次性生成成功。
```official-video
src=https://r2.seedance.tv/blog/runway-failed-generation-credits-refund/seedance-coffee-motion-control-v1.mp4
poster=https://r2.seedance.tv/blog/runway-failed-generation-credits-refund/seedance-coffee-motion-control-poster-v1.jpg
label=Seedance motion-control reference for action review
审查与修复序列
先以正常速度通览全片,确认动作顺序正确,且每步均达成其目标状态;再逐帧检查手部接触点及镜头切换处。即使成片赏心悦目,只要盖子在手触碰前开启,或盛满容器突然变空,即属失败。
使用精简版验收清单:
- 所有必需动作各出现一次,且顺序无误;
- 起始与结束状态视觉上清晰可辨;
- 手部准确接触目标物体,无融合或左右侧误换;
- 道具不消失、不复制、不重置、不变更设计;
- 摄像机朝向与主体在画面中的位置保持一致;
- 终帧可作为干净交接点或剪辑点使用。
仅修复最小故障单元。若第二步缺失,可为其分配更多时长,或单独拆为新镜头;若身份一致性偏移,应强化参考并减少摄像机运动;若物体发生形变,应选取更明确的边界帧并重述其几何状态;若剪辑过渡生硬,可添加半秒沉降姿态,而非整段重生成。
Seedance Agent 在需多次生成的任务中尤为实用:它能统一管理状态工作表、参考图、镜头顺序、审查笔记及定向重试。这使得审批聚焦于可观测的过渡效果,而非仅凭某段美观片段是否“感觉对劲”来判断。
结论
要让 AI 视频精准遵循多步骤动作,需将创意转化为原子级动词,明确定义每个起始与结束状态,依据片段时长合理分配各动作,且在序列过载前主动拆分。通过干净的边界帧、稳定的视觉锁定要素,以及侧重顺序验证(而非仅风格判断)的审查清单,确保连贯性。当你准备规划、生成、比对与修复更长的动作链时,请在Seedance Agent 中构建完整工作流。
title: How to Make AI Video Follow a Multi-Step Action
description: A practical guide to generating consistent, multi-step AI video sequences—using atomic verbs, clean boundary frames, and targeted review.
tags: ai video, motion control, multi-step workflow, consistency, prompt engineering