
MiniMax H3 Непрерывный рабочий процесс говорящего аватара: сохранение одного лица и голоса в разных клипах

AI Overview
Может ли MiniMax H3 создать один непрерывный видеоролик с говорящим аватаром?
Да, однако длительный результат следует планировать как несколько утверждённых фрагментов, а не как одну неограниченную генерацию. H3 выводит фрагменты продолжительностью от 4 до 15 секунд, поэтому разбейте сценарий на естественные паузы и объедините сегменты, имеющие одинаковое лицо, голос, кадрирование и фоновый шум помещения.
Как сохранить одинаковую идентичность аватара в каждом сегменте?
Используйте одну чистую референсную картинку идентичности, повторяйте одни и те же видимые черты, присвойте одному динамическому спикеру стабильный идентификатор, например S1, и начинайте каждый продолжаемый сегмент с утверждённого нейтрального граничного кадра. Меняйте только реплики и минимально необходимые жесты.
Что делает переходы между фрагментами с говорящим аватаром незаметными?
Завершайте каждый сегмент после полного предложения с закрытым ртом, устойчивым направлением взгляда, спокойными руками и коротким «хвостом» фонового шума помещения. Начинайте следующий сегмент из того же состояния, затем скрывайте стык под естественной паузой или сдержанной отсечкой (cutaway).
Как предотвратить дрейф синхронизации губ?
Сделайте каждый произносимый блок достаточно коротким для одного вдоха, точно запишите реплики внутри тега <d>, и избегайте конкурирующих движений лица или камеры. Перед утверждением сегмента просмотрите анимацию рта в нормальном темпе и по кадрам.
Планирование непрерывного аватара как коротких утверждённых сегментов
Создание основного ролика из фрагментов, соответствующих одному вдоху
Рабочий процесс непрерывного говорящего аватара MiniMax H3 — это производственный план, а не запрос на неограниченную продолжительность. Официальные инструменты H3 принимают целочисленные значения продолжительности от 4 до 15 секунд. Рассматривайте этот верхний предел как творческое ограничение: каждый фрагмент должен содержать одну завершённую идею, один умеренный жест и одно чистое конечное состояние. Объяснение продолжительностью 45 секунд может быть разбито на четыре сегмента по 10–13 секунд, а не на три фрагмента, вынужденно растянутых до предела.
Разметьте сценарий до начала генерации. Хорошие точки разрыва следуют за знаками препинания, естественным вдохом или сменой темы. Плохие точки разрыва разделяют имя, число или эмоционально связанные фразы. Прочитайте вслух каждый сегмент, используя таймер, и зарезервируйте примерно по одной секунде на начальное «оседание» и финальное удержание. Если реплика уже занимает всю отведённую продолжительность, сократите текст, а не требуйте от модели ускорения.
| Сегмент | Произносимая задача | Целевое действие | Требуемое конечное состояние |
|---|---|---|---|
| A | Введение темы | Небольшой жест открытой ладонью | Рот закрыт, руки опускаются |
| B | Объяснение ключевой мысли | Умеренный жест указательным пальцем | Сохранение того же направления взгляда, руки на столе |
| C | Приведение примера | Краткий кивок, без движения камеры | Нейтральное выражение лица и фоновый шум помещения |
| D | Формулировка призыва к действию (CTA) | Лёгкий наклон вперёд, затем оседание | Удержание на два такта для монтажа |
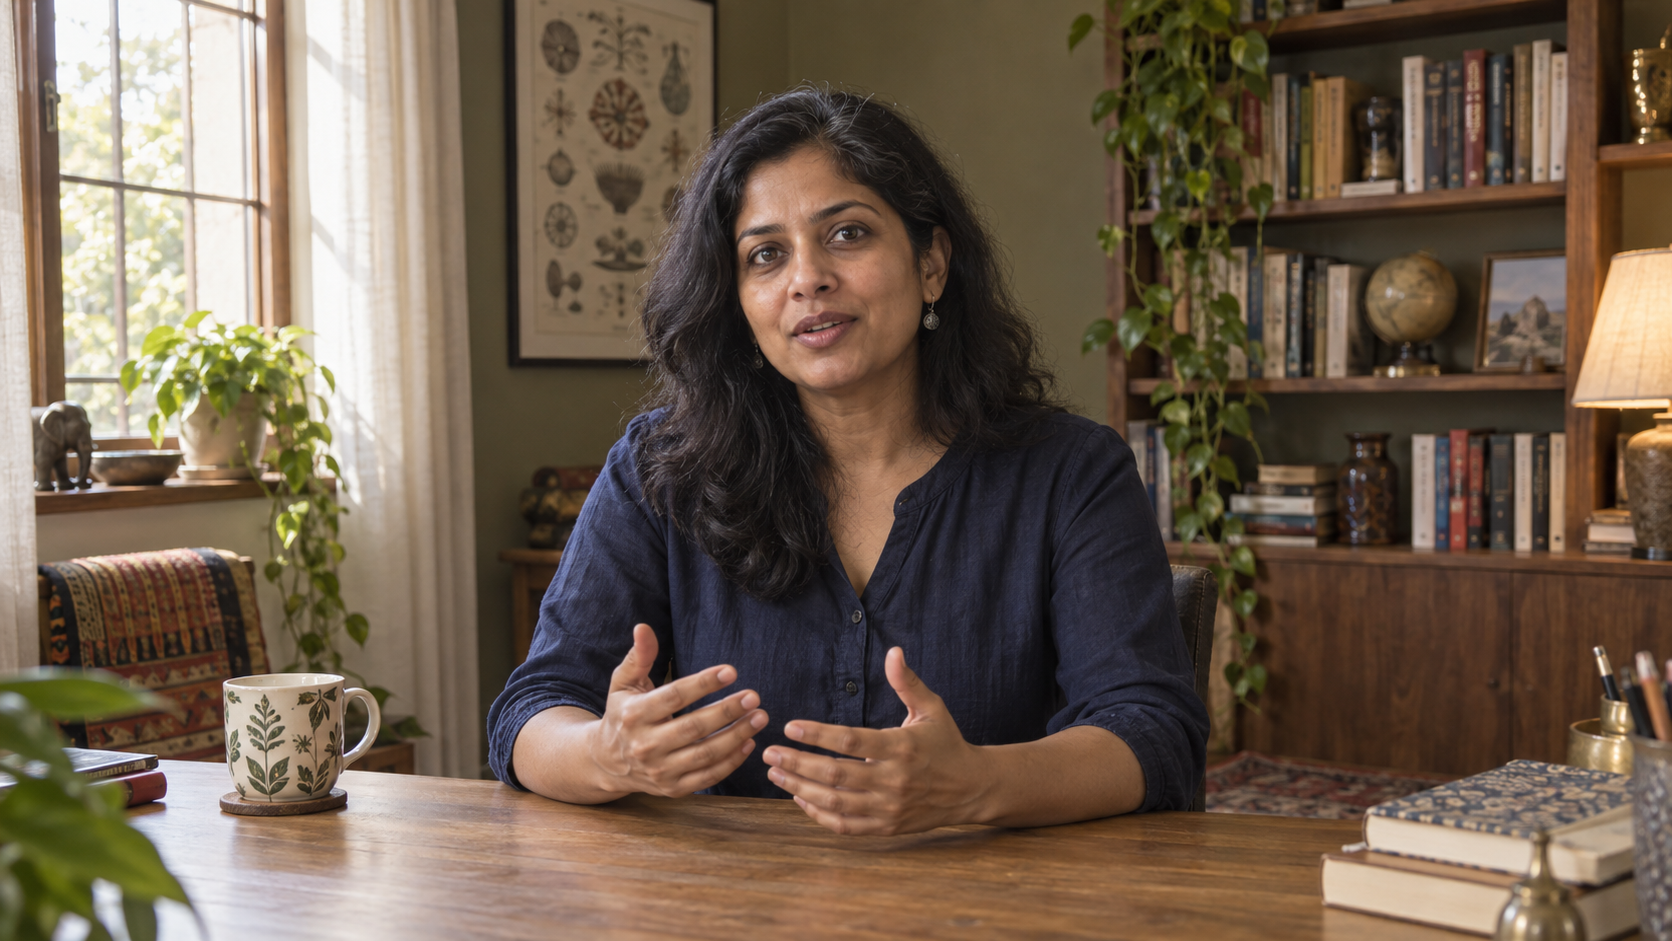
Иллюстративный сгенерированный кадр, не являющийся результатом работы MiniMax H3: среднее кадрирование, видимые руки, простой гардероб и стабильный фон обеспечивают большую преемственность последовательности речи, чем тесный портрет «красоты».
Такое сегментирование также делает восстановление экономически выгодным. Если в сегменте C форма рта получилась слабой, перегенерируйте только C, а не рискуйте уже утверждённым материалом из других сегментов. Та же логика контрольных точек, описанная в возобновляемом многосегментном рабочем процессе, применима и здесь: сохраняйте версию сценария, набор референсов, промпт, выходные данные и утверждённый граничный кадр для каждого сегмента.
Подготовка лица, голоса, сценария и кадра
Создание одного компактного пакета преемственности
Выберите референсное изображение с чётко различимым лицом, расслабленными губами, незагромождённым фоном и тем же углом камеры, который требуется для готового видео. Среднее или среднее крупное кадрирование обычно безопаснее широкого плана, поскольку рот остаётся достаточно крупным для детальной проверки. Уберите волосы с губ, избегайте положения рук, перекрывающего нижнюю часть лица, и используйте мягкое направленное освещение вместо резких подвижных теней.
Создайте фиксированный блок идентичности и используйте его дословно во всех сегментах. Включите возрастной диапазон, причёску, гардероб, характерную, но обычную черту, тембр голоса, темп речи, акцент — только если он важен, высоту расположения камеры, размер кадра, направление света и якорные элементы фона. Не добавляйте новые прилагательные в последующих сегментах: даже безобидные на первый взгляд уточнения могут изменить стиль, возраст или пропорции лица.
Для генерации на основе референса H3 может использовать изображения, видео и аудиофайлы. В официальном руководстве по полному референсу H3 различаются видимые субъекты, конкретные визуальные якоря, исходные видео и аудиореференсы. Когда аудиореференс задаёт характер голоса, а не копируемый сигнал, описывайте его как референс тембра и манеры речи. Прикрепляйте один и тот же идентификатор спикера к аватару везде, где она фактически говорит.
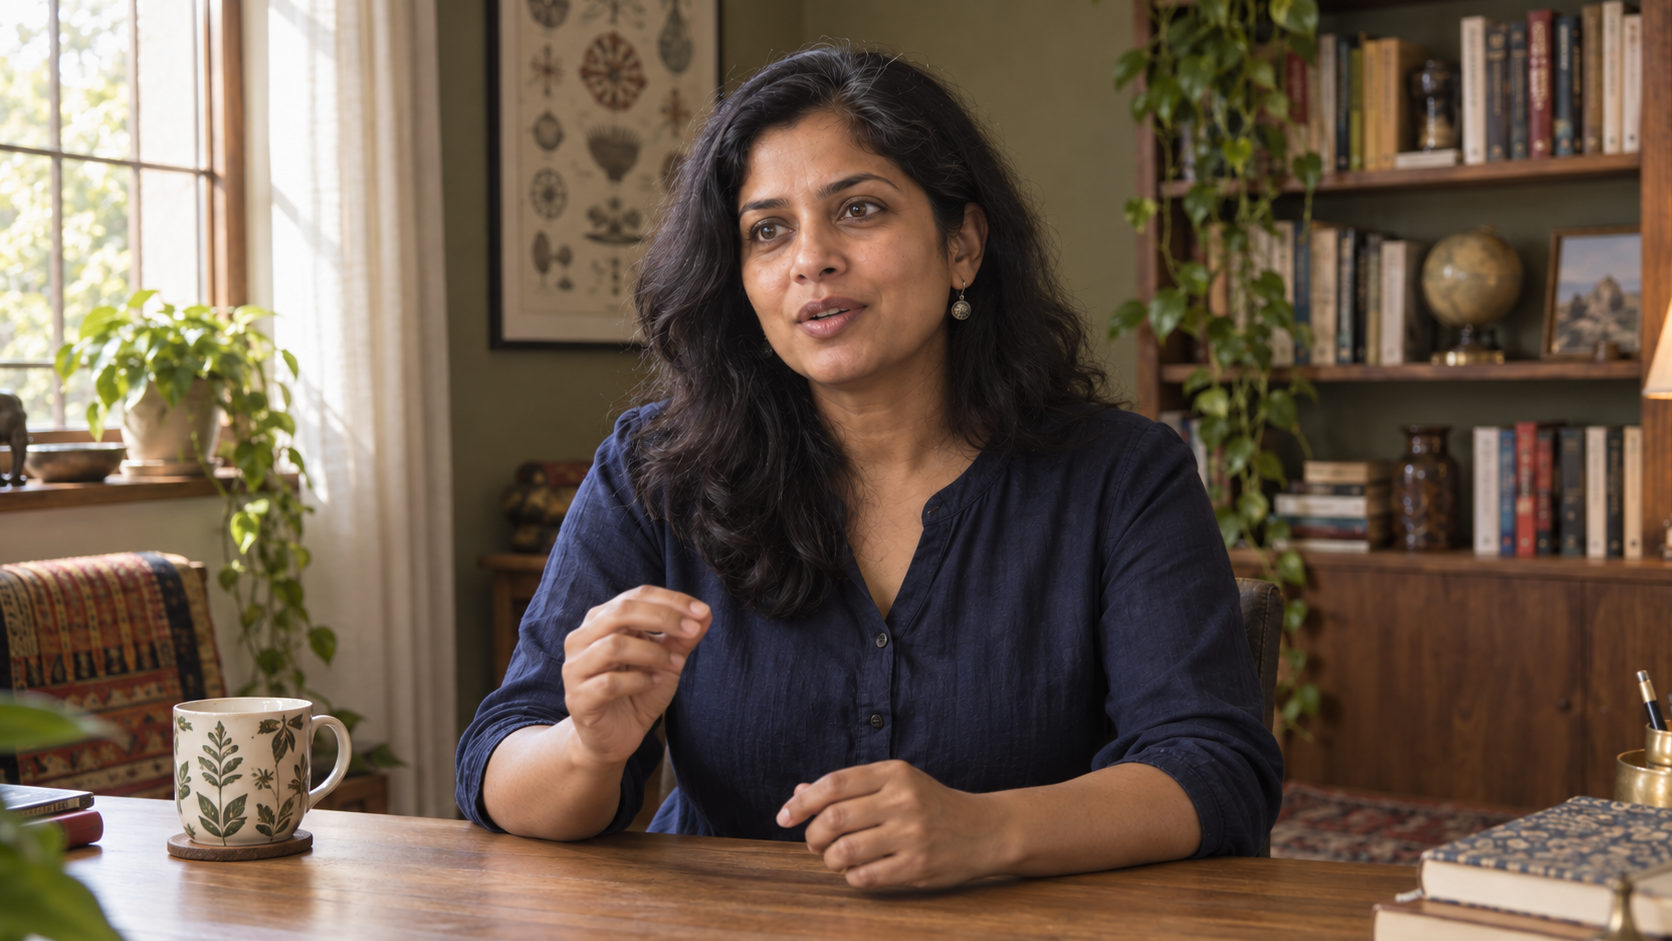
Цель преемственности для речевого сегмента: идентичность, объектив, направление взгляда, гардероб и освещение остаются неизменными, меняются только форма рта и один небольшой жест.
Запишите чистую речь, если вам нужен конкретный голос. Используйте тихое помещение, постоянное расстояние микрофона, отсутствие фоновой музыки и отдельные файлы для каждого сегмента. Выровняйте громкость и фоновый шум помещения перед генерацией. Если цель — просто правдоподобный родной голос, укажите стабильный тембр и темп, но всё равно сохраняйте точные слова в промпте. В руководстве по согласованности голосов приведён полезный чек-лист для прослушивания, который также применим при проверке выходных данных H3.
Написание реплик для H3 без потери идентичности спикера
Сохраняйте визуальное направление вне тега диалога
Официальное базовое руководство H3 использует стабильные идентификаторы дикторов, например (S1), и помещает внутрь тега <d> только те слова, которые должны быть произнесены. Идентифицирующая фраза, действие, манера подачи и идентификатор диктора остаются за пределами тега. Такое разделение предотвращает превращение примечаний по исполнению в случайный диалог.
[Кадр 1] Реалистичный средний план того же научного просветителя, сидящего за дубовым письменным столом. Положение камеры, объектив, направление освещения, одежда, книги, растения и чашка остаются неизменными. Спокойная взрослая женщина (S1), обладающая тёплым голосом средней и низкой частоты, умеренным темпом речи и чёткой дикцией, смотрит прямо в сторону объектива. Она делает один небольшой жест открытой ладонью и говорит: <d>[Английский] Стабильный аватар начинается со стабильной передачи между каждым одобренным клипом.</d> После окончания фразы её губы смыкаются, руки возвращаются на стол, и она сохраняет тот же взгляд в течение одной секунды. Тихий фоновый шум помещения продолжается. Без музыки, без движения камеры, без текстовых наложений.
Повторяйте идентифицирующую фразу каждый раз, когда при новой генерации существует риск забыть, кем является S1. Не создавайте новый номер диктора для того же аватара в следующем клипе. Если вводится другой голос, назначьте ему S2 один раз и чётко сохраните распределение ролей. Для объяснительного видео с одним диктором исключение других слышимых голосов устраняет ненужный источник дрейфа.
Записывайте одну произносимую часть речи на одно видимое действие. Быстрые повороты головы, широкие движения рук, приближение камеры и длинные предложения конкурируют за один и тот же короткий интервал. Когда важна точность движений губ, зафиксируйте положение камеры и сохраняйте неподвижность корпуса. Используйте практические элементы управления выражением лица из руководства по микровыражениям H3, чтобы запросить сдержанное приподнимание бровей или кивок без изменения всего лица.
Поддерживайте «якорное» состояние через каждый монтажный переход
Завершайте кадр чисто, прежде чем переходить к началу следующего
Последняя секунда одного клипа становится визуальным обязательством для следующего. Запросите фиксированное конечное состояние: губы сомкнуты, челюсть расслаблена, взгляд направлен на ту же метку, руки находятся в оговорённом положении, плечи на одном уровне, объекты фона не изменены. Экспортируйте это одобренное завершение как якорное изображение для следующего кадра, если используемый способ генерации это позволяет. Нейтральная пауза более универсальна, чем кадр, захваченный посреди слова.
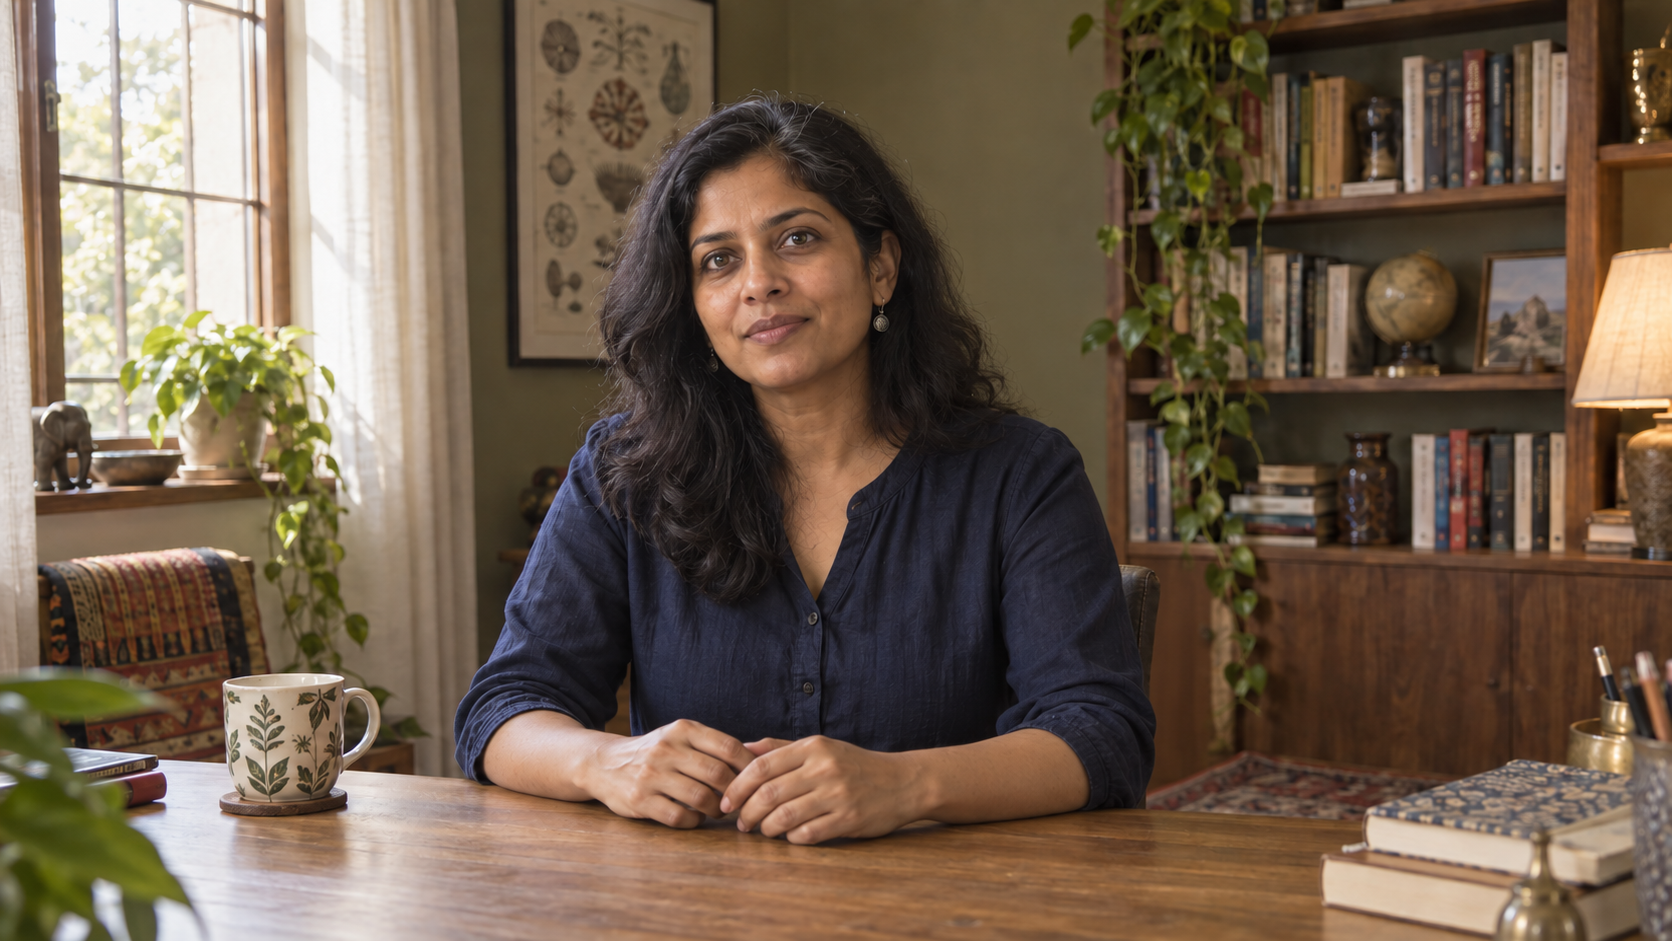
Полезный граничный кадр намеренно лишён событий: рот закрыт, взгляд и поза стабилизированы, никакой жест не должен «волшебным образом» продолжаться через монтажный переход.
В начале сегмента B повторно укажите зафиксированное состояние до начала нового действия. Сохраните размер головы, высоту расположения камеры, линию взгляда, направление освещения, положение рукавов и местоположение контрастных объектов фона. Первое движение должно начаться после краткой стабилизации, а не на первом кадре. Если следующий клип начинается с иной позы, зритель замечает скачок ещё до того, как услышит речь.
H3 поддерживает режимы «первый/последний кадр» и «опорный кадр», но используйте только тот режим, который соответствует задаче. Конкретное граничное изображение — это якорный кадр; аудиофрагмент может задать тембр; предыдущее видео может обеспечить контекст движения или продолжения. Большее количество опорных материалов не означает автоматически лучший результат. Удалите любой ресурс, противоречащий утверждённому кадрированию, гардеробу или голосу.
Метод передачи тесно связан с планированием по нескольким ключевым кадрам, однако для говорящего аватара требуется меньше визуальных амбиций. Один стабильный якорь на границу обычно эффективнее плотного сториборда, требующего одновременного изменения лица, рук, камеры и комнаты.
Собирайте сегменты без слышимых или визуальных скачков
Делайте монтаж на паузе и сохраняйте фоновый шум помещения
Разместите каждый одобренный клип на единой временной шкале в порядке следования по сценарию. Обрежьте дублирующиеся кадры стабилизации, но оставьте достаточно нейтрального материала, чтобы сместить монтажный переход от кадра с открытым ртом. Сначала согласуйте масштаб и положение, а затем добавляйте переходы. Прямой монтаж во время естественной паузы обычно выглядит чище, чем растворение, которое может на мгновение показать два рта и сделать лицо нестабильным.
Фактический результат Seedance, а не MiniMax H3: используйте этот образец с нативным аудио в качестве эталонного ориентира для оценки синхронизации речи, движений лица и непрерывного фонового шума.
Прослушайте стыки с выключенным изображением. Согласуйте громкость речи, уровень шума, реверберацию и длительность каждого вдоха. Разместите под всей последовательностью короткую непрерывную дорожку фонового шума помещения, чтобы мельчайшие паузы не звучали как внезапное отключение помещения. Избегайте музыки до тех пор, пока не будет достигнута корректная синхронизация речи; саундтрек может скрыть плохой стык при монтаже, но не исправит его.
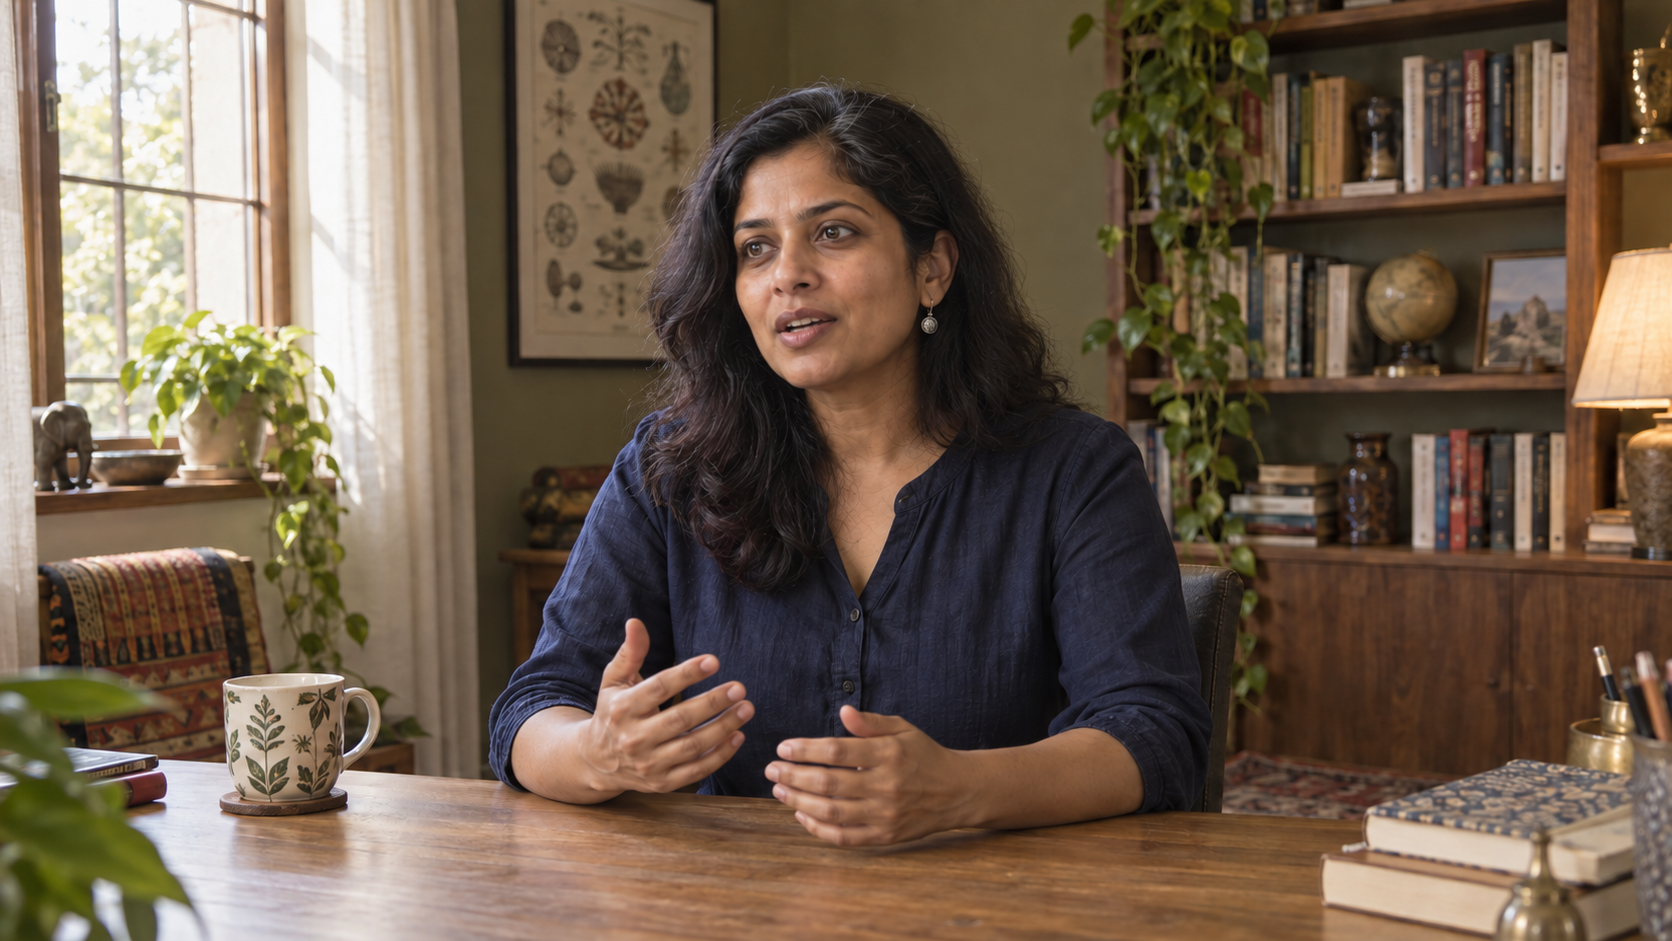
Цель продолжения: личность и визуальные якоря остаются стабильными, а новое предложение начинается с немного иного, но всё ещё правдоподобного жеста рукой.
Если скачок остаётся, используйте релевантный отснятый материал продолжительностью в одну–две секунды: блокнот диктора, предмет, о котором она упоминает, или более широкий план из той же комнаты. Не вставляйте случайные стоковые видеоролики. Отснятый материал должен иллюстрировать или отвечать на произнесённую фразу, а затем возвращать зрителя к тому же состоянию аватара.
Проверяйте ошибки синхронизации губ, голоса и непрерывности
Одобрите каждый клип в пяти отдельных проходах
Сначала просмотрите ролик в обычном темпе, чтобы уловить смысл и естественный ритм. Во-вторых, отключите звук и внимательно изучите соответствие внешности: зубы, губы, челюсть, глаза и руки. В-третьих, прослушайте аудио без визуального сопровождения, обращая внимание на тембр голоса, темп речи, фоновый шум помещения и щелчки. В-четвёртых, пошагово пройдитесь по первым и последним двенадцати кадрам каждого сегмента. В-пятых, просмотрите собранный видеоряд на проигрывателе с размером экрана смартфона — при таком масштабе мельчайшие изменения выражения лица становятся более заметными.
Отклоняйте клип, если рот продолжает двигаться после окончания речи, форма зубов меняется от кадра к кадру, челюсть смещается вбок, цвет глаз изменяется, рука проходит сквозь лицо или голос резко меняет возрастное восприятие или дистанцию. Не пытайтесь исправить нарушение целостности образа за счёт повышения резкости. Пересоздайте только самый маленький сегмент, завершившийся неудачей, начиная с последней одобренной контрольной точки (anchor).
Если несколько сбоев вызваны одной и той же причиной, упростите контент до повторной генерации. Сократите фразу, уберите жест, зафиксируйте положение камеры, увеличьте масштаб лица в кадре или замените неоднозначную опорную информацию. Seedance Agent особенно полезен на этом этапе, поскольку позволяет хранить вместе пакет опорных данных, промпты для сегментов, фактические выходные данные, заметки и точки одобренных повторных запусков. Вы можете сравнить результаты H3 с контролируемым рабочим процессом «опора → видео», вместо того чтобы собирать проект заново из разрозненных файлов.
Заключение
Надёжный непрерывно говорящий аватар MiniMax H3 собирается из коротких, поддающихся проверке речевых сегментов: распределите текст по временным интервалам, сохраняйте единую внешность и определение голоса S1, заключите точные слова в тег <d>, завершайте каждый клип на нейтральной контрольной точке (anchor) и соединяйте одобренные дубли на фоне непрерывного шума помещения. Данный метод не гарантирует бесконечную генерацию; он предоставляет восстанавливаемый способ создания более длинных объяснений без потери соответствия лица, голоса или синхронизации губ. Чтобы спланировать опорные материалы, промпты, выходные данные, одобрения и выборочные повторные запуски в рамках одного производственного цикла, начните проект аватара с говорящим лицом с помощью Seedance Agent.
title: How to Assemble a Reliable Talking Avatar description: A five-step review method and failure-handling protocol for building continuous talking avatars with stable identity, voice, and lip sync. tags:
- avatar
- lip sync
- video generation
- quality control
- Seedance Agent
Готовы попробовать сами?
Примените шаги из этого руководства в Seedance и превратите промпты или изображения в готовые видео за считанные минуты.
Бесплатные кредиты при регистрации. Тарифы от $20 в месяц.
Похожие статьи
Еще материалы на этом же языке, которые стоит прочитать дальше.
Управление фокусным расстоянием камеры MiniMax H3: широкий, нормальный и телескопический ракурсы
Управление видимым ракурсом объектива в MiniMax H3 с помощью размера кадра, расстояния до камеры, языка зума, опорных кадров и повторяемого теста подсказки от 24 мм до 85 мм.
Читать статью
MiniMax H3 Двухперсонажный видеопоток: сохранение ролей, диалогов и движений
Создание двухперсонажной сцены в MiniMax H3 с устойчивыми метками субъектов, читаемой расстановкой персонажей, назначенными репликами, аккуратной передачей реквизита и практичным рабочим процессом проверки на сбои.
Читать статью
Руководство по раннему доступу к Socialive Catalyst: подготовка полезного первого пилотного проекта
Узнайте, кто может получить доступ к Socialive Catalyst, что входит в раннюю бета-версию, какие шаги необходимо предпринять для демонстрации и как протестировать один фирменный корпоративный видеопроцесс с использованием ИИ.
Читать статью