
AI Overview
MiniMax H3으로 한 영상에 두 사람을 생성할 수 있나요?
예. H3은 여러 캐릭터를 배치할 수 있지만, 각 인물은 고유한 정체성, 위치, 동작, 발화 역할을 가져야 합니다. 여러 동시 동작이 혼재된 복잡한 프롬프트보다는, 하나의 상호작용만 포함하는 짧은 장면이 더 신뢰도가 높습니다.
두 캐릭터의 정체성이 바뀌지 않도록 하려면 어떻게 해야 하나요?
Subject 1 및 Subject 2과 같은 안정적인 라벨을 할당하고, 각각 고유한 의상과 화면 내 위치를 부여하며, 반드시 유지되어야 하는 특성만 반복해서 기술하세요. 정체성 정확도가 중요한 경우 별도의 참조 이미지를 사용하세요.
MiniMax H3에서 두 사람 간 대사는 어떻게 작성해야 하나요?
발화자에게 S1 및 S2과 같은 안정적인 ID를 부여하고, 모든 대사 앞에 누가 말하는지 명시하며, 대사 태그 안에는 정확히 발화되는 단어만 포함하세요. 청취자의 입은 닫힌 상태로 유지되도록 지정하세요.
두 캐릭터 장면에 가장 적합한 H3 모드는 무엇인가요?
단순히 창작된 장면의 경우 텍스트 또는 첫 프레임 모드를 사용하고, 하나의 제어된 전환을 원할 때는 첫 프레임 및 마지막 프레임 모드를 사용하세요. 두 사람의 정체성, 동작, 음성 자산을 개별적으로 정의해야 할 경우 전체 참조(Full-reference) 모드를 사용하세요.
두 사람을 위한 적절한 H3 모드 선택하기
가장 엄격한 제약 조건이 입력 모드를 결정하게 하세요
MiniMax H3 두 사람 영상 워크플로는 프롬프트 작성을 시작하기 전에 이미 시작됩니다. 무엇을 통제해야 하는지 먼저 결정하세요. 두 캐릭터 모두 창작 가능할 경우 텍스트-음성-영상 방식으로 충분합니다. 시작 시 구성, 의상, 상대적 위치가 이미 중요할 경우 하나의 첫 프레임이 도움이 됩니다. 한 사람이 다른 사람에게 케이스를 전달하는 것처럼, 특정 종료 상태에 도달해야 하는 단일 상호작용이 필요할 때는 첫 프레임 및 마지막 프레임 모드가 유용합니다.
캐릭터 A와 캐릭터 B가 서로 다른 정체성 이미지에서 유래하거나, 별도의 영상이 신체 동작을 제공하거나, 음성 참조가 중요한 경우에는 전체 참조(Full-reference) 모드가 더 적합합니다. MiniMax은 최대 9개의 참조 이미지, 3개의 영상, 3개의 오디오 클립, 총 12개의 참조 파일을 지원합니다. 참조 오디오는 단독 입력으로 사용할 수 없으며, 반드시 이미지 또는 영상과 함께 제공되어야 합니다. 프레임 제어 작업과 전체 참조 작업을 하나의 요청에 혼합하지 마세요.
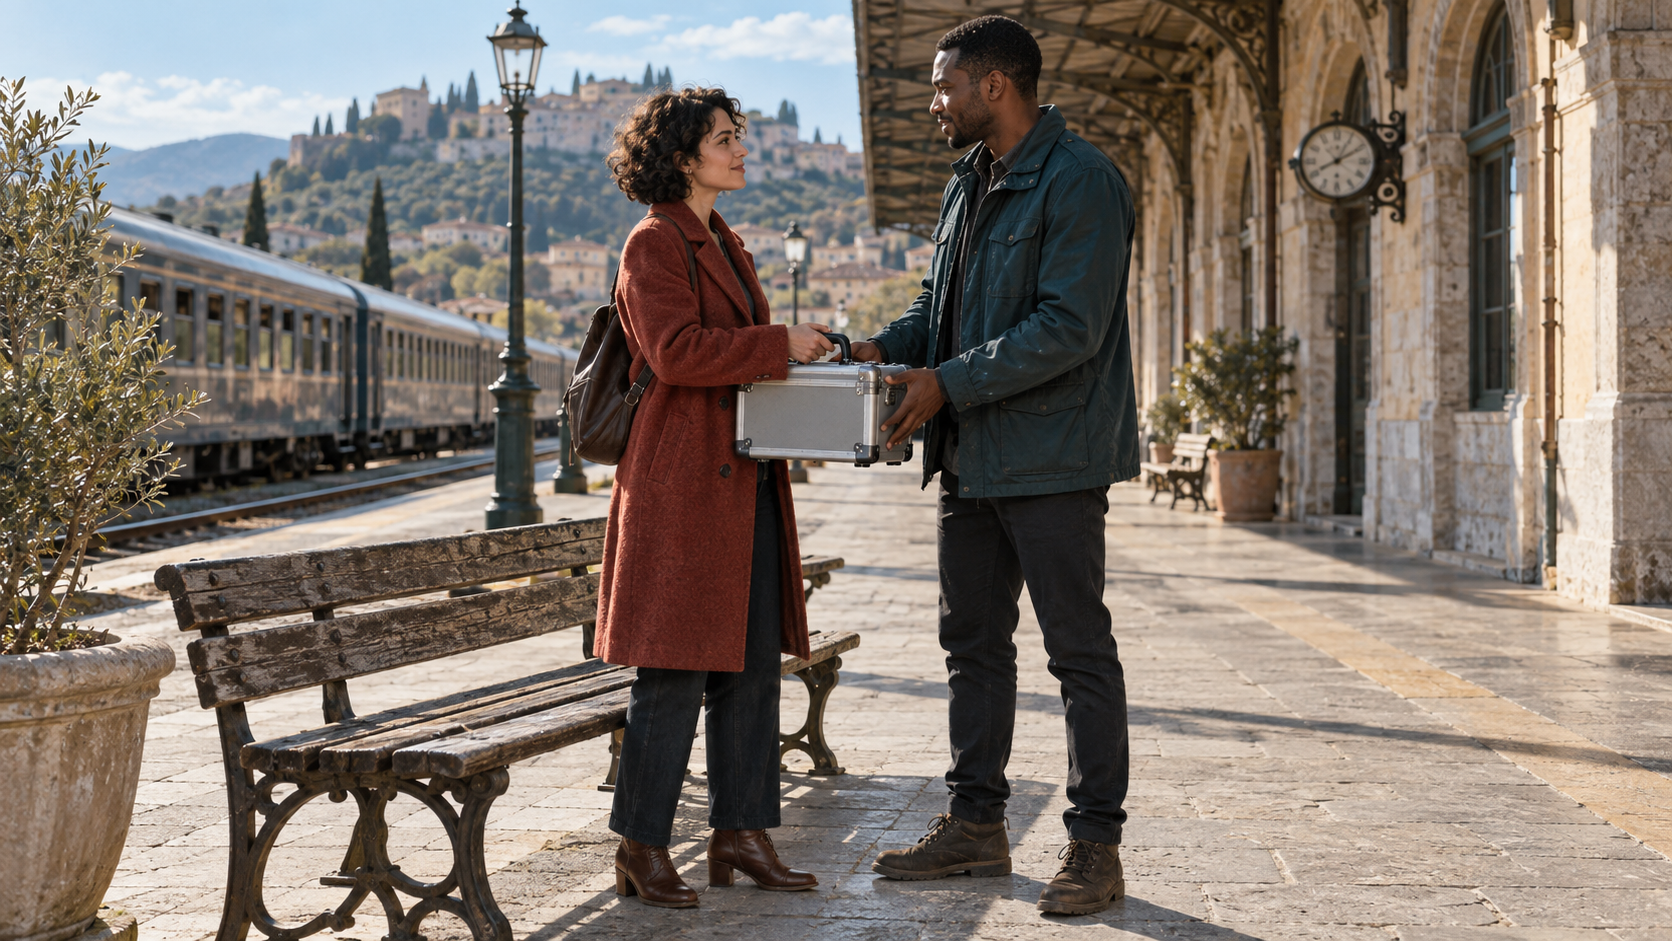
설명용 생성 참조 프레임: 두 가지 구분되는 코트, 별개의 실루엣, 고정된 플랫폼, 하나의 공유 소도구(Prop)가 가독성 높은 연속성 앵커를 제공합니다.
지속 시간(Duration)을 ‘동작 예산’으로 활용하세요. H3은 4–15초를 지원하지만, 15초라고 해서 더 많은 스토리를 집어넣을 수 있는 것은 아닙니다. 두 사람에게 하나의 인과적 동작 단위(Causal beat)만 부여하세요: 접근 → 교환 → 안정; 질문 → 답변 → 반응; 또는 입장 → 인지 → 퇴장. 장면에 두 번째 장소나 또 다른 주요 동작이 필요할 경우, 새 클립을 만들고 재개 가능한 멀티샷(Multishot) 워크플로로 연결하세요.
Subject 1 및 Subject 2 정의하기
간결한 정체성 및 배치(Blocking) 카드 작성하기
타임라인 작성을 시작하기 전에 두 캐릭터를 별도의 제작 기록(Production record)으로 작성하세요. 각 카드는 시각적으로 식별 가능한 정체성, 의상, 초기 위치, 소도구 소유권, 동작 제한, 발화자 ID, 참조 출처를 포함해야 합니다. 차이점은 일瞥으로 쉽게 파악될 수 있어야 하며, “어두운 자켓을 입은 두 사람”과 같은 표현은 모호함을 초래합니다.
| 제어 요소 | Subject 1 | Subject 2 |
|---|---|---|
| 정체성 | 30대 초반 여성, 짧은 검은 곱슬머리 | 30대 중반 남성, 짧게 깎은 머리 |
| 의상 | 녹슨 붉은 양모 코트, 갈색 부츠 | 진한 테일 컬러 필드 재킷, 어두운 부츠 |
| 시작 위치 | 화면 왼쪽, 벤치 옆 | 화면 오른쪽, 역 벽 근처 |
| 소도구 상태 | 케이스 손잡이를 잡음 | 케이스 본체를 받침 |
| 발화자 ID | S1 | S2 |
| 동작 제한 | 한 걸음 앞으로 이동, 손잡이를 놓음 | 케이스를 받아들인 후 한 걸음 뒤로 물러남 |
전체 참조(Full-reference) 모드에서는 각 자산이 어떤 기여를 하는지 명확히 정의하세요. ‘Subject’ 라벨은 재사용 가능한 시각 콘텐츠를 나타내며, ‘Picture’, ‘Video’, ‘Audio’ 라벨은 소스 미디어 또는 구조적 참조를 식별합니다. 첫 번째 이미지에 두 사람이 모두 등장하고 장소까지 포함되어 있다면, 그 전체를 Subject 1이라고 부르지 마세요. Subject 1은 Picture 1의 여성이고 Subject 2는 Picture 2의 남성임을 명시하고, 플랫폼은 반드시 재사용되어야 할 경우에만 별도로 정의하세요.
subject_definitions:
<Subject 1> is the woman from <Picture 1>, preserving her short dark curls, rust-red coat, face, and brown boots.
<Subject 2> is the man from <Picture 2>, preserving his close-cropped hair, deep teal jacket, face, and dark boots.
<Subject 3> is the small silver equipment case shown in <Picture 3>, preserving its size, handle, latches, and brushed-metal finish.
나중 장면에서 얼굴을 다르게 다시 묘사하지 마세요. 안정적인 라벨은 형용사와 참조 간 경쟁을 줄여줍니다. 시점 변경에도 살아남아야 하는 장면 앵커의 경우, MiniMax H3 환경 일관성 가이드에서 건축물, 조명 방향, 가구, 배경 객체를 카탈로그처럼 나열하지 않고도 명명하는 방법을 확인하실 수 있습니다.
상호작용 및 소도구 전달(Prop Handoff) 배치하기
의도가 아닌 상태 변화를 기술하세요
“그들이 케이스를 자연스럽게 교환한다”는 표현은 가장 어려운 프레임을 숨깁니다. 재생 순서대로 객체의 상태를 기술하세요: Subject 1이 손잡이를 소유함; Subject 2가 케이스 아래에 양손을 위치함; 양측이 잠시 케이스를 함께 지지함; Subject 1이 손가락을 펴고 손을 거둠; Subject 2가 케이스를 들고 뒤로 물러남; 양측이 안정됨. 이렇게 하면 모델은 모호한 사회적 행동이 아니라 관찰 가능한 동작 경로를 따르게 됩니다.
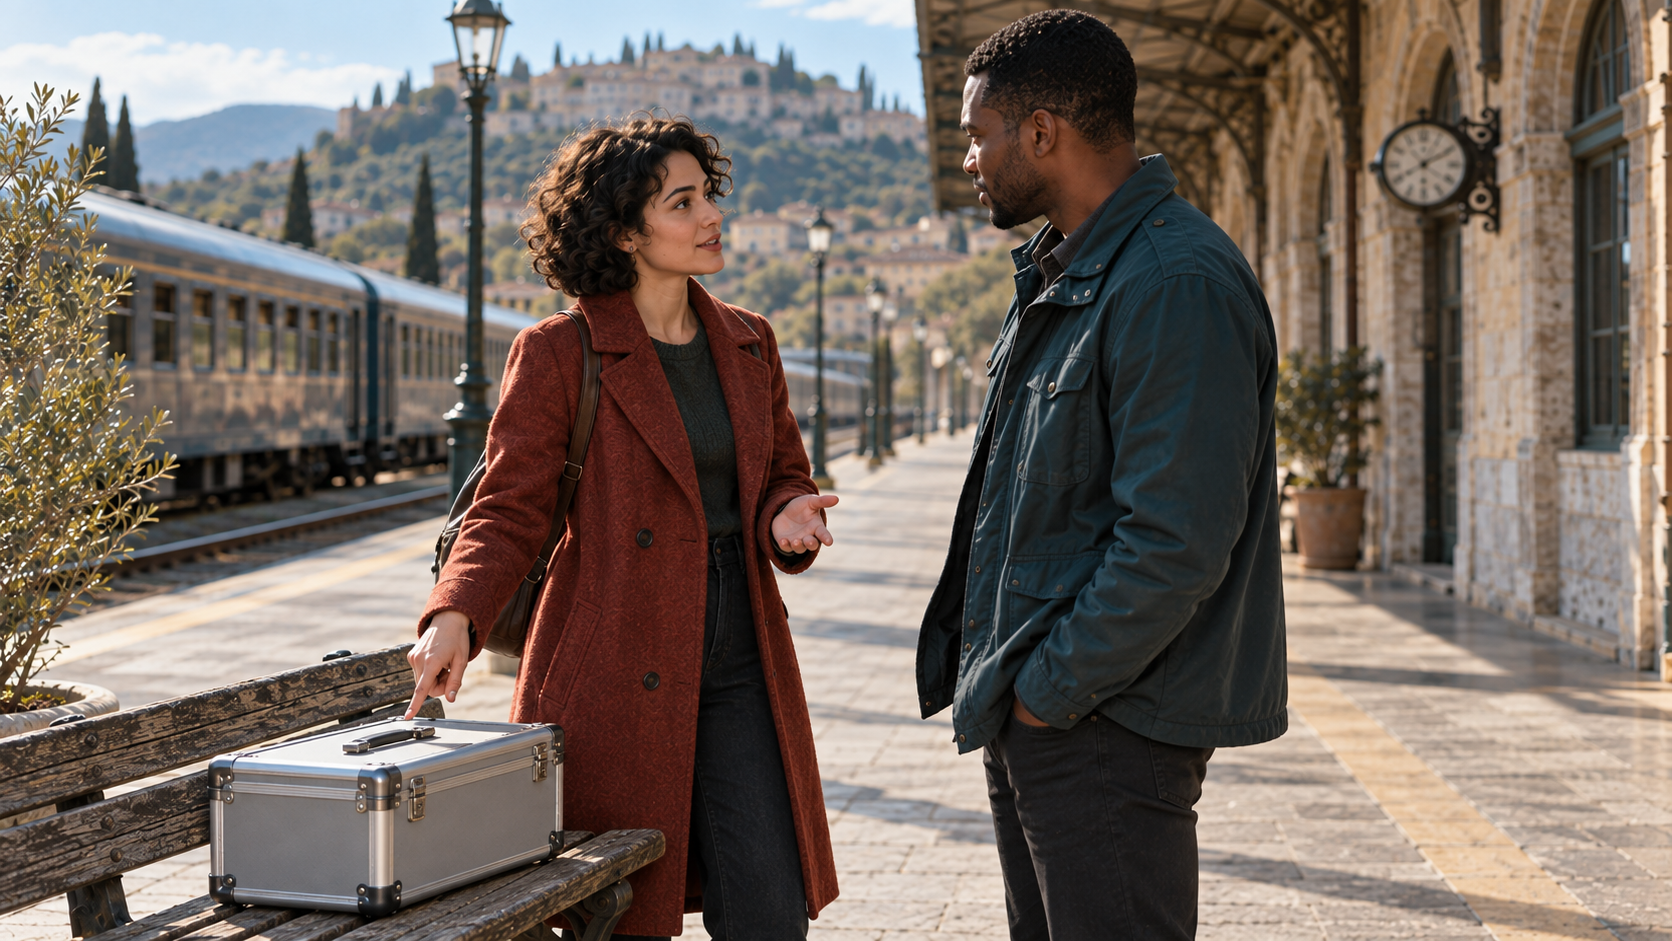
설명용으로 생성된 블로킹 프레임: 화자가 제스처를 담당하며, 청취자는 명확한 시선을 유지하고, 사례는 인계 전에 안정된 위치에 놓여 있다.
공간적 언어를 일관되게 유지하라. “화면 왼쪽(screen left)”과 “화면 오른쪽(screen right)”은 카메라 기준이다. 반면 “레일 근처(near the tracks)”나 “역 벽 근처(near the station wall)”는 역각(reverse angle) 변경에도 더 잘 견딘다. 컷(cut)으로 방향이 바뀔 경우, 다음 동작 이전에 두 사람의 위치와 자세를 다시 명확히 설정하라. 아크(arc), 줌(zoom), 팬(pan), 핸드헬드 흔들림(handheld shake)을 한 번에 결합하기보다는, 한 가지 카메라 움직임—예를 들어 쌍을 향해 천천히 밀어가는 액션—만 사용하라.
양측 인물이 서로를 가로질러 손을 뻗거나, 프롬프트가 접촉 단계(contact phase)를 건너뛰면 손동작이 실패한다. 사례는 두 사람이 명확히 잡을 수 있을 만큼 충분한 크기여야 하며, 어느 한쪽 신체도 상대방을 가로지르지 않도록 해야 한다. 인계 과정은 여러 초에 걸쳐 진행되어야 한다. 깔끔한 종료가 중요하다: 사례를 누가 소유하고 있는지, 각 인물이 어디에 서 있는지, 어디를 바라보고 있는지, 그리고 입이 움직이는지 여부를 명시해야 한다.
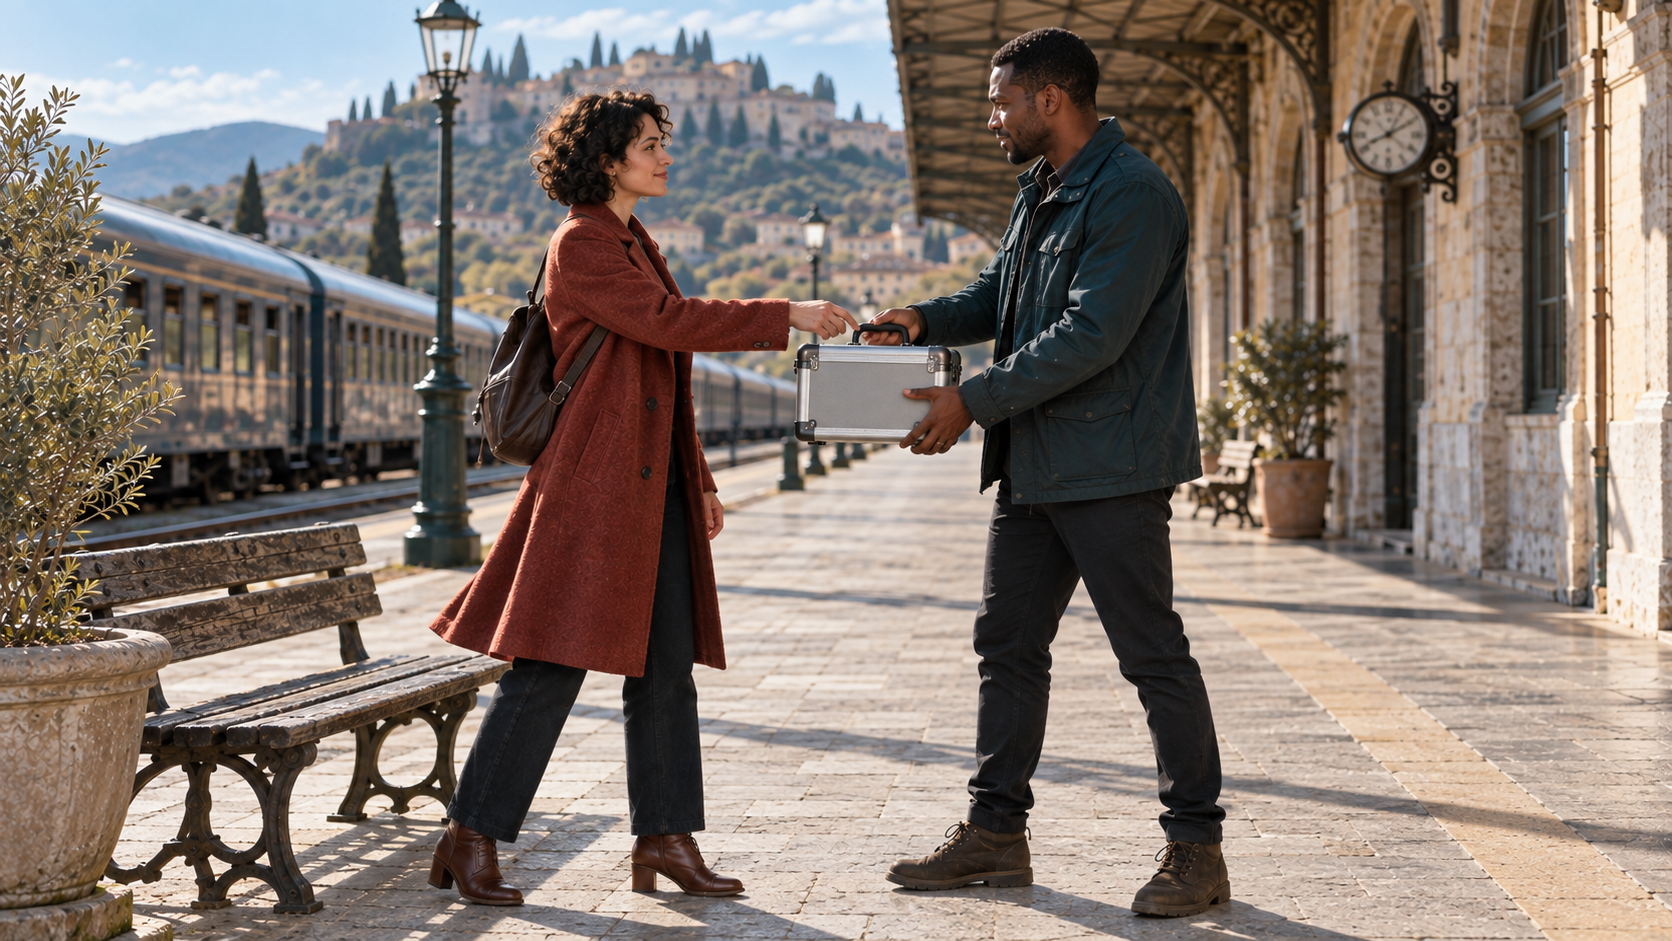
설명용으로 생성된 액션 프레임: 손 분리 상태, 소도구의 기하학적 배치, 코트의 연속성, 공유 접촉 시 추가 팔의 부재 등을 점검하라.
두 명의 화자 대화 및 음향 제어
모든 대사 라인과 모든 청취 리듬에 ID 할당
MiniMax의 공식 기본 가이드는 S1 및 S2과 같은 안정적인 화자 ID를 사용한다. 식별 문구, 화자 ID, 발화 방식, 액션은 대사 태그 외부에 배치하고, 태그 내부에는 언어 태그와 정확한 발화 내용만 포함시켜야 한다. 두 사람이 동시에 말할 경우, S1,S2과 같은 복합 ID를 지원하지만, 중첩 대사는 교차 대사보다 먼저 시도하기엔 더 어려운 테스트이다.
녹슬 듯한 붉은 코트를 입은 여성(S1)이 케이스를 바라보며 조용히 말한다: <d>[English] Keep this with you until the next stop.</d> Subject 2가 경청하며 입술은 닫혀 있다.
청록색 재킷을 입은 남성(S2)이 케이스를 받아 그녀의 시선을 마주치고 대답한다: <d>[English] I understand.</d> Subject 1가 경청하며 입술은 닫혀 있다.
화면에 보이는 샷에 맞는 짧은 대사를 사용하라. 발화가 언제 끝나는지, 턱이 언제 닫히는지, 청취자가 언제 반응하는지를 명시하라. 플랫폼 주변의 잡음, 발걸음 소리, 케이스 래치 클릭 소리, 옷감 움직임 등은 전체 사운드스케이프에 포함시키되, 이를 대사로 반복하지는 말라. 청중 전용 음악은 비-내재적 음악(non-diegetic music) 필드에 넣으라. 음성 오버레이(voiceover)가 화면 밖에서 나오는 경우, 반드시 ‘화면 밖 음성 오버레이(off-screen voiceover)’라고 명시하고, 화면에 보이는 인물의 입술은 닫힌 상태로 유지하라.
실제 Seedance 출력이며, MiniMax H3 결과가 아님: 더 어려운 두 사람 대화를 평가하기 전에, 입 모양, 타이밍, 공간 음향(room tone) 기준으로 통제된 단일 화자 클립을 사용하라.
여러 클립에 걸쳐 반복되는 음성의 경우, Seedance 음성 일관성 가이드를 참조하여 음색(timbre), 속도(pace), 음량(loudness), 공간 음향(room tone), 화자 간 분리도(speaker-to-speaker separation)를 검토하는 청취 절차를 수행할 수 있다.
3샷 연속성 계획 수립
모든 컷이 고정된 상태를 상속받도록 설계
많은 두 사람 장면에는 세 개의 짧은 샷만으로도 충분하다. 샷 1은 두 인물, 플랫폼, 초기 케이스 소유권을 설정한다. 샷 2는 인계 동작과 각 화자의 한 줄 대사를 위해 더 가까이서 촬영한다. 샷 3은 새로운 소도구 소유자를 확인하고, 두 인물에게 조용한 반응을 부여한다. 각 샷은 시작 상태, 액션, 카메라 동작, 음향, 고정된 종료 상태를 가져야 한다.
샷 1의 종료 상태는 샷 2의 시작 상태와 정확히 일치해야 한다. 컷 시점에 케이스가 벤치 위에 있다면, 눈에 보이는 집기 동작 없이 다음 프레임에서 즉시 Subject 2의 손에 나타날 수 없다. Subject 1이 레일 쪽에 서 있다면, 컷과 카메라 방향이 이를 설명하지 않는 한, 역 벽 쪽으로 그녀의 방향을 갑작스럽게 반전시켜서는 안 된다. MiniMax H3 다중 키프레임 워크플로우는 수직 스토리보드 콜라주처럼 다루지 않고, 마스터 타임라인에 순서화된 프레임을 할당하는 방법을 보여준다.
H3의 기본 가이드는 샷 1 이후 정확한 컷 타이밍을 허용한다. 그러나 이 기능은 도움이 될 때만 사용하고, 간격은 연속적으로 유지하라. 실용적인 12초 계획 예시는 0–4초를 설정 장면, 4–9초를 인계 장면, 9–12초를 종료 홀드 장면으로 나누는 것이다. 마지막 2초는 새 동작을 도입해서는 안 된다.
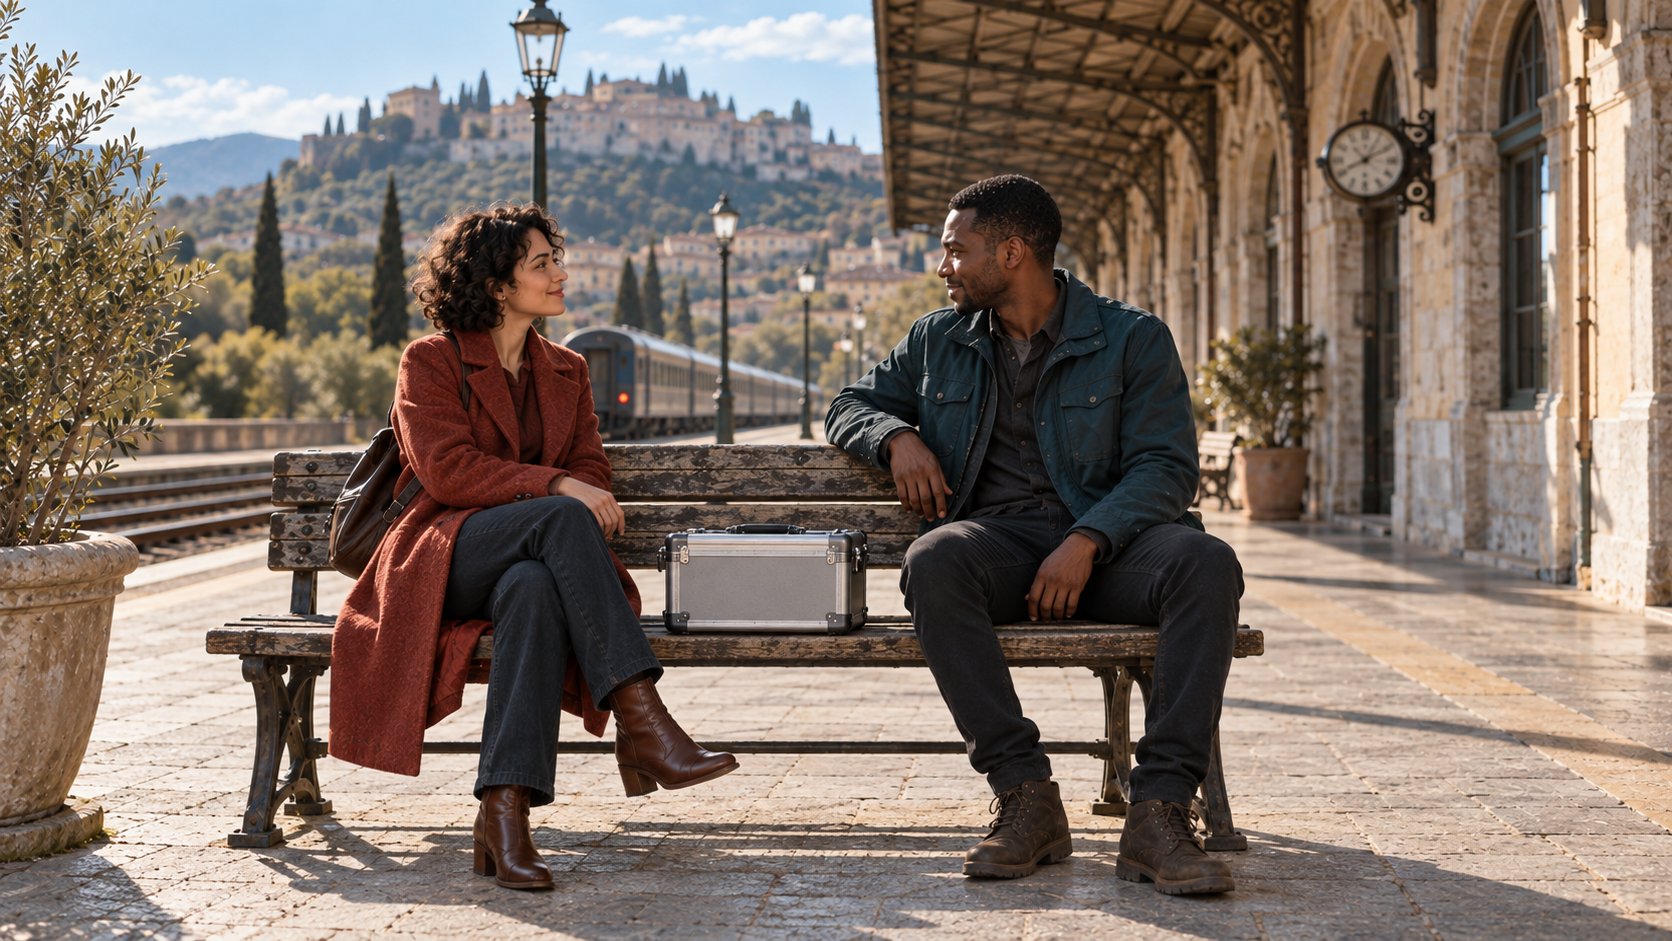
설명용으로 생성된 종료 프레임: 동일한 얼굴, 코트, 벤치, 역, 케이스, 조명으로 인해 연속성 편차가 쉽게 감지된다.
실패 사례 검토 및 최소 단위 재실행
각 시각적 실패 사례에 대해 하나의 프롬프트 변경만 적용
정상 속도로 전체 영상을 검토한 후, 인계 및 대화 부분은 절반 속도로 점검하라. 정체성이 바뀌는 경우, 주체-참조 매핑(subject-to-reference mapping)을 강화하고 컷을 단순화하라. 광각 샷에서 얼굴이 융합되는 경우, 주체 간 거리를 늘리거나, 대화를 중간 거리의 투샷(medium two-shot)으로 옮기라. 해당 문제에 대한 프레이밍 및 참조 선택은 원거리 얼굴 수정 가이드를 참조하라.| 실패 사례 | 가능성이 높은 원인 | 가장 작고 유용한 수정 | | --- | --- | --- | | 캐릭터들이 역할을 바꿈 | 비슷한 의상 또는 모호한 라벨 | 명확히 구분되는 라벨, 의상, 위치 및 화자 ID 복원 | | 두 사람의 입이 모두 움직임 | 청취자의 행동이 명시되지 않음 | 각 대사 뒤에 “청취하며, 입술은 닫힌 상태 유지” 추가 | | 여분의 팔이 등장함 | 인계 동작에서 접촉 상태가 생략됨 | 공유 지지 단계 및 해제 단계 확장 | | 소도구(prop)의 형태가 변함 | 너무 많은 동작 수행 또는 소도구 정의가 약함 | 크기, 손잡이, 마감 처리, 최종 소유자 고정 | | 컷 이후 시선 방향(eyeline)이 어긋남 | 위치가 재설정되지 않음 | 새 각도에서 양쪽의 위치와 시선 방향 모두 재명시 | | 환경이 초기화됨 | 장면 앵커(scene anchor)가 암시적임 | 플랫폼, 벤치, 기차, 조명 방향, 시간 반복 |
하나의 인계 프레임(failure)이 실패했기 때문에 전체 설정을 다시 생성하지 마십시오. 수락된 캐릭터 참조 자료, 프롬프트 버전, 시드(seed) 또는 작업 기록(가능할 경우), 출력 결과, 그리고 실패 기록을 저장하세요. 그런 다음 가장 작은 단위의 시도를 하나의 교정 변경만 적용하여 재실행합니다. Seedance Agent는 이러한 참조 자료들을 정리하고, 후보들을 비교하며, 승인 상태를 유지하고, 실패한 세그먼트만 참조-대-비디오 워크플로우로 전달할 수 있습니다.
결론
신뢰할 수 있는 MiniMax H3 2인 비디오 워크플로우는 적절한 입력 모드, 서로 분명히 구분되는 두 주체 기록, 안정적인 S1 및 S2 화자 ID, 하나의 인과적 상호작용, 명시적인 소도구 상태 변화, 그리고 다음 장면의 오프닝과 일치하는 종료 상태를 갖춘 컷 계획을 사용합니다. 정체성, 입 움직임 소유권, 손 동작, 시선 방향, 소도구 기하학적 특성, 환경, 음향을 각각 검토한 후, 실패한 비트(beat)만 재실행합니다. 참조 자료, 촬영 샷, 승인 기록, 타깃팅된 개정 사항을 함께 관리하려면, Seedance Agent를 사용해 2인 캐릭터 시퀀스를 구축하세요.
직접 해볼 준비가 되셨나요?
이 가이드의 단계를 Seedance에서 바로 적용해 프롬프트나 이미지를 몇 분 안에 완성도 높은 영상으로 바꿔보세요.
가입 시 무료 크레딧 제공. 요금제는 월 $20부터.
Socialive Catalyst 조기 액세스 가이드: 유용한 첫 번째 파일럿 준비하기
누구에게 Socialive Catalyst에 대한 액세스 권한이 부여되는지, 조기 베타에서 제공되는 기능은 무엇인지, 데모를 위해 어떤 사전 준비가 필요한지, 그리고 하나의 브랜디드 엔터프라이즈 비디오 워크플로를 테스트하는 방법을 알아보세요.
글 읽기
FramePack Torch CUDA 비활성화 문제: 올바른 환경 진단 및 해결
정확한 Python 런타임을 확인하고, CPU 전용 wheel을 교체하며, 드라이버 또는 RTX 호환성 문제를 처리하는 방식으로 Torch의 CUDA 지원이 없는 FramePack 문제를 해결하고, 해결이 성공했음을 입증합니다.
글 읽기
Google Vids 개인 아바타 튜토리얼: 녹화, 프롬프트 작성 및 문제 해결
Google Vids에서 개인 아바타를 생성하고, 얼굴 및 음성 캡처를 완료하며, 유용한 Gemini Omni 프롬프트를 작성하고, 접근 권한 누락 문제를 해결하며, 녹화를 관리합니다.
글 읽기