

AI Overview
MiniMax H3으로 하나의 연속적인 대화 아바타 영상을 만들 수 있나요?
가능하지만, 긴 결과물은 무제한 생성이 아닌, 여러 개의 승인된 클립으로 계획해야 합니다. H3는 4–15초 분량을 출력하므로, 대본을 자연스러운 휴지 구간에서 나누고, 동일한 얼굴, 음성, 프레이밍, 그리고 방음(Room Tone)을 공유하는 세그먼트들을 연결하세요.
모든 세그먼트에서 동일한 아바타 정체성을 유지하려면 어떻게 해야 하나요?
단일하고 깨끗한 정체성 참조 이미지를 사용하고, 동일한 시각적 특징을 반복하며, S1과 같은 안정적인 화자 ID를 할당하세요. 또한 각 이어지는 세그먼트는 승인된 중립 경계 프레임(예: 표정·자세·시선이 고정된 프레임)에서 시작해야 합니다. 대사와 최소한의 필요한 제스처만 변경하세요.
대화 아바타 클립 간 전환을 매끄럽게 보이게 하려면 무엇이 필요할까요?
각 세그먼트는 완전한 문장 끝에서 입을 닫은 상태, 안정된 시선, 가라앉은 손동작, 그리고 짧은 방음 테일(Room-tone tail)을 포함해 종료해야 합니다. 다음 세그먼트는 바로 그 동일한 상태에서 시작한 후, 자연스러운 휴지 또는 절제된 컷어웨이(Cutaway)로 전환 지점을 숨기세요.
입모양 싱크(Lip Sync)가 틀어지지 않도록 하려면 어떻게 해야 하나요?
각 발화 블록을 한 번의 호흡으로 충분히 소화할 수 있을 정도로 짧게 유지하세요. 정확한 대사는 <d> 태그 내부에 명시적으로 기재하고, 얼굴이나 카메라의 경쟁적 움직임은 피하세요. 세그먼트를 승인하기 전에 일반 재생 속도와 프레임 단위로 입 모양을 꼼꼼히 검토하세요.
연속 아바타를 짧고 승인된 세그먼트로 계획하기
호흡 단위의 클립으로 마스터 구성하기
MiniMax H3의 연속 대화 아바타 워크플로는 무한한 지속 시간을 요청하는 것이 아니라, 제작 계획입니다. 공식 H3 도구는 4초에서 15초 사이의 정수 지속 시간만 허용합니다. 이 상한선을 창의적 제약 조건으로 받아들이세요: 각 클립은 하나의 완전한 아이디어, 적절한 제스처, 깔끔한 종료 상태를 담아야 합니다. 예를 들어 45초 분량의 설명은 제한치까지 강제로 채운 3개 클립보다는, 10–13초 분량의 4개 세그먼트로 구성하는 것이 더 바람직합니다.
생성 전에 반드시 대본에 구분 표시를 해 두세요. 좋은 구분점은 문장 부호, 호흡, 또는 주제 전환을 따릅니다. 나쁜 구분점은 이름, 숫자, 감정적으로 연결된 어구를 갑작스럽게 끊는 경우입니다. 타이머를 사용해 각 세그먼트를 소리 내어 읽어 보고, 시작 시 안정화 시간과 종료 시 유지 시간으로 약 1초씩 확보하세요. 말하는 내용이 이미 전체 지속 시간을 차지한다면, 모델에게 서두르라고 요청하기보다는 문장을 간결하게 다듬으세요.
| 세그먼트 | 발화 역할 | 목표 동작 | 필수 종료 상태 |
|---|---|---|---|
| A | 주제 소개 | 작고 열린 손 제스처 | 입 닫힘, 손 내림 |
| B | 핵심 포인트 설명 | 제한된 검지 제스처 하나 | 동일한 시선, 책상 위 손 |
| C | 사례 제시 | 가벼운 끄덕임, 카메라 이동 없음 | 중립적 표정 및 방음 |
| D | 행동 유도(CTA) 전달 | 약간의 몸 기울임 후 안정 | 편집을 위한 2비트 유지 |
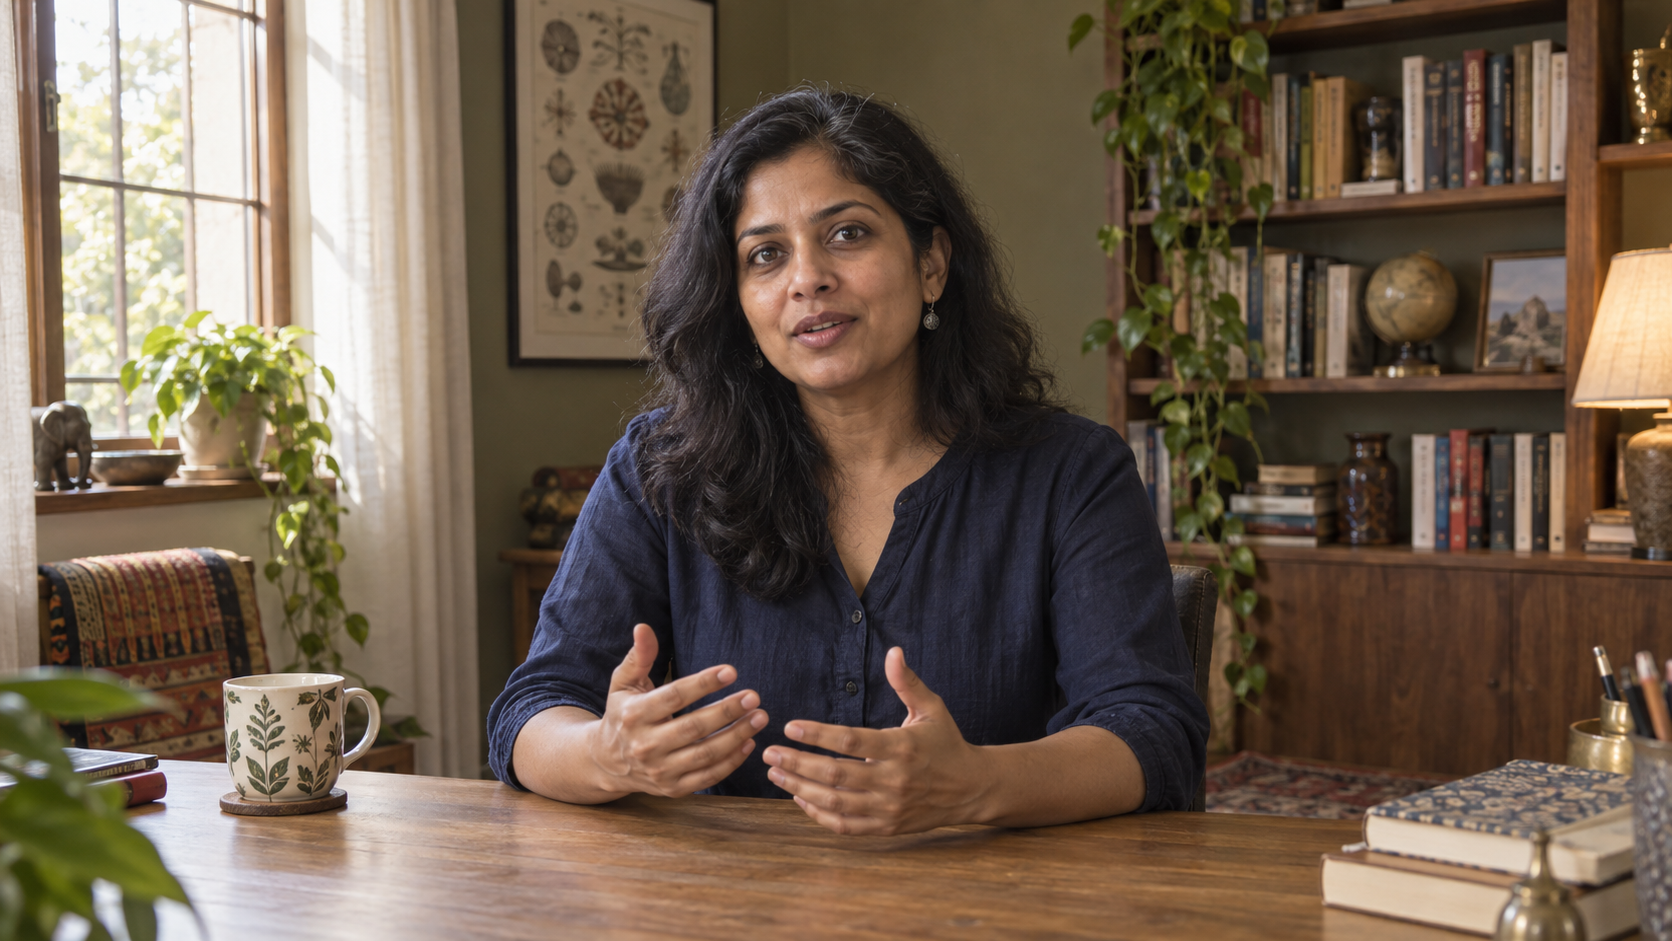
설명용 생성 스틸 이미지이며, MiniMax H3의 실제 결과물은 아님: 중간 프레이밍, 손의 가시성, 단순한 복장, 안정된 배경은, 극단적으로 가까운 뷰티 포트레이트보다 대화 시퀀스의 연속성을 더 설득력 있게 보여줍니다.
이런 세분화는 복구 비용도 낮춥니다. 예를 들어 세그먼트 C의 입 모양이 부족하다면, 다른 승인된 자료 전체를 위험에 빠뜨리지 않고 C만 재생성하면 됩니다. 재개 가능한 멀티샷 워크플로에서 적용되는 동일한 체크포인트 논리가 여기에도 적용됩니다: 모든 세그먼트에 대해 대본 버전, 참조 세트, 프롬프트, 출력물, 승인된 경계 프레임을 저장하세요.
얼굴, 음성, 대본, 프레임 준비하기
하나의 간결한 연속성 패킷 만들기
읽기 쉬운 얼굴, 편안한 입술, 복잡하지 않은 배경, 그리고 완성 영상에 필요한 동일한 카메라 각도를 갖춘 참조 이미지를 선택하세요. 와이드 샷보다는 미디엄 또는 미디엄 클로즈 프레이밍이 일반적으로 더 안전합니다. 왜냐하면 입 부분이 충분히 크게 남아 있어 검토가 용이하기 때문입니다. 머리카락이 입술을 가리지 않도록 하고, 손이 아래쪽 얼굴을 가로지르지 않도록 하며, 단단하고 움직이는 그림자 대신 부드러운 방향성 조명을 사용하세요.
고정된 정체성 블록을 작성하고, 단어 그대로 반복해서 사용하세요. 연령대, 머리스타일, 복장, 독특하지만 평범한 특징, 음성 질감, 말하기 속도, 중요할 경우에만 강세(Accent), 카메라 높이, 촬영 크기, 조명 방향, 배경 고정 요소 등을 포함하세요. 이후 세그먼트에서 새로운 형용사를 추가하지 마세요. 무해해 보이는 추가조차도 스타일링, 연령, 혹은 얼굴 비율을 바꿀 수 있습니다.
참조 기반 생성 시, H3는 이미지, 동영상, 오디오 자산을 모두 활용할 수 있습니다. 공식 전체 참조 가이드에서는 시각적 피사체, 구체적인 이미지 앵커, 소스 동영상, 오디오 참조를 구분합니다. 오디오 참조가 복사된 신호가 아니라 음색 및 전달 방식을 제공할 때는 이를 ‘음색 및 전달 방식 참조’로 명시하세요. 아바타가 실제로 말하는 모든 위치에서 동일한 화자 ID를 유지하세요.
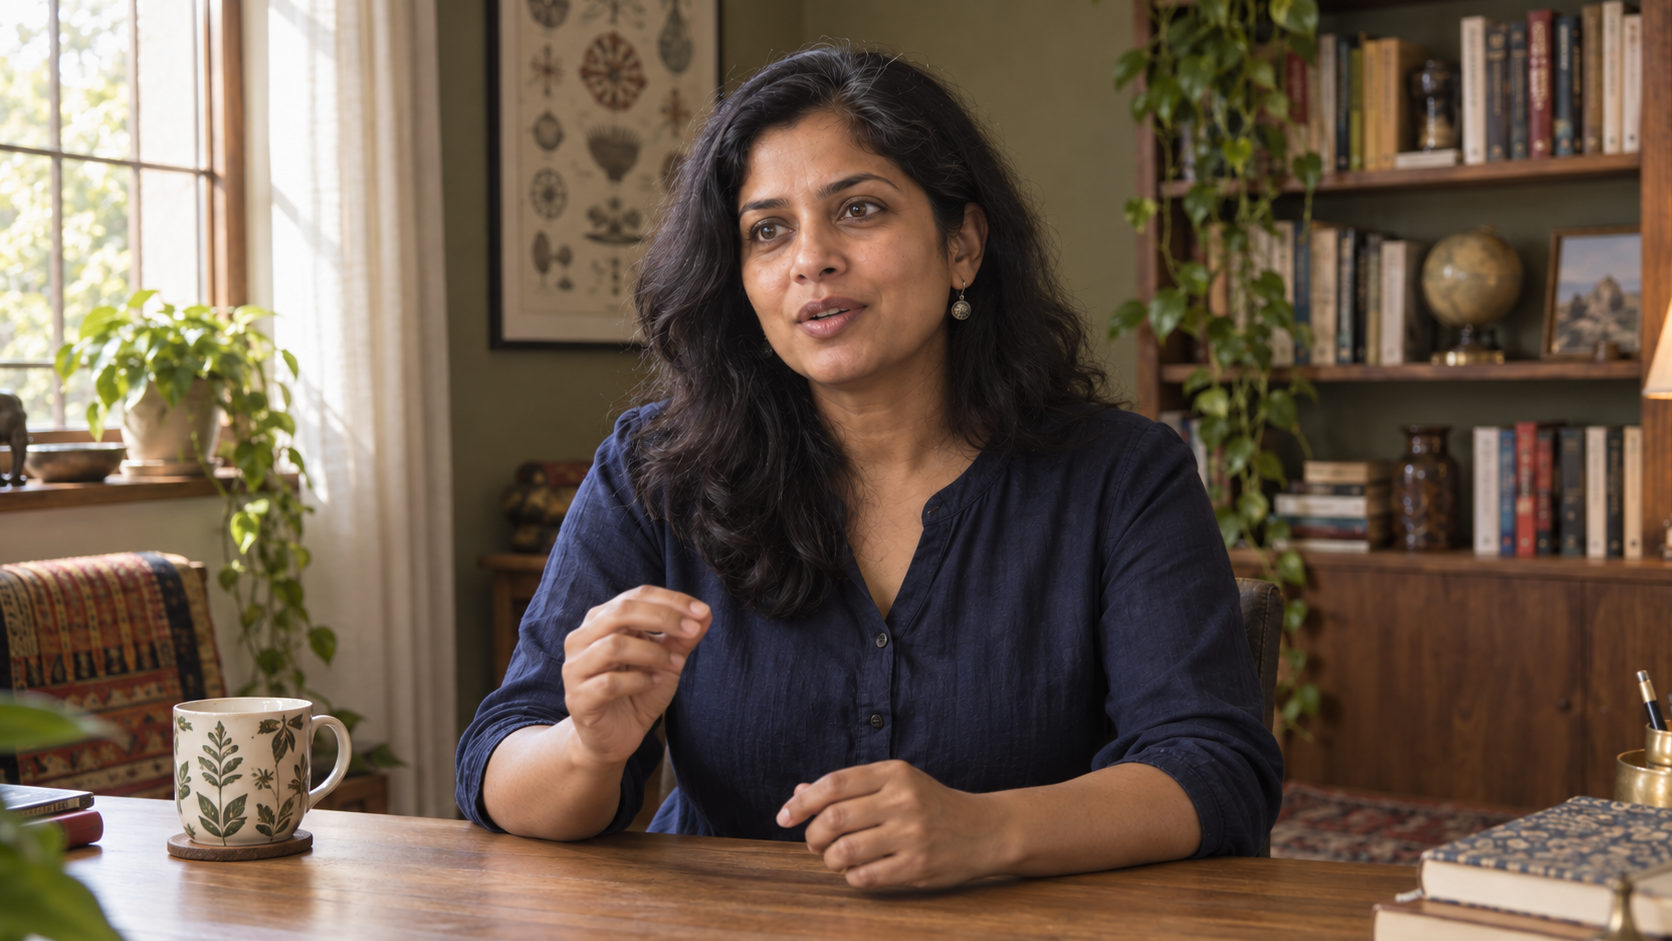
말하는 세그먼트를 위한 연속성 목표: 정체성, 렌즈, 시선, 복장, 조명은 고정된 채, 입 모양과 하나의 작은 제스처만 변화시킴.
특정 음성을 필요로 한다면 깨끗한 대화를 녹음하세요. 조용한 공간, 일관된 마이크 거리, 배경 음악 없음, 각 세그먼트별 별도 파일을 사용하세요. 생성 전에 음량과 방음을 맞추세요. 단지 타당한 원어민 음성을 원할 경우, 안정된 음색과 속도를 명시하되 여전히 정확한 대사를 프롬프트에 포함시키세요. 음성 일관성 가이드에 있는 유용한 청취 체크리스트는 H3 출력물을 검토할 때도 동일하게 적용됩니다.
화자 정체성을 잃지 않도록 H3 대사 작성하기
대화 태그 외부에 시각적 방향성 유지
공식 H3 기본 가이드는 (S1)와 같은 안정적인 화자 ID를 사용하며, <d> 태그 내부에는 말할 내용만 배치합니다. 정체성을 나타내는 문구, 동작, 발화 방식, 화자 ID는 모두 태그 외부에 남겨둡니다. 이러한 분리는 연출 지시사항이 실수로 대사로 인식되는 것을 방지합니다.
[샷 1] 같은 과학 교육자가 오크 책상에 앉아 있는 사실적인 중간 샷. 카메라, 렌즈, 조명 방향, 의복, 책, 식물, 컵은 모두 변경되지 않음. 차분한 성인 여성(S1), 따뜻하고 중저음의 목소리, 절제된 속도, 명확한 발음으로, 렌즈 바로 옆을 바라봄. 한 손을 살짝 펴는 제스처 하나를 하고 말함: <d>[English] A stable avatar begins with a stable handoff between every approved clip.</d> 문장 후 입술을 닫고, 손을 책상 위로 되돌려 놓으며, 동일한 시선을 1초간 유지함. 조용한 공간 음향이 계속됨. 음악 없음, 카메라 이동 없음, 텍스트 오버레이 없음.
새로운 생성 과정에서 S1의 정체가 잊혀질 수 있는 경우, 정체성을 나타내는 문구를 반복하세요. 다음 클립에서 동일한 아바타에 대해 새 화자 번호를 부여하지 마세요. 다른 음성이 등장할 경우, S2을 한 번만 할당하고 역할을 명시적으로 유지하세요. 단일 인물 해설 영상에서는 다른 청취 가능한 음성을 배제함으로써 불필요한 드리프트 원인을 제거합니다.
보이는 동작 하나당 하나의 말하기 절(clause)만 작성하세요. 빠른 머리 돌림, 큰 팔 움직임, 카메라 줌인, 긴 문장은 모두 짧은 시간 간격 내에서 경쟁합니다. 입 모양 정확도가 중요할 때는 카메라를 고정하고 상체를 가만히 두세요. H3 미세표정 프롬프트 가이드에 나온 실용적인 표정 제어 기능을 활용해, 전체 얼굴을 바꾸지 않고 눈썹을 살짝 들어 올리거나 고개를 끄덕이는 표현을 요청하세요.
각 컷 사이에서 앵커 상태(Anchor State) 유지
다음 시작을 요청하기 전에 깔끔하게 종료
하나의 클립 마지막 1초가 다음 클립의 시각적 약속이 됩니다. 고정된 종료 상태를 요청하세요: 입술을 닫고, 턱을 이완시키고, 동일한 시선 포인트를 유지하며, 손을 특정 위치에 두고, 어깨를 수평으로 하고, 배경 물체의 위치를 그대로 유지하세요. 생성 경로가 허용하는 경우, 승인된 이 종료 프레임을 다음 이미지 앵커로 내보내세요. 중립적인 정지 상태는 말 도중 캡처된 프레임보다 재사용성이 높습니다.
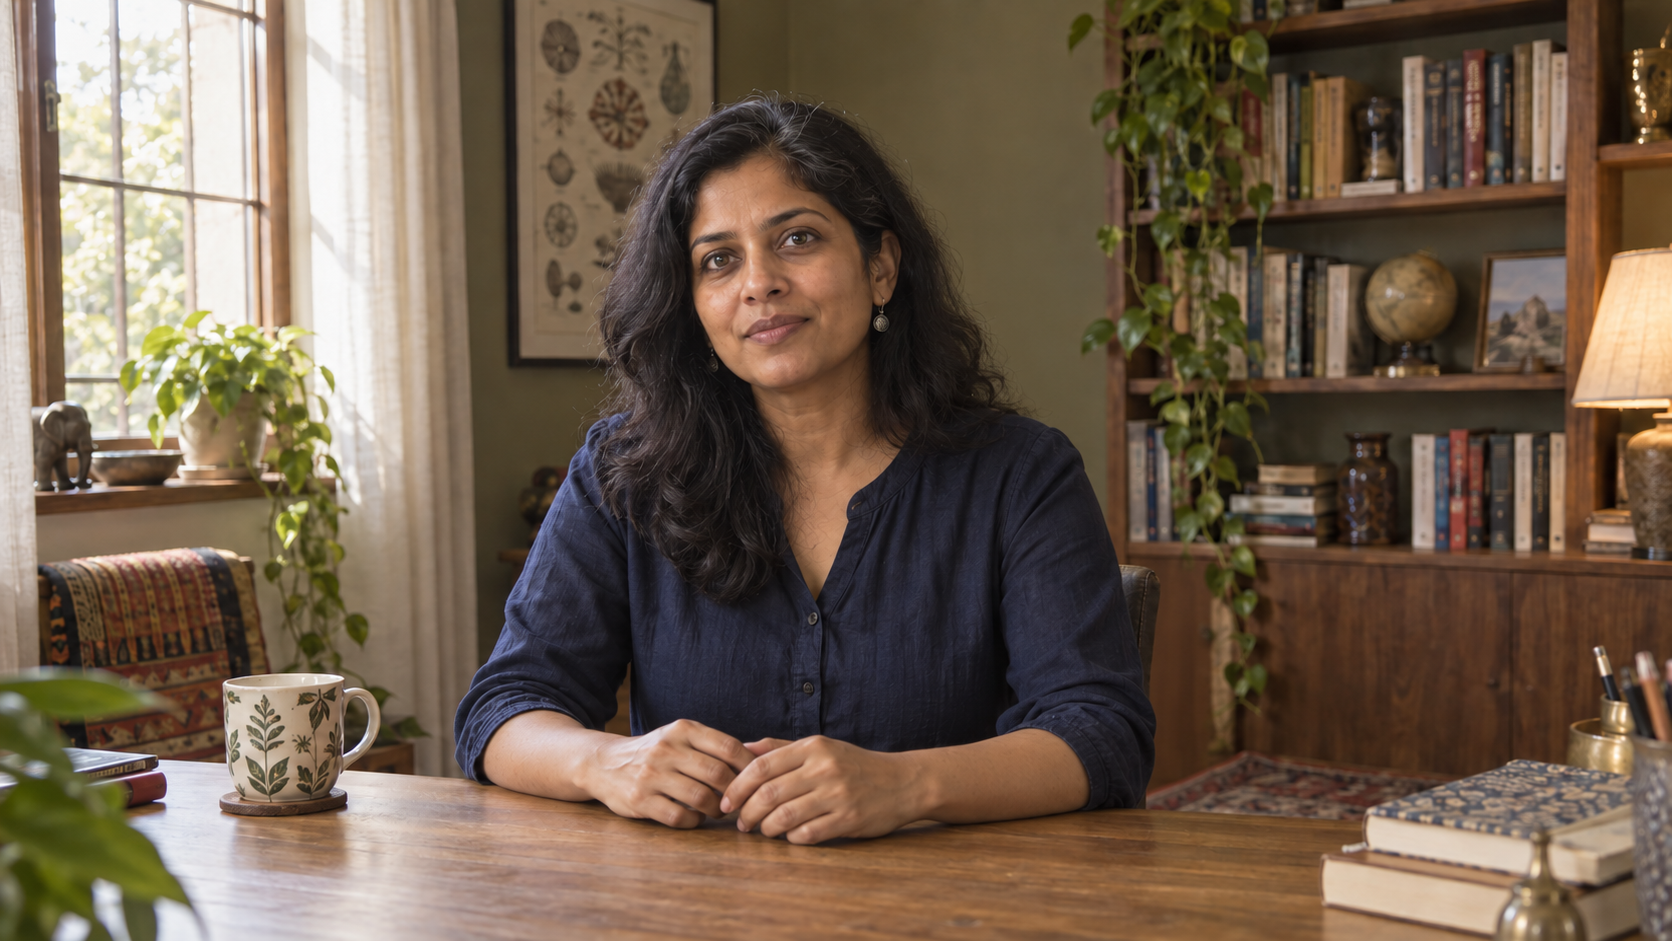
유용한 경계 프레임은 의도적으로 평범해야 합니다: 입은 닫혀 있고, 시선과 자세는 안정되어 있으며, 편집을 넘어 제스처가 마법처럼 이어질 필요가 없습니다.
세그먼트 B 시작 시, 새로운 동작 전에 고정된 상태를 다시 설명하세요. 머리 크기, 카메라 높이, 시선 높이, 조명 방향, 소매 위치, 고대비 배경 물체의 위치를 모두 보존하세요. 첫 번째 움직임은 짧은 안정 시간 후에 시작되어야 하며, 프레임 1부터 시작하면 안 됩니다. 다음 클립이 다른 자세로 열릴 경우, 관객은 말을 듣기 전에 점프를 먼저 인지하게 됩니다.
H3는 첫/마지막 프레임 모드 및 참조 모드를 지원하지만, 작업에 맞는 모드만 사용하세요. 구체적인 경계 이미지는 프레임 앵커입니다; 오디오 샘플은 음색을 안내할 수 있습니다; 이전 비디오는 동작 또는 이어짐 맥락을 제공할 수 있습니다. 더 많은 참조가 자동으로 더 나은 결과를 보장하지는 않습니다. 승인된 프레이밍, 의복, 음성과 모순되는 자산은 모두 제거하세요.
핸드오프 방법은 멀티 키프레임 계획과 밀접한 관련이 있지만, 말하는 아바타는 시각적 야망이 덜 필요합니다. 경계마다 하나의 안정적인 앵커를 두는 것이, 얼굴, 손, 카메라, 공간이 동시에 바뀌도록 요구하는 밀도 높은 스토리보드보다 일반적으로 낫습니다.
청각적·시각적 점프 없이 세그먼트 조합
일시 정지 지점에서 컷하고 공간 음향 유지
모든 승인된 클립을 스크립트 순서대로 하나의 타임라인 위에 배치하세요. 중복된 안정 프레임은 잘라내되, 입이 벌어진 순간에서 컷을 벗어나도록 충분한 중립적 소재는 남겨두세요. 전환 효과를 추가하기 전에 규모와 위치를 맞추세요. 자연스러운 일시 정지 시점에서의 직결(cut)은 일반적으로 디졸브(dissolve)보다 깔끔합니다. 디졸브는 잠시 두 개의 입을 동시에 보여주어 얼굴이 불안정해 보이게 만들 수 있습니다.
실제 Seedance 출력, MiniMax H3 결과가 아님: 이 네이티브 오디오 샘플을 음성 타이밍, 안면 움직임, 끊기지 않는 주변 음향의 검토 기준으로 사용하세요.
영상 없이 오디오만 들으며 연결 지점을 확인하세요. 대사 볼륨, 잡음 바닥(noise floor), 잔향(reverberation), 각 호흡의 길이를 맞추세요. 짧고 연속적인 공간 음향을 전체 시퀀스 아래에 깔아, 사소한 간격이 마치 공간 음향이 꺼진 것처럼 들리지 않도록 하세요. 음성 컷이 완성될 때까지 음악은 피하세요. 사운드트랙은 편집 중에 나쁜 연결을 숨길 수는 있지만, 이를 고칠 수는 없습니다.
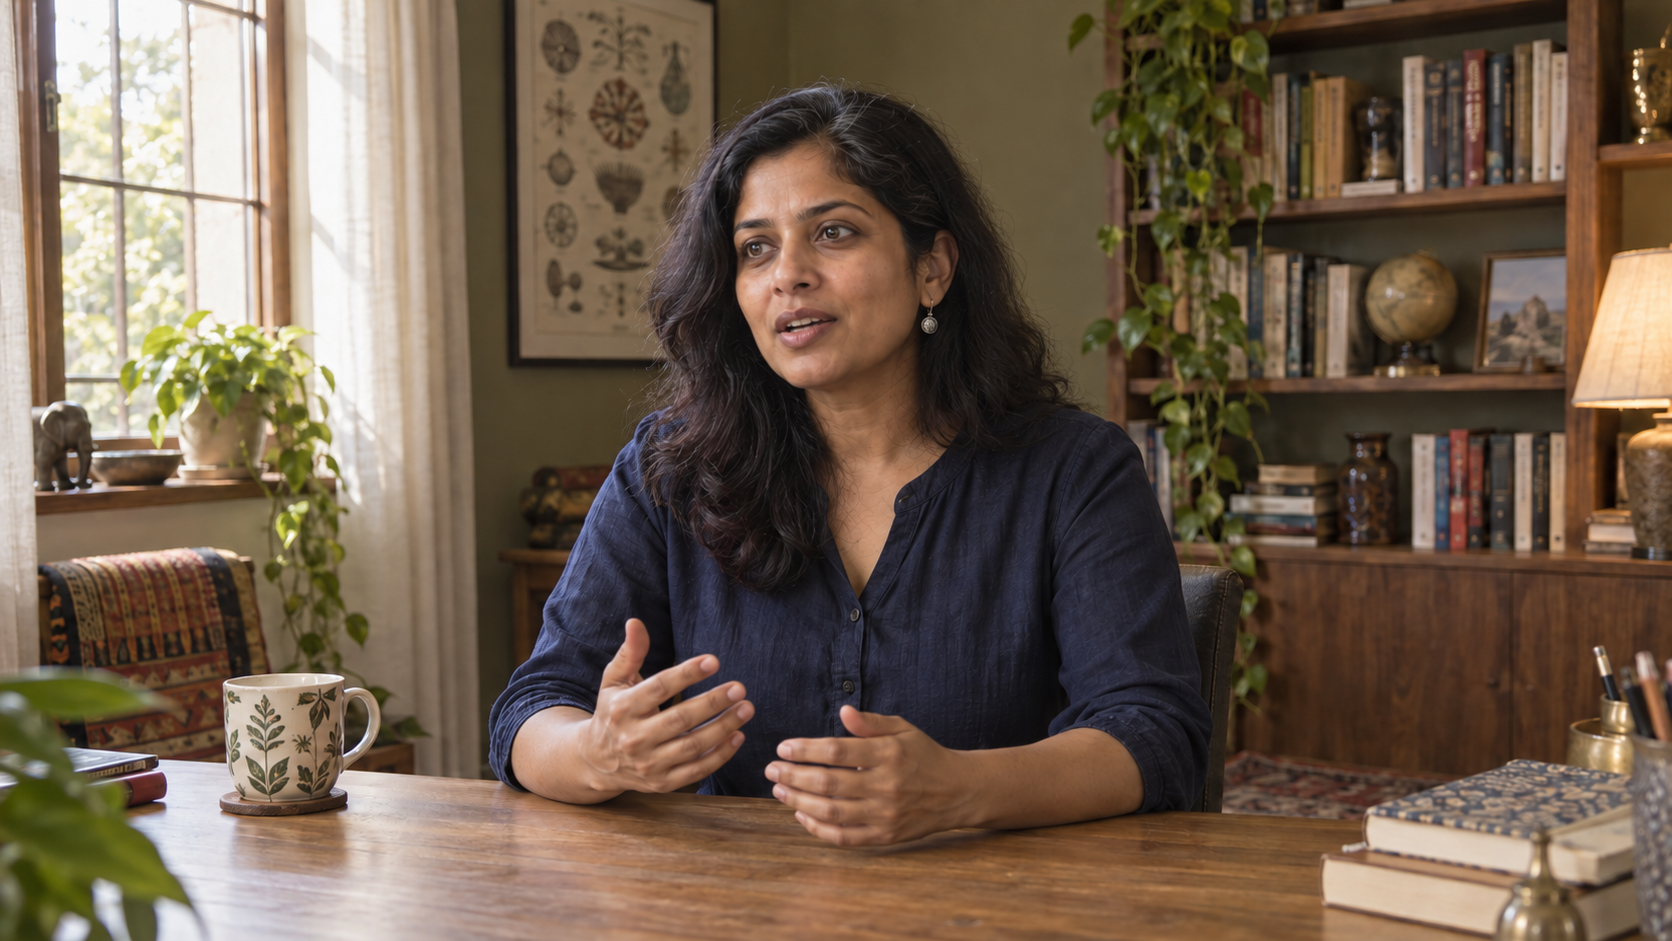
연속성 목표: 정체성과 시각적 앵커는 안정적으로 유지되며, 새 문장은 여전히 믿을 만한, 다만 약간 다른 손 제스처로 시작함.
여전히 점프가 남아 있다면, 관련 있는 컷어웨이(cutaway)를 1~2초 삽입하세요: 발표자의 노트북, 그녀가 언급한 물건, 혹은 동일한 방에서 촬영한 광각 뷰 등입니다. 무작위 스톡 영상을 삽입하지 마세요. 컷어웨이는 말한 문장을 답하거나 설명해야 하며, 이후 동일한 아바타 상태로 돌아와야 합니다.
입 모양 동기화, 음성, 연속성 실패 검토
다섯 가지 별도의 검토 단계를 통해 각 클립 승인
먼저, 의미와 자연스러운 리듬을 파악하기 위해 정상 속도로 영상을 한 번 시청합니다. 두 번째로, 오디오를 음소거한 채 신원, 치아, 입술, 턱, 눈, 손을 차례로 점검합니다. 세 번째로, 영상을 보지 않고 음성의 음색, 말속도, 공간 음향(room tone), 클릭 소리 등을 듣습니다. 네 번째로, 각 세그먼트의 시작 12 프레임과 종료 12 프레임을 프레임 단위로 검토합니다. 다섯 번째로, 휴대폰 크기의 플레이어에서 조립된 시퀀스 전체를 시청합니다. 이때 미세한 얼굴 변화가 더 뚜렷하게 느껴질 수 있습니다.
다음과 같은 경우 해당 클립을 거부합니다: 음성이 멈춘 후에도 입이 계속 움직이는 경우, 프레임 간 치아 형태가 변하는 경우, 턱이 옆으로 미끄러지는 경우, 눈동자 색상이 바뀌는 경우, 손이 얼굴을 가로지르는 경우, 음성이 갑작스럽게 나이나 거리 감각을 바꾸는 경우. 신원이 깨진 것을 선명도 강화(sharpening)로 복구해서는 안 됩니다. 마지막으로 승인된 앵커 지점부터 가장 작은 실패 세그먼트만 다시 실행합니다.
여러 실패 사례가 동일한 원인에서 비롯된 경우, 재생성을 시도하기 전에 먼저 간소화합니다. 대사 길이를 줄이고, 제스처를 제거하며, 카메라를 고정시키고, 화면 내 얼굴을 확대하거나, 모호한 참조(reference)를 대체합니다. 이 단계에서 Seedance Agent이 유용한 이유는 참조 패킷(reference packet), 세그먼트 프롬프트, 실제 출력물, 메모, 그리고 승인된 재실행 지점을 모두 함께 관리할 수 있기 때문입니다. 산발적으로 저장된 파일들로부터 프로젝트를 다시 구축하는 대신, H3 결과를 통제된 참조-비디오 워크플로우(reference-to-video)와 비교할 수 있습니다.
결론
신뢰할 수 있는 MiniMax H3 연속 대화 아바타는 짧고 검토 가능한 음성 세그먼트들을 조합하여 제작됩니다. 즉, 대본을 시간 기반으로 분할하고, 하나의 신원과 S1 음성 정의를 유지하며, 정확한 단어를 <d> 태그 안에 배치하고, 모든 클립을 중립적인 앵커 포인트에서 종료한 후, 승인된 테이크들을 연속적인 공간 음향(room tone) 위에 연결합니다. 이 방법은 무한 생성을 보장하지는 않지만, 얼굴, 음성, 입모양 동기화(lip sync)를 희생하지 않으면서도 더 긴 설명을 구축할 수 있는 복구 가능한 방식을 제공합니다. 참조 자료, 프롬프트, 출력물, 승인 절차 및 선택적 재실행을 하나의 제작 과정에서 계획하려면, Seedance Agent을 사용해 대화형 아바타 프로젝트를 시작하세요.
title: How to Assemble a Reliable Talking Avatar description: A five-step review method and failure-handling protocol for building continuous talking avatars from short speech segments. tags:
- avatar
- lip sync
- video generation
- quality control
- Seedance Agent
직접 해볼 준비가 되셨나요?
이 가이드의 단계를 Seedance에서 바로 적용해 프롬프트나 이미지를 몇 분 안에 완성도 높은 영상으로 바꿔보세요.
가입 시 무료 크레딧 제공. 요금제는 월 $20부터.
MiniMax H3 카메라 초점 거리 제어: 광각, 표준, 망원 룩
촬영 크기, 카메라 거리, 줌 언어, 기준 프레임 및 반복 가능한 24mm~85mm 프롬프트 테스트를 사용하여 MiniMax H3에서 시각적으로 인식되는 렌즈 룩을 제어합니다.
글 읽기
MiniMax H3 두 사람 영상 워크플로우: 역할, 대사, 동작을 명확히 유지
안정적인 주체 라벨링, 가독성 있는 배치(Blocking), 할당된 대사, 깔끔한 소도구 전달, 실용적인 오류 점검 워크플로우를 갖춘 MiniMax H3 두 사람 장면을 구축합니다.
글 읽기
Socialive Catalyst 조기 액세스 가이드: 유용한 첫 번째 파일럿 준비하기
누구에게 Socialive Catalyst에 대한 액세스 권한이 부여되는지, 조기 베타에서 제공되는 기능은 무엇인지, 데모를 위해 어떤 사전 준비가 필요한지, 그리고 하나의 브랜디드 엔터프라이즈 비디오 워크플로를 테스트하는 방법을 알아보세요.
글 읽기